
Data Vault 2.0 ist ein von Dan Linstedt entwickeltes Konzept für das Data Warehousing. Es bringt viele neue Features mit sich, die allen Fachkräften im Bereich Business Intelligence den Einstieg in ein neues Zeitalter des Data Warehousing ermöglichen. Data Vault 2.0 ist ein Big-Data-Konzept, das relationales Data Warehousing mit unstrukturiertem Data Warehousing in Echtzeit vereint. Es handelt sich um ein erweiterbares Datenmodell, dem sich neue Datenquellen mühelos hinzufügen lassen. Als unsere Gründer ihr Fachbuch verfassten, benötigten sie einen visuellen Ansatz, um die Konzepte von Data Vault anschaulich zu modellieren. Zu diesem Zweck entwickelten sie eine grafische Modellierungssprache, die sich auf die logischen Aspekte von Data Vault konzentriert. Die Microsoft-Visio-Stencils und ein detailliertes Whitepaper stehen auf www.visualdatavault.com als kostenloser Download zur Verfügung.
In diesem Jahr haben wir bereits über die Modellierung von Hubs und Links in Data Vault 2.0 berichtet. Nun möchten wir Ihnen die dritte Standard-Entität vorstellen: den Satellite.
SATELLITES IN VISUAL DATA VAULT
Satellites reichern Hubs und Links mit beschreibenden Daten an. Diese beschreibenden Daten werden in Attributen gespeichert, die dem Satellite zugeordnet sind. Die einzelnen Attribute werden dem Satellite schrittweise hinzugefügt. Ein Satellite kann an jeden beliebigen Hub oder Link angehängt werden, allerdings immer nur an genau ein übergeordnetes Parent-Element.
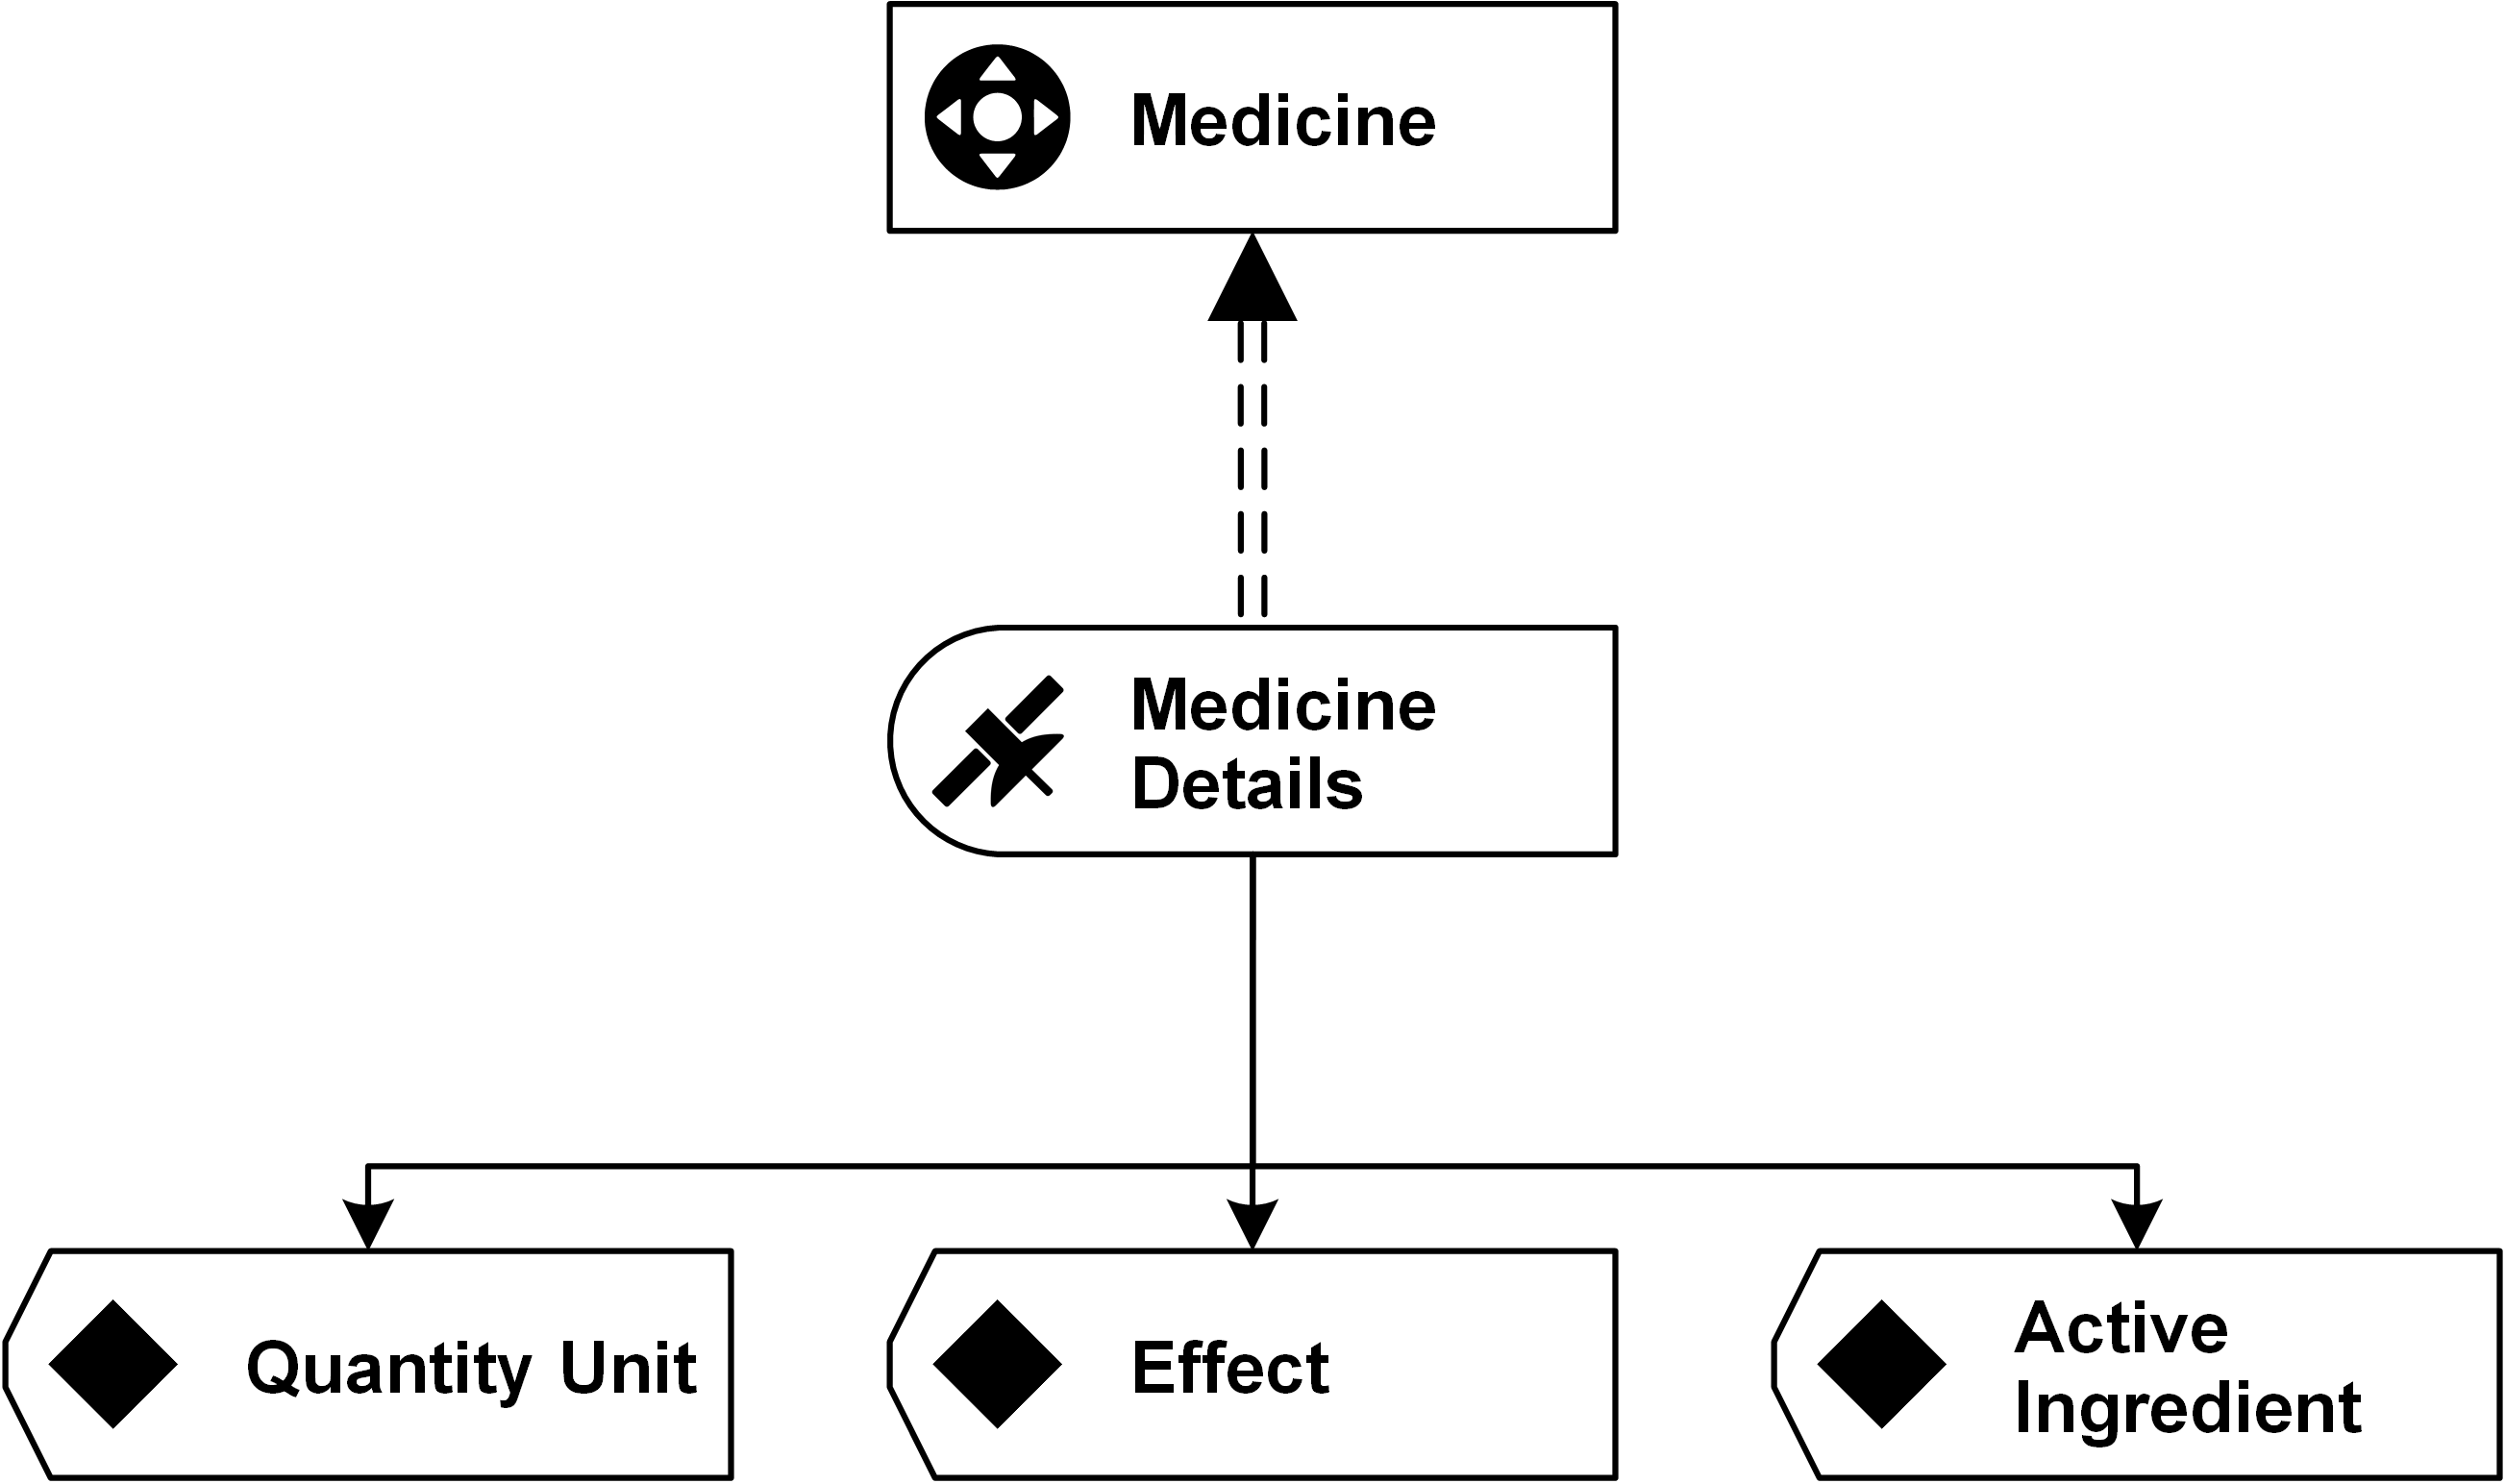
Die Beziehung zwischen dem Satellite und dem Hub lässt sich durch die Aussage „(Satellite) Medicine Details hängt von (Hub) Medicine ab“ beschreiben.
Zudem ist es möglich, einem Parent-Element mehrere Satellites zuzuordnen.

Die Anzahl der Satellites, die ein Hub oder Link besitzen kann, ist unbegrenzt. Abbildung 2 verdeutlicht zudem, dass Satellites bei der Darstellung in einem Übersichtsdiagramm die zugehörigen Attribute nicht zwingend anzeigen müssen. Es empfiehlt sich, die Rohdaten zunächst nach Quellsystem und anschließend nach der Änderungshäufigkeit (Rate of Change) zu unterteilen. Die Aufteilung nach Quellsystemen folgt einem datengetriebenen Ansatz, wodurch ein Re-Engineering bei der Anbindung neuer Datenquellen vermieden und eine nahezu 100-prozentige Automatisierung für den Raw Vault ermöglicht wird.
Sobald die Daten nach Quellsystemen strukturiert sind, gilt es als Best Practice, sie weiter nach ihrer Änderungshäufigkeit zu unterteilen. Stellen Sie sich einen Satellite vor, der Patienteninformationen enthält: Eine Reihe von Attributen ändert sich selten oder nie, wie beispielsweise der Name oder die Blutgruppe. Andere Attribute ändern sich hingegen deutlich häufiger, wie etwa die Gesamtzahl der Krankenhausaufenthalte.
Selbst wenn Satellites bereits nach Quellsystemen gegliedert sind, bleibt ein Record-Source-Attribut unverzichtbar. Dieses Attribut dient dazu, die Datenquelle geografisch oder anhand der jeweiligen Anwendung eindeutig zu identifizieren. So könnte die Quelle beispielsweise ein SAP-System sein, das auf mehrere physische Server verteilt ist. Je nach den Anforderungen des Data Warehouse erfassen wir die jeweilige physische Maschine im Record-Source-Attribut.
Neben den Attributen für die beschreibenden Daten sind in einem Satellite folgende Metadatenfelder erforderlich:
- Load date
- Record source
- Parent hash key
- (Load end date)
Folgende Attribute sind für Data Vault Satellites optional:
- Extract date
- Hash difference
Das Hash-Difference-Attribut ähnelt dem Hash Key in einem Data Vault Link: Es bildet einen Hash-Wert über alle beschreibenden Daten eines Satellite-Eintrags. Dieser Hash-Wert ermöglicht es Ihnen, Datensatzwerte schnell und effizient zu vergleichen. Die Hash Difference unterstützt Sie dabei, Änderungen in beschreibenden Attributen unmittelbar zu erkennen und neue Satellite-Einträge nur dann zu schreiben, wenn tatsächlich eine inhaltliche Änderung vorliegt. Zu Hash Keys und Hash Diffs haben wir bereits im April einen ausführlichen Newsletter veröffentlicht, den Sie hier nachlesen können.