
Der vorangegangene Artikel unserer Reihe behandelte die Data-Vault-Hub-Entität, die verwendet wird, um eine eindeutige Liste von Business Keys in einem Enterprise Data Warehouse zu erfassen, da der Großteil der Integration direkt auf diesen Hub-Entitäten stattfindet. Es gibt jedoch Szenarien, in denen die Datenintegration ausschließlich auf Basis dieser Hub-Entitäten für das angestrebte Ziel nicht ausreicht.
Betrachten Sie dazu das Beispiel des Datensatzes einer Versicherungsgesellschaft, bei dem Kunden jeweils Kfz- und Wohngebäudeversicherungen abschließen sowie Schadensfälle melden. Bevor wir mit dem Beispiel fortfahren, ist ein wesentlicher Aspekt zu beachten: Zwischen den beteiligten Business Keys bestehen Beziehungen, nämlich zwischen der Kundennummer, den Policen-Identifikatoren und den Schadensfällen.
Diese Beziehungen werden von Data-Vault-Link-Entitäten erfasst. Genau wie Hubs enthalten sie eine eindeutige Liste von Datensätzen und weisen somit in Bezug auf die gespeicherten Daten keine Duplikate auf. Beide bilden das Grundgerüst von Data Vault und werden später durch beschreibende Daten ergänzt, die in Satellites gespeichert sind
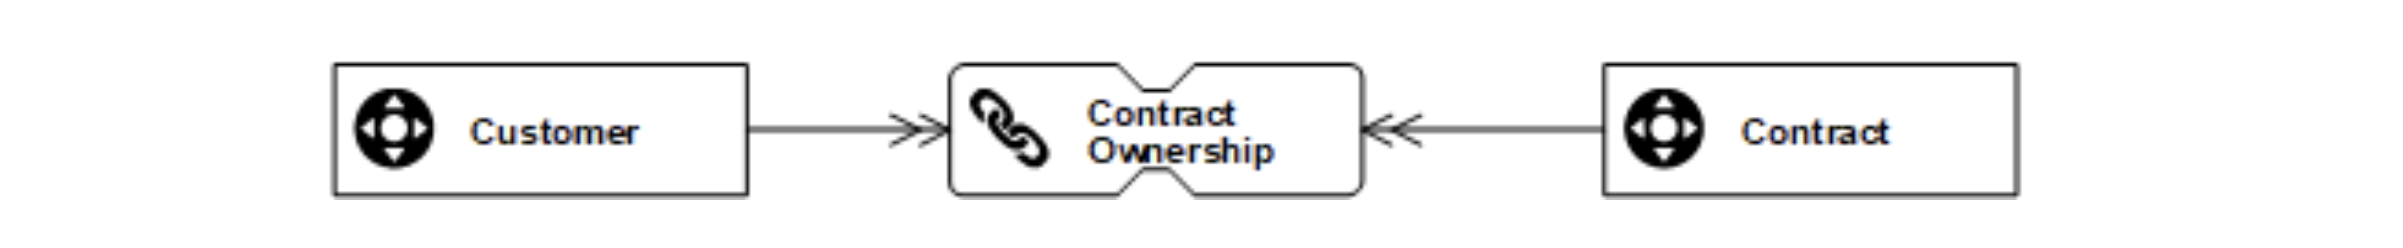
Ein Link bildet somit die Beziehung ab, indem er alle Hubs referenziert, die die an der Beziehung beteiligten Business Keys speichern. Zur Veranschaulichung zeigt das folgende Visual-Data-Vault-Diagramm eine solche Beziehung, wie sie in einem Link implementiert ist:
In MongoDB wird eine Link-Entität in einer Document-Collection umgesetzt, genau wie die Hub-Entität, die im letzten Artikel wie folgt beschrieben wurde:

Demnach enthält die Link-Struktur folgende Elemente, die die Beziehung beschreiben:
- Das _id–Element identifiziert das Link-Dokument. Anstatt sich auf den internen MongoDB-Identifikator zu verlassen, wird ein Hashwert berechnet – beispielsweise ein MD5-Wert, um den Link-Eintrag auch über die MongoDB-Datenbank hinaus eindeutig zu identifizieren.
- Das Feld ldts (Load Date Timestamp) gibt an, wann der Link-Eintrag zum ersten Mal vom Enterprise Data Warehouse erfasst wurde.
- Das rsrc–Element gibt die Quelle an, aus der der Link-Eintrag stammt.
- Die identifizierenden Hash Keys der referenzierten Hub-Dokumente sind in _ref enthalten.
Beim Ladeprozess der Link-Document-Collection besteht der erste Schritt darin, die Beziehungen in der Quell-Collection zu identifizieren. Sobald diese Beziehungen ermittelt sind, werden sie über den folgenden Prozess in die Link-Document-Collection geladen:
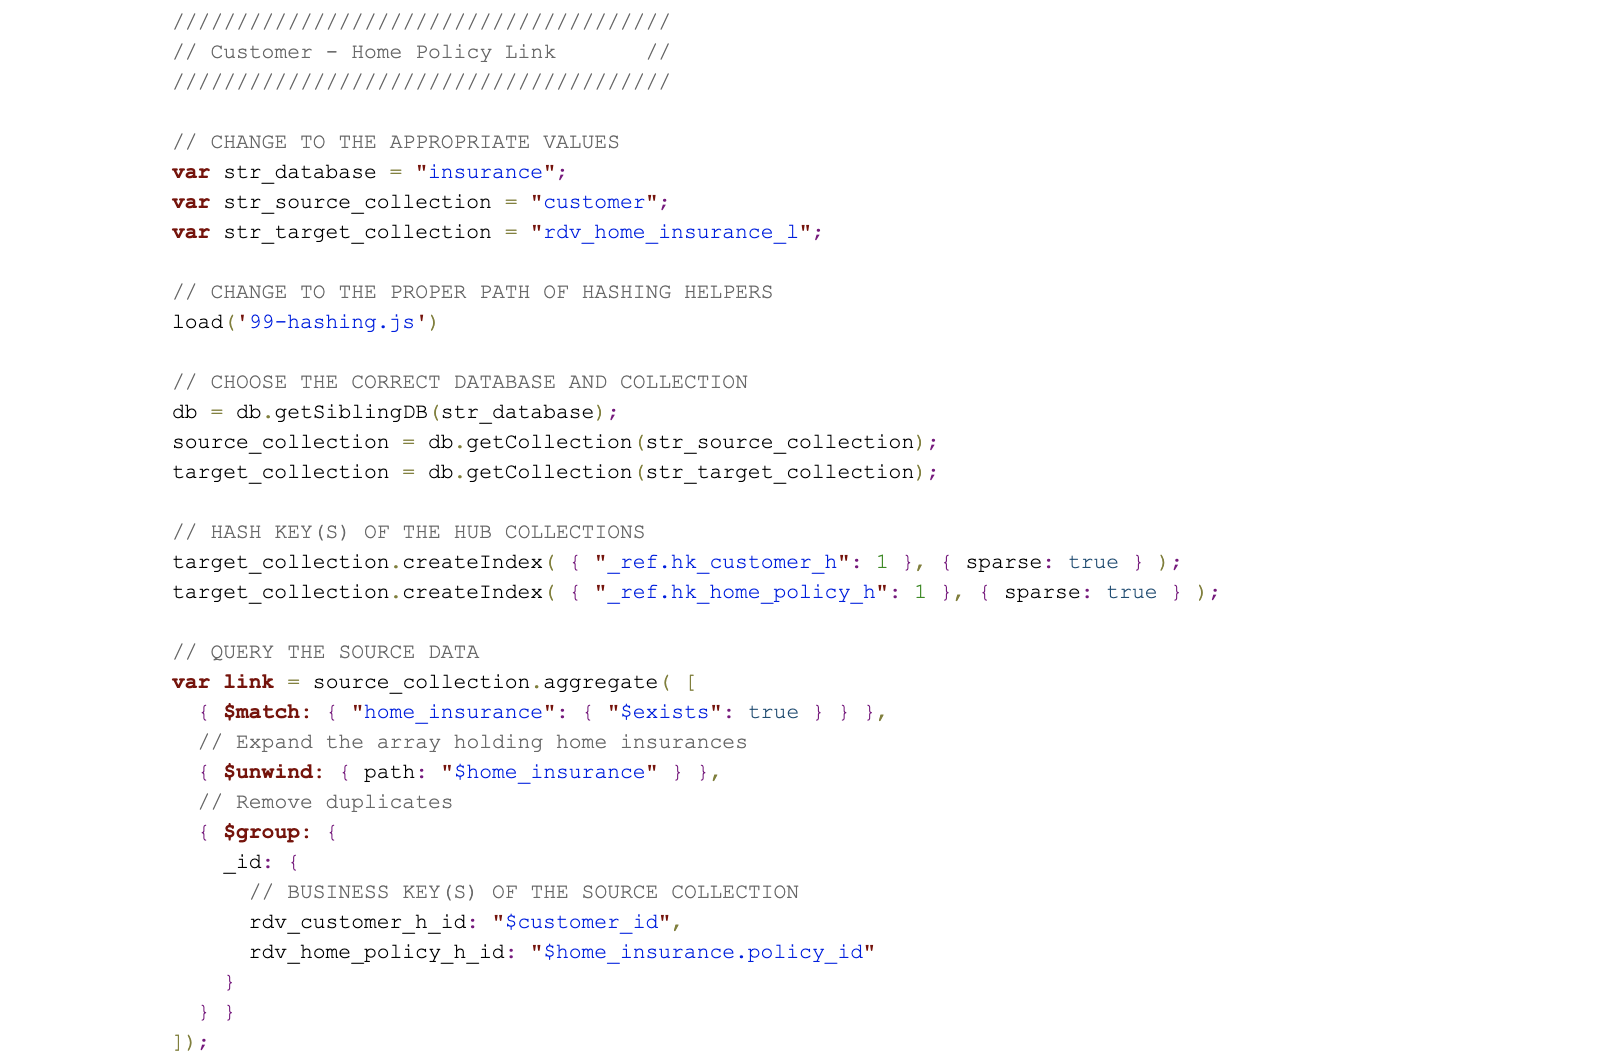
In MongoDB wird dieser Prozess mithilfe von Aggregation-Pipelines realisiert, wie in einem früheren Artikel dieser Reihe beschrieben. Der Code filtert zunächst über $match nach den Kunden, die über eine Wohngebäudeversicherung verfügen. Anschließend löst die $unwind–Stage das Array der Wohngebäudeversicherungen auf, sodass ein Array mit mehreren Werten in einzelne Dokumente umgewandelt wird. Eventuelle Duplikate werden danach über $group bereinigt.
Der folgende Codeausschnitt zeigt die erforderlichen Schritte, um eine Link-Document-Collection im Zuge des beschriebenen Datenflusses aus einer Quell-Collection zu befüllen. Er kann in der MongoDB Shell ausgeführt werden und nutzt die bereits im vorherigen Artikel vorgestellte Hashing-Funktion.
Bitte beachten Sie, dass es Variationen dieser Link-Struktur gibt: beispielsweise zur Erfassung von Transaktionen in Form eines Non-Historized Links oder für Einzelpositionen aus Rechnungen und Bestellungen in Form eines Degenerated Links. Um diesen Punkt zu verdeutlichen, lohnt sich ein Blick auf Schadensfälle, da diese oft keine eindeutigen Business Keys besitzen. Während der Link die erste Transaktion – etwa eine Schadensmeldung – erfasst, würde er nachfolgende Schadensfälle derselben Police ignorieren. Das liegt daran, dass der Link eine eindeutige Liste von Beziehungen zwischen Business Keys darstellt: Sobald er die Beziehung zwischen dem Kunden und der zugehörigen Wohngebäudeversicherungspolice einmal erfasst hat, lädt er nachfolgende Transaktionen nicht mehr.
Dies führt zu Problemen bei der Bereitstellung transaktionsbasierter Fact-Entitäten
Da die meisten Anwender typischerweise einen Fact-Datensatz pro Transaktion erwarten. Um dies zu gewährleisten, muss das beschriebene Link-Muster so angepasst werden, dass mehrere Transaktionen mit denselben Referenzen auf Hub-Dokumente geladen werden können.
Dies lässt sich erreichen, indem das Link-Dokument um zusätzliche Elemente erweitert wird. Die Dokumenten-ID wird in diesem Fall nicht mehr allein aus den referenzierten Business Keys berechnet, sondern schließt die zusätzlichen Attribute mit ein. Dieser Ansatz sorgt für eine eindeutige Dokumenten-ID pro Transaktion oder Ereignis.
Wir werden diese speziellen Link-Entitäten und weiterführende Details dazu in einem der nächsten Beiträge ausführlich behandeln.
Dieser Beitrag basiert auf einem laufenden gemeinsamen Projekt von Scalefree und MongoDB mit dem Ziel, Abfragen für sehr große Datenmengen optimal auszulegen.
Aus diesem Grund aktualisieren und erweitern wir diese Artikelserie kontinuierlich.
Setzen Sie am besten direkt ein Lesezeichen für diesen Beitrag, um künftige Updates nicht zu verpassen.
Haben Sie Fragen oder Anmerkungen?
Wir freuen uns auf Ihr Feedback im Kommentarbereich!