All Posts By

Michael Olschimke

Michael Olschimke is the Co-Founder and CEO of Scalefree and a "Data Vault 2.0 Pioneer" with over 20 years of IT experience. A Fulbright scholar and co-author of Building a Scalable Data Warehouse with Data Vault 2.0, Michael is a global authority on AI, Big Data, and scalable Lakehouse design across sectors like banking, automotive, and state security.

Unit of Work im Data Vault

Was ist die Unit of Work?

Die Unit of Work ist ein grundlegendes Konzept bei der Data-Vault-Modellierung. Sie beschreibt das Prinzip, alle zusammenhängenden Business Keys aus einem Quellsystem gemeinsam in einer einzigen Link-Struktur zu erfassen. Dadurch wird sichergestellt, dass die in den Rohdaten abgebildeten Beziehungen in Ihrem Raw Data Vault vollständig und unverfälscht erhalten bleiben.

Stellen Sie es sich wie ein Puzzle vor, bei dem alle Teile zusammengehören: Wenn Sie die Teile ohne eine klare Strategie für das spätere Zusammensetzen voneinander trennen, riskieren Sie, das ursprüngliche Gesamtbild zu verlieren – oder schlimmer noch, ein Bild zu erzeugen, das in der Realität nie existiert hat.


Die Kernfrage: Was passiert, wenn Sie Links aufteilen?

Die zentrale Frage aus unserer Data-Vault-Friday-Session lautete:

„Es wäre gut, das Thema Unit of Work noch einmal aufzugreifen. Welche Informationen verliere ich, wenn ich breitere Links in kleinere Paare aufteile (DrivingKey -> Key1/Key2 etc)? Ich kann mir ein technisches Setup vorstellen, bei dem ich mehrere Links und Effectivity Satellites nutze und in der Lage sein sollte, zu jedem beliebigen Zeitpunkt dieselben Ergebnisse zu erzielen… Welche Informationen gehen genau verloren, wenn ich Links aufteile?“

Das Risiko beim Aufteilen von Links: Ein Praxisbeispiel

Beginnen wir mit einem einfachen Beispiel, um das Problem zu veranschaulichen:

Stellen Sie sich eine Beziehung zwischen drei Geschäftsentitäten vor – Customer, Store und Product. Customers betreten Stores und kaufen Products. Wenn Sie diese Beziehung als einen einzelnen Link modellieren, der alle drei Hubs (Customer, Store, Product) umfasst, erhalten Sie ein präzises und unverfälschtes Bild dieser Transaktion.

Nehmen wir nun an, Sie entscheiden sich dafür, diesen Link in zwei kleinere Links aufzuteilen:

  • Customer -> Store
  • Customer -> Product

Auf den ersten Blick mag das unproblematisch erscheinen. Wenn Sie jedoch versuchen, den ursprünglichen Datensatz durch das Verknüpfen (Joinen) dieser beiden Links zu rekonstruieren, erzeugen Sie möglicherweise neue Kombinationen, die es in Wirklichkeit nie gegeben hat. Zum Beispiel:

  • Customer A hat Store K besucht und Product X gekauft (valide)
  • Customer A hat Store L besucht (ebenfalls valide), aber wenn Sie dies mit Product X verknüpfen, entsteht eine falsche Beziehung: Customer A hat Product X in Store L gekauft (was tatsächlich nie stattgefunden hat).

Dieses Phänomen, bei dem durch Joins neue, künstliche Datensätze generiert werden, führt zu Dateninkonsistenzen. Sie führen damit Beziehungen ein, die im Quellsystem nicht existierten. Genau darin liegt das wesentliche Risiko beim Aufteilen von Links.

Der Jedi-Test: Überprüfung Ihres Modells

Um solche Probleme zu vermeiden, empfiehlt Michael die Anwendung des sogenannten Jedi-Tests (Star-Wars-Fans dürfen sich freuen!).

Der Jedi-Test ist eine einfache, aber wirkungsvolle Validierungsmethode: Versuchen Sie, den ursprünglichen Quelldatensatz aus Ihrem Data-Vault-Zielmodell exakt zu rekonstruieren. Wenn Sie die ursprünglichen Zeilen genau reproduzieren können – nicht mehr und nicht weniger –, ist Ihr Modell optimal. Entstehen dabei zusätzliche oder fehlende Zeilen, liegt ein Modellierungsproblem vor.

Dieser Test stellt sicher, dass Ihre Links korrekt modelliert sind und beim Aufteilen weder Daten verloren gehen noch inkorrekte Beziehungen entstehen.

Driving Keys und Unit of Work

Ein Szenario, bei dem das Aufteilen von Links unausweichlich zu Problemen führt, ist der Einsatz von Driving Keys. Driving Keys sind eine Teilmenge von Business Keys, die eine Beziehung eindeutig identifizieren.

Michael erläutert, dass die Aufteilung von Komponenten eines Driving Keys fast immer das Prinzip der Unit of Work verletzt. Wenn Sie einen Driving Key zerlegen, gefährden Sie die Integrität Ihrer Beziehungsdaten. Daher sollten alle Hub-Referenzen aus derselben Quelle stets gemeinsam in einem Unit-of-Work-Link innerhalb des Raw Data Vault abgebildet werden.

Er betont, dass er selbst zwar kein Verfechter von Driving Keys ist (und von einer gewissen „Hassliebe“ spricht), es jedoch Anwendungsfälle gibt, in denen sie notwendig sind. Wenn dies der Fall ist, müssen Sie zwingend darauf achten, sie nicht aufzuteilen.

Die sicherste Lösung: Links im Raw Data Vault zusammenhalten

Die bewährte Best Practice lautet: Belassen Sie alle Hub-Referenzen aus derselben Quelltabelle zusammen in einem einzigen Link – dem Unit-of-Work-Link.

Dieser Ansatz garantiert, dass die vollständige Beziehung exakt so erfasst wird, wie sie im Quellsystem vorlag. Sie können diese Beziehungen später im Business Vault jederzeit aufteilen, wenn dort Transformationen und zusätzliche Geschäftsregeln greifen. Der Raw Data Vault hingegen dient als Ihre vertrauenswürdige, unveränderliche Single Source of Truth.

Indem Sie die Unit of Work im Raw Data Vault wahren, beugen Sie Dateninkonsistenzen vor und gewährleisten, dass Sie nachgelagert jederzeit korrekte und verlässliche Datenstrukturen aufbauen können.

Was tun, wenn ein Link aufgeteilt werden muss?

Gelegentlich erfordern technische Restriktionen die Aufteilung eines Links. Beispielsweise wenn:

  • Ihr Datenbanksystem die Anzahl der Hub-Referenzen limitiert, die in einen zusammengesetzten Index aufgenommen werden können.
  • Deskriptive Daten auf unterschiedlichen Granularitätsebenen vorliegen, die einen breiten Link unpraktikabel machen.

In solchen Fällen empfiehlt Michael folgende Vorgehensweisen:

  1. Behalten Sie den Unit-of-Work-Link als Basis-Link bei.
  2. Erstellen Sie zusätzliche Links, um spezifische Granularitätsanforderungen abzubilden (z. B. Customer -> Product, Customer -> Store, etc.).
  3. Wenn Sie Links aufteilen, stellen Sie sicher, dass alle fehlenden Beziehungen ebenfalls erfasst werden. Wenn Sie beispielsweise Customer -> Store and Customer -> Product, modellieren, benötigen Sie gegebenenfalls auch Store -> Product, um das vollständige Beziehungsgeflecht zu erhalten.

Diese ergänzenden Links ermöglichen es Ihnen, den ursprünglichen Datenbestand bei Bedarf exakt wiederherzustellen, erhöhen jedoch die Systemkomplexität. Mehr Links bedeuten mehr Entitäten, mehr Joins und potenziell geringere Abfragegeschwindigkeiten. Daher betont Michael die Bedeutung eines schlanken Modells und rät dazu, Links wann immer möglich zusammenzuhalten.

Effizienzüberlegungen

Unter Performance-Gesichtspunkten führen weniger Links mit mehr Hub-Referenzen in der Regel zu schnelleren Abfragen. Sie reduzieren die Anzahl der Joins und vereinfachen das Datenmodell. Mehr Links erhöhen dagegen die Komplexität und die Fehleranfälligkeit.

Die Abwägung ist daher eindeutig: Einfachheit und Effizienz durch einen Unit-of-Work-Link stehen der Flexibilität durch zusätzliche Links gegenüber – letzteres jedoch auf Kosten höherer Komplexität und operationeller Risiken.

Fazit und Empfehlungen

Zusammenfassend gilt:

  • Halten Sie Hub-Referenzen aus derselben Quelle im Raw Data Vault stets gemeinsam in einem Unit-of-Work-Link.
  • Führen Sie den Jedi-Test durch, um auszuschließen, dass Datenbeziehungen verloren gehen oder fälschlicherweise generiert werden.
  • Müssen Links getrennt werden, dokumentieren und verwalten Sie diese sorgfältig und stellen Sie sicher, dass sämtliche notwendigen Beziehungen erhalten bleiben (auch solche, die auf den ersten Blick nicht offensichtlich sind).
  • Verlagern Sie komplexe Aufteilungen und Transformationen in den Business Vault, da Anpassungen dort vorgenommen werden können, ohne den gesamten Datensatz neu laden zu müssen.

Eine sauber strukturierte Unit of Work stellt sicher, dass Ihr Data Vault ein robustes und verlässliches Fundament für Analytics, Reporting und Data-Science-Initiativen bleibt.
Video ansehen

Modellierung von Salesforce-History-Tabellen in Data Vault

Modellierung von Salesforce-History-Tabellen

Salesforce erfasst Änderungen an konfigurierten Attributen in sogenannten History-Tabellen. Diese Daten – darunter Record-ID, Feldname, vorheriger und neuer Wert sowie der Zeitstempel – stellen eine besondere Herausforderung für die Data-Vault-Modellierung dar. In diesem Artikel untersuchen wir, wie sich diese Daten unter Berücksichtigung der Data-Vault-Prinzipien optimal modellieren lassen.


Salesforce-History-Tabellen verstehen

Salesforce ermöglicht die Nachverfolgung bestimmter Attributänderungen innerhalb von Objekten wie Contacts. Diese Änderungen werden in History-Tabellen wie beispielsweise ContactHistory gespeichert. Jeder Eintrag protokolliert:

  • Record-ID (z. B. Contact-ID)
  • Feldname
  • Alter Wert
  • Neuer Wert
  • Zeitstempel

Herausforderungen bei der Modellierung von Salesforce-Historiedaten

Bei der Entwicklung eines Data-Vault-Modells für diese Historiedaten gilt es zentrale Herausforderungen zu beachten:

  • Verarbeitung mehrerer Änderungen desselben Datensatzes innerhalb eines kurzen Zeitraums
  • Gewährleistung der referenziellen Integrität
  • Effizientes Abfragen und Pivotieren von Daten für das Reporting

Ansatz: Multi-Active-Satellite

Ein gängiger erster Ansatz besteht darin, die History-Tabelle als Multi-Active-Satellite an einen Contact-Hub anzubinden, wobei der Feldname als Dependent-Key dient. Dieser Ansatz birgt jedoch Fallstricke:

  • Duplikate können entstehen, wenn mehrere Änderungen desselben Feldes innerhalb desselben Batches auftreten
  • Auf Zeitstempeln basierende Schlüssel sind unzuverlässig, da identische Zeitstempel vorkommen können

Um dem entgegenzuwirken, sollte in der Staging-Area eine eindeutige Sequenznummer vergeben und als Dependent-Key genutzt werden.

Optimierter Ansatz: Non-Historized-Link

Anstelle eines Multi-Active-Satellites kann ein Non-Historized-Link genutzt werden, um Salesforce-Historiedaten effizienter zu modellieren. So funktioniert es:

  • Erstellen Sie einen Non-Historized-Link, der den Contact-Hub und den User-Hub verbindet.
  • Speichern Sie änderungsbezogene Attribute (Feldname, alter Wert, neuer Wert, Zeitstempel) direkt in diesem Link.
  • Verwenden Sie den Zeitstempel als ereignisbasiertes Attribut und nicht als Teil des Primary-Keys.

Dieser Ansatz vermeidet komplexe Joins und vereinfacht die Abfragen spürbar.

Effizienter Datenabruf: Pivoting

Da History-Tabellen in einem Key-Value-Format strukturiert sind, erfordern Abfragen häufig ein Pivoting. Durch den Einsatz nativer Pivot-Funktionen der Datenbank lassen sich die Daten ohne übermäßige Joins in ein Format überführen, das für das Reporting optimal nutzbar ist.

Alternative Überlegung: JSON-Speicherung

Ein weiterer Ansatz besteht darin, Änderungsdaten als JSON-Objekt in einem Standard-Satellite zu speichern. Diese Methode bietet Flexibilität, insbesondere bei einer großen Anzahl von Attributen. Allerdings verkompliziert sie Abfragen und sollte nur dann eingesetzt werden, wenn es technisch zwingend erforderlich ist.

Fazit

In den meisten Fällen ist ein Non-Historized-Link die optimale Lösung, um Salesforce-History-Tabellen im Data Vault zu modellieren. Er vereinfacht die Datenspeicherung, reduziert den Bedarf an aufwendigen Joins und verbessert die Abfrageleistung. Multi-Active-Satellites stellen eine Alternative dar, erfordern jedoch einen sorgfältigen Umgang mit doppelten Zeitstempeln und wiederholten Feldänderungen.

Watch the Video

Flow.BI: Generierung des Raw Data Vaults mittels KI und dbt

Flow.Bi architecture Data Warehouse

Raw Data Vault

Diese Frage ist vielleicht so alt wie Data Vault selbst: Kann eine künstliche Intelligenz (KI) den Raw Data Vault generieren? Bis vor Kurzem war die vorherrschende Erwartung in der Branche, dass eine KI – sofern sie überhaupt existiert – bestenfalls Datenmodellierer unterstützen könnte, beispielsweise durch das Identifizieren und Vorschlagen von Business Keys oder das Gestalten einzelner Modellbereiche.

Die Frage entsteht aus einer Notwendigkeit: In der Vergangenheit sind Datenvolumen und Datenvielfalt exponentiell gewachsen. Es gibt keine Anzeichen dafür, dass sich dieses Wachstum in Zukunft verlangsamen wird. Aber wer soll all die Daten analysieren, die für heutige Datenplattformen benötigt werden? Es herrscht bereits ein Mangel an qualifizierten Data Engineers. Diese Situation wird sich in Zukunft weiter verschärfen, da die Zahl der Studierenden an den Universitäten nicht im gleichen Maße steigt.

Generierung des Raw Data Vaults mit Flow.BI und dbt

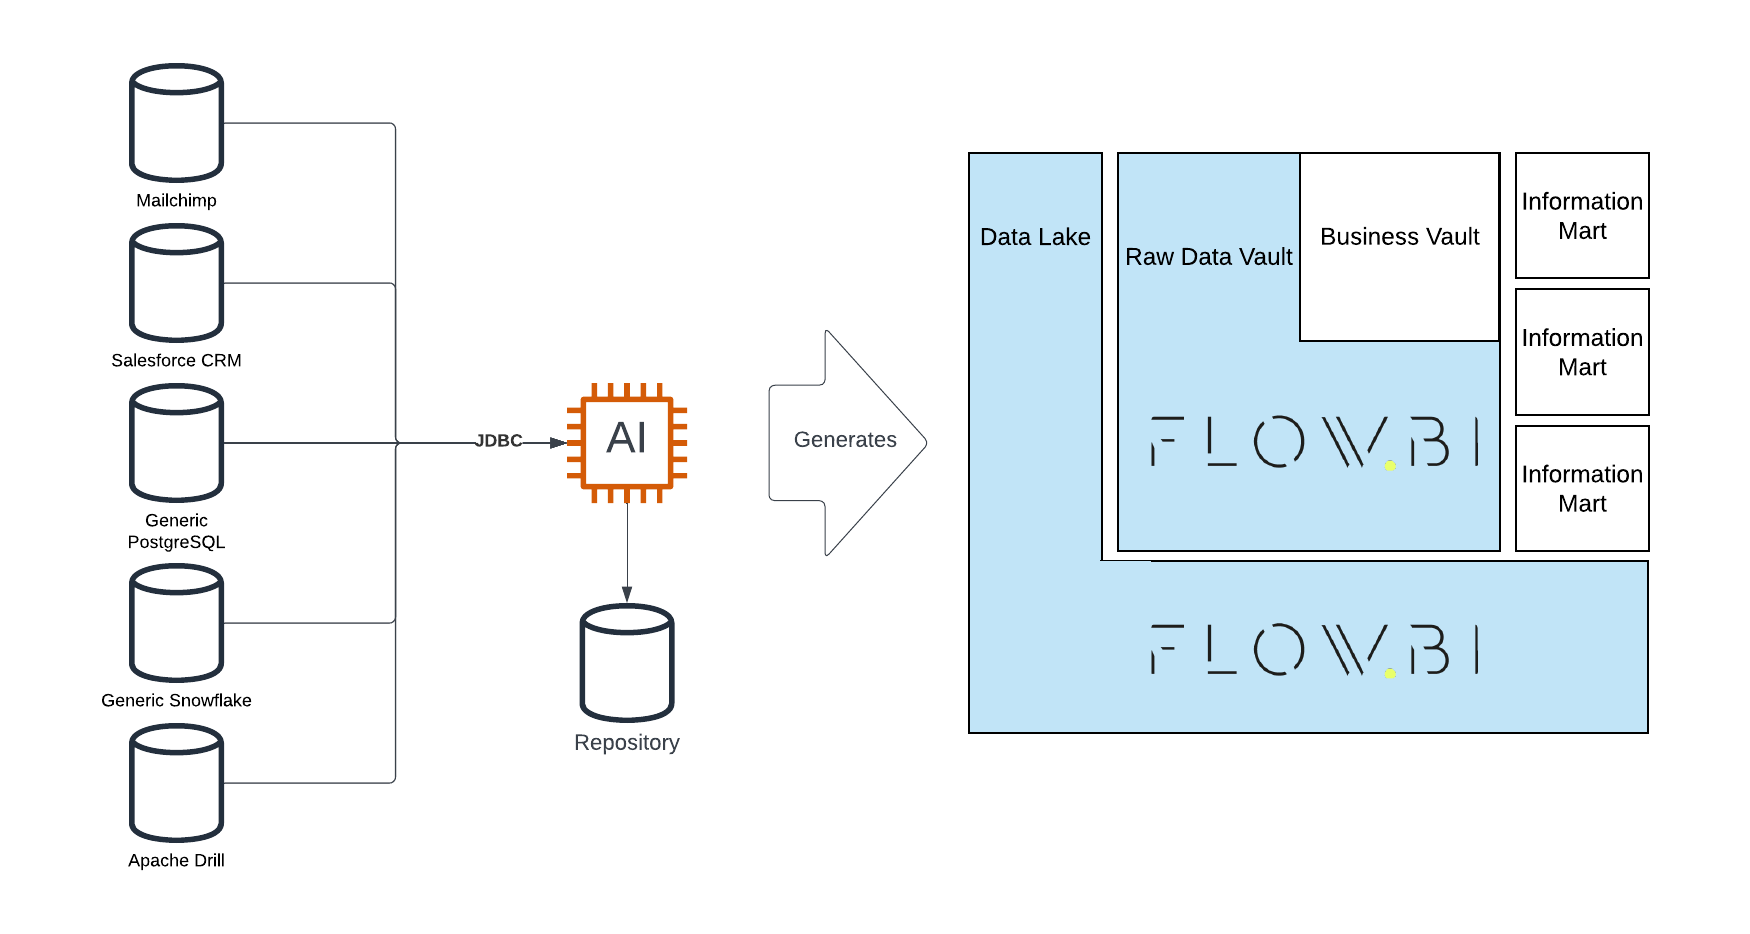
Wir stellen die Integration zwischen datavault4dbt und Flow.BI vor, die zur Generierung des Raw Data Vaults eingesetzt wird. Flow.BI ist eine künstliche Intelligenz, die in der Lage ist, alle Hubs, Links und Satellites für Unternehmensdaten zu definieren. Dies umfasst die Bestimmung der Business Keys und spezieller Entitätstypen wie Effectivity Satellites, Hierarchical Links, Multi-Active Satellites, Non-Historized Links und Reference Tables. Die Arbeitsteilung ist einfach: Die fortschrittliche KI von Flow.BI definiert den Raw Data Vault mit allen erforderlichen Entitäten, und datavault4dbt generiert den Code – einschließlich der CREATE-TABLE- und INSERT-INTO-Statements sowohl für das Modell als auch für die Ladeprozesse des Raw Data Vaults.

Watch Webinar Recording

Erwartungen übertroffen mit generativer KI

Mit dem Release von Flow.BI wurde die Erwartung übertroffen, dass nur eine unterstützende KI möglich sei. Flow.BI ist eine generative KI, die den Raw Data Vault vollständig definiert, einschließlich:

  • Hubs und ihrer Business Keys
  • Links, einschließlich Hierarchical Links
  • Satellites, einschließlich der Satellite-Splits für Datenschutz, Sicherheit und Rate-of-Change
  • Non-Historized Links und ihrer Satellites
  • Effectivity Satellites und Multi-Active Satellites
  • Reference Hubs und ihrer Satellites

Meistern Sie dbt für skalierbare Datenplattformen

Neben der Modellstruktur legt die fortschrittliche KI von Flow.BI auch die Ladedefinitionen fest, das heißt die Vorgabe, woher der Business Key eines Hubs oder das Attribut eines Satelliten geladen wird. Dies wird später genutzt, um die INSERT-INTO-Statements zu generieren.

Da all dies automatisiert durch die KI erledigt wird, funktioniert der Prozess auch in großem Maßstab und kann schnell Raw-Data-Vault-Modelle mit Tausenden von Entitäten generieren.

Vereinfachte Modellierung mit Flow.BI

Flow.BI vereinfacht den Modellierungsansatz drastisch: Alles, was Sie als Anwender tun müssen, ist, Datenquellen für die Analyse und das Profiling an Flow.BI anzubinden und den Prozess zu starten. Flow.BI definiert daraufhin mindestens ein gültiges Modell. Um dies zu erreichen, identifiziert die Lösung zuerst die Konzepte in den Entitäten der Datenquellen und anschließend die Business Keys für diese Konzepte. Als Nächstes identifiziert sie die Beziehungen und verarbeitet die beschreibenden Datenattribute in Satellites. Für den letzten Feinschliff fügt der integrierte Natural Language Generator die Dokumentation, Attribute und Ladedefinitionen der Entitäten hinzu.

Anwender können das Zielmodell weiter verfeinern, indem sie die identifizierten Konzepte sowie die Regeln für Datenschutz, Sicherheit und Satellite-Splits anpassen.

Ein datengetriebener Ansatz

Das von Flow.BI definierte Modell folgt einem datengetriebenen Ansatz und entspricht damit der Lehre der Data-Vault-Schulungen von Scalefree.

Bei einem datengetriebenen Ansatz bildet das Data-Vault-Modell die Rohdaten so ab, wie der Fachbereich sie nutzt. Das bedeutet: Der Fokus liegt klar auf den Rohdaten, während Business Keys die Daten über mehrere Datenquellen hinweg integrieren.

Die Idee dahinter ist, dass Business Keys häufig gemeinsam genutzte Schlüssel sind, die in mehreren Quellsystemen existieren und sich daher ideal für Integrationszwecke eignen.

Raw Data Vault vs. Business-Logik

Business-Logik wie WHERE-Bedingungen oder bedingte Logik hat in einem datengetriebenen Raw Data Vault keinen Platz. Ziel des Business Vaults ist es, den Raw Data Vault um genau diese Business-Logik zu erweitern.

Daher enthält das definierte Modell keinerlei Business-Logik, da diese erst später im Business Vault ergänzt wird. Dennoch ist das Raw-Data-Vault-Modell ein integriertes Unternehmensdatenmodell, das sich über alle angebundenen Datenquellen erstreckt.

Metadaten für fortgeschrittenes Data Warehousing

Die von Flow.BI erzeugten Metadaten können nicht nur für die Generierung des Raw Data Vaults verwendet werden, sondern auch für die Staging Area – sei es auf einer relationalen Datenbank oder in einem Data Lake.

Flow.BI generiert den Raw Data Vault nicht eigenständig physisch, sondern definiert ihn logisch. Das bedeutet, es gibt an, welche Hubs, Links und Satellites existieren sollten, um die Daten aus den Quellsystemen zu erfassen. Es erzeugt jedoch nicht direkt die CREATE-TABLE- und INSERT-INTO-Statements für das physische Modell. Stattdessen greift es auf Tools wie dbt über das Paket datavault4dbt zurück, um den Code zu generieren. Flow.BI übergibt die Metadaten des definierten Modells, und datavault4dbt erzeugt den eigentlichen Code.

In diesem Sinne agiert Flow.BI wie ein virtuelles Teammitglied, das die Datenquellen analysiert, profiliert, den Raw Data Vault modelliert und die Metadaten direkt in die SQL-Modelle von dbt einspeist.

Volle Kontrolle der Anwender über die KI-Modellierung

Flow.BI ahmt die Arbeitsweise menschlicher Datenmodellierer nach.

Bedeutet dies jedoch, dass Anwender die Kontrolle an die KI abgeben? Nein. Es gibt viele Möglichkeiten, die KI von Flow.BI zu steuern, um ein optimales Zielmodell zu erstellen. Doch zunächst sollte definiert werden, was ein besseres Modell ausmacht: Weniger Entitäten im Zielmodell? Schnellere Abfragen? Schnelleres Laden? Je nach Zielsetzung kann Flow.BI beispielsweise über die Klassifizierung von Konzepten und die Art der Datenbereitstellung gezielt beeinflusst werden.

Integration mit Data Warehouse Automation

Sobald die Metadaten für den Raw Data Vault definiert sind, werden sie an die Data-Warehouse-Automation-Lösung (DWA) übergeben. Eine der beliebtesten Optionen hierfür ist dbt. Scalefree hat das Open-Source-dbt-Paket datavault4dbt entwickelt, das sich in der Branche wachsender Beliebtheit erfreut.

Um SQL-Modelle für das dbt-Paket zu generieren, nutzt die Integration zwischen Flow.BI und datavault4dbt TurboVault, ein weiteres Open-Source-Paket von Scalefree. TurboVault bietet eine grafische Benutzeroberfläche, die die Metadaten für einen mit datavault4dbt zu generierenden Raw Data Vault aufbereitet.

Sobald die Metadaten für den Raw Data Vault definiert sind, werden sie an die Data-Warehouse-Automation-Lösung (DWA) übergeben. Eine der beliebtesten Optionen hierfür ist dbt. Scalefree hat das Open-Source-dbt-Paket datavault4dbt entwickelt, das sich in der Branche wachsender Beliebtheit erfreut.

Um SQL-Modelle für das dbt-Paket zu generieren, nutzt die Integration zwischen Flow.BI und datavault4dbt TurboVault, ein weiteres Open-Source-Paket von Scalefree. TurboVault bietet eine grafische Benutzeroberfläche, die die Metadaten für einen mit datavault4dbt zu generierenden Raw Data Vault aufbereitet.

Die optimale Lösung besteht darin, die Metadaten von Flow.BI in TurboVault einzuspeisen, um dessen Funktionen voll auszuschöpfen. Sobald die Metadaten geladen sind, generiert TurboVault die SQL-Modelle für datavault4dbt, welches wiederum die Data-Vault-Entitäten und die Ladeprozesse erzeugt.

Um die Integration zwischen Flow.BI und TurboVault zu erleichtern, hat Scalefree einen dedizierten Flow.BI-Konnektor veröffentlicht, der die logischen Datenmodelle aus Flow.BI abruft, transformiert und die automatisierte Generierung Ihres Data Vaults ermöglicht.

Mehrwert von Flow.BI

Flow.BI bietet vielschichtige Vorteile: Zunächst den Kostenvorteil. Die Definition des Modells mithilfe von KI ist weitaus kosteneffizienter als das manuelle Erstellen der Metadaten für datavault4dbt. Zudem sind erfahrene Data-Vault-Experten eine seltene und schwer verfügbare Ressource insbesondere wenn hohe Qualität gefordert ist, was bei Unternehmensdaten stets der Fall sein sollte.

Ein weiterer Vorteil von Flow.BI ist die Agilität: Statt den Raw Data Vault über Monate oder Jahre hinweg manuell zu definieren, berechnet die fortschrittliche KI von Flow.BI das Raw-Data-Vault-Modell innerhalb von Minuten oder wenigen Stunden.

Dies reduziert auch das Projektrisiko erheblich: Bei manuellen Ansätzen besteht das Risiko, nach jahrelanger Arbeit und hohen Investitionen ein unzureichendes Modell zu erhalten. Ein kompletter Neuanfang ist dann meist unrealistisch.

Mit Flow.BI liegen die Ergebnisse hingegen nahezu unverzüglich vor. Sollten Anpassungen nötig sein, können diese direkt vorgenommen werden, oder es steht weiterhin die manuelle Feinjustierung zur Verfügung.

Der beste Schritt für den Einstieg ist daher ein gemeinsamer Proof of Concept oder ein Workshop zu Flow.BI. Contactieren Sie uns gerne für nähere Informationen.

Data Vault Mixed Model

Watch the Video

Data-Vault-Mixed-Models verstehen: Integration von Non-Data-Vault-Entitäten in den Business Vault

Die Data-Vault-Architektur ist eine weit verbreitete Methodik im Data Warehousing, die ein hochgradig anpassungsfähiges Modell für die Verwaltung komplexer Datenumgebungen bietet. Sie organisiert Daten primär in drei Kernkomponenten: Hubs, Links und Satellites. Diese Elemente unterstützen Business Keys, Beziehungen und deskriptive Daten, um eine umfassende Datenstruktur innerhalb des Raw-Data-Vault-Layers zu schaffen. Wie bei vielen Methoden treten in der Praxis jedoch häufig Datenelemente auf, die außerhalb der strikten Grenzen dieser Struktur liegen, was Fragen zur Flexibilität aufwirft.

Dieser Artikel befasst sich mit dem Konzept eines „Mixed Models“ in Data Vault, bei dem Non-Data-Vault-Entitäten neben Raw-Data-Vault-Komponenten koexistieren, und zeigt auf, wie diese in eine Business-Vault-Struktur integriert werden können. Während der reine Data-Vault-Ansatz den Schwerpunkt auf Auditierbarkeit sowie Data Lineage legt und eine nahtlose Automatisierung ermöglicht, können Mixed Models bei umsichtigem Management durchaus eine pragmatische Lösung sein. Ist es also zulässig, Non-Data-Vault-Entitäten mit dem Raw Data Vault innerhalb eines Business Vaults zu kombinieren? Betrachten wir dieses Thema im Detail.

Was ist ein Data-Vault-Mixed-Model?

Ein „Mixed Model“ in Data Vault bezeichnet ein Szenario, in dem traditionelle Data-Vault-Strukturen (Hubs, Links und Satellites) parallel zu anderen Non-Data-Vault-Tabellen oder -Entitäten verwendet werden. Im Wesentlichen liegt der Großteil der Daten zwar im strukturierten Raw Data Vault, es existieren jedoch innerhalb derselben Datenbank weitere Datenkomponenten, die nicht der Data-Vault-Architektur entsprechen. Dies wirft Fragen bezüglich der Integration dieser unterschiedlichen Datentypen in den Business Vault auf.

Der Business Vault ist als verfeinerte, operative Version des Raw Data Vaults konzipiert. Er reichert die Rohdaten mit Business-Logik und Transformationen an, um handlungsrelevante Erkenntnisse zu generieren. In Szenarien, in denen ein Mixed Model erforderlich ist, besteht das Ziel häufig darin, bestehende Non-Data-Vault-Tabellen zu nutzen, um geschäftliche Erkenntnisse zu gewinnen und gleichzeitig Eingriffe in das ursprüngliche Datenmodell zu minimieren.

Können Sie Non-Data-Vault-Entitäten mit Rohdaten in den Business Vault integrieren?

Gemäß den Data-Vault-Prinzipien besteht der ideale Ansatz darin, alle Daten als Hubs, Links und Satellites zu strukturieren, um Konsistenz, Auditierbarkeit und Lineage zu gewährleisten. Ein Mixed-Model-Ansatz kann jedoch mitunter notwendig sein. Beispielsweise verfügen Sie möglicherweise über eine Datenbank, die im Raw Data Vault gespeicherte Daten mit Tabellen oder Entitäten kombiniert, die keinen Data-Vault-Strukturen folgen. Ist dies also erlaubt?

Die kurze Antwort lautet: Ja, Sie können Non-Data-Vault-Entitäten technisch in den Business Vault integrieren, dies ist jedoch mit Vorbehalten verbunden. Im Folgenden betrachten wir die wesentlichen Auswirkungen im Detail:

  1. Nur als Übergangslösung gedacht:
    Das Mischen von Non-Data-Vault-Daten mit Raw-Data-Vault-Entitäten wird im Allgemeinen als temporäre Lösung betrachtet. Es kann dabei helfen, Daten rasch einzubinden, die noch nicht in das Data-Vault-Modell passen, und ermöglicht so eine zügige Integration. Im Laufe der Zeit kann dieser Ansatz jedoch zu einer erhöhten Abfragekomplexität führen und die Konsistenz mindern, die Data Vault bietet.
  2. Auswirkungen auf Automatisierung und Wartbarkeit:
    Die Einführung nicht standardisierter Tabellen erschwert die Automatisierung innerhalb des Business Vaults. Das Data-Vault-Design setzt auf Automatisierungstools wie dbt, WhereScape und Vaultspeed. Diese Tools ermöglichen einen optimierten Workflow in Data-Vault-Implementierungen, indem sie automatisierte Lineage, Auditing und Datentransformationen unterstützen. Werden Non-Data-Vault-Entitäten eingeführt, beeinträchtigt dies die Automatisierungsfunktionen und erfordert benutzerdefinierte Skripte oder Abfragen, die von den standardmäßigen Data-Vault-Mustern abweichen.
  3. Gefährdung von Auditierbarkeit und Lineage:
    Eines der stärksten Wertversprechen von Data Vault ist der Fokus auf Data Lineage und Auditierbarkeit. In einem Mixed Model können diese Aspekte leiden. Ohne die Einhaltung der Struktur aus Hubs, Links und Satellites wird es schwierig, die Datenhistorie nachzuvollziehen, Versionskontrollen durchzuführen und alle Änderungen lückenlos zu erfassen. Für Unternehmen, die aus regulatorischen Gründen oder aufgrund hoher Qualitätsansprüche auf diese Funktionen angewiesen sind, kann eine beeinträchtigte Lineage ein gravierender Nachteil sein.
  4. User Mart als Alternative:
    Ein alternativer Ansatz besteht darin, einen „User Mart“ für Ad-hoc- oder analytische Abfragen aufzubauen, der Daten aus dem Raw Data Vault mit Non-Data-Vault-Tabellen kombiniert. Dieser User Mart ermöglicht es den Anwendern, sowohl den Raw Data Vault als auch externe Entitäten abzufragen, ohne die zentrale Business-Vault-Struktur zu beeinträchtigen. Dieser Weg eignet sich besonders dann, wenn Benutzer spezifische Reporting- oder Analyseanforderungen haben, die keine vollständige Data-Vault-Transformation erfordern.
  5. Pragmatischer Ansatz:
    Virtuelle Hubs und Links: Eine praktische Zwischenlösung in Data-Vault-Projekten besteht darin, „virtuelle“ Hubs, Links und Satellites für nicht standardisierte Tabellen zu erstellen, die als Platzhalter innerhalb der Raw-Data-Vault-Struktur dienen. Dieser Ansatz ermöglicht eine schnelle Integration und bewahrt gleichzeitig ein gewisses Maß an Standardisierung. Liegt beispielsweise eine Referenztabelle mit Ländernamen und Ländercodes vor, könnten Sie einen virtuellen Hub für das Land erstellen und deskriptive Details als virtuellen Satellite abbilden. Dadurch wird zwar keine vollständige Lineage erreicht, es entsteht jedoch eine funktionale Brücke, bis eine reguläre Data-Vault-Struktur implementiert werden kann.
  6. Referenztabellen und unkritische Daten:
    In Szenarien, in denen Daten wie Referenztabellen (z. B. Ländercodes, Postleitzahlen) keine lückenlose Lineage oder Versionsverfolgung erfordern, kann eine breite, flache Referenztabelle verwendet werden. Wenn ein Referenz-Hub und ein Referenz-Satellite nicht zwingend erforderlich sind, reicht es häufig aus, die Daten mit einem Primärschlüssel und deskriptiven Spalten einfach zu halten. Dieser Ansatz eignet sich gut für unkritische Daten, bei denen der Aufwand für die strikte Einhaltung aller Data-Vault-Vorgaben unverhältnismäßig wäre.

Strategien für langfristigen Erfolg mit einem Mixed Model

Wenn Sie sich für ein Mixed Model entscheiden, ist es entscheidend, den zukünftigen Übergang zu einem vollständig Data-Vault-konformen Design von vornherein einzuplanen. Hier sind einige Empfehlungen:

  1. Refactoring von Non-Data-Vault-Entitäten priorisieren:
    Erstellen Sie eine klare Roadmap, um Non-Data-Vault-Tabellen sukzessive in Hubs, Links und Satellites zu überführen. Dieser phasenweise Ansatz ermöglicht es Ihnen, innerhalb bestehender Rahmenbedingungen produktiv zu bleiben und parallel einen robusteren, standardkonformen Business Vault aufzubauen.
  2. Technische Schulden minimieren:
    Erfassen Sie alle Non-Data-Vault-Elemente in Ihrem Datenökosystem und behandeln Sie diese als „technische Schulden“, die langfristig verwaltet und abgebaut werden müssen. So behalten Sie stets den Überblick über Bereiche, in denen Auditierbarkeit oder Automatisierung eingeschränkt sein könnten.
  3. Metadatengesteuerte Automatisierung nutzen:
    Setzen Sie so weit wie möglich metadatengesteuerte Automatisierungstools ein, um zukünftige Integrationen und Migrationen zu vereinfachen. Diese Tools ermöglichen eine automatisierte Datenverarbeitung entlang der gesamten Data-Vault-Pipeline und erleichtern es, neue Datenquellen anzubinden und in konforme Data-Vault-Strukturen zu überführen.
  4. Strenge Governance für benutzergenerierte Daten etablieren:
    In Fällen, in denen Fachbereiche eigene Datenmodelle im User Mart oder im Business Vault einführen, sollten Sie Governance-Richtlinien definieren, um die Datennutzung zu standardisieren und ein Mindestmaß an Ausrichtung an den Data-Vault-Mustern zu wahren. Diese Vorgaben minimieren Risiken für die Datenqualität und stellen sicher, dass Non-Data-Vault-Daten beherrschbar bleiben.

Praxisbeispiel: Ein Mixed Model im Einsatz

Stellen Sie sich einen Finanzdienstleister vor, der einen Raw Data Vault mit Transaktionsdaten betreibt, aber auch über ein separates Schema für Kundenreferenztabellen verfügt, etwa für soziodemografische Kundendaten und Standortdetails. Anstatt diese Tabellen direkt in den Business Vault zu integrieren, könnte das Unternehmen virtuelle Hubs und Links erstellen, die Kunden-IDs und Standorte mit Transaktionen verknüpfen. Dies ermöglicht es, weiterhin innerhalb des Raw-Data-Vault-Frameworks zu arbeiten und gleichzeitig die schrittweise Überführung der Referenztabellen in reguläre Data-Vault-Standards vorzubereiten.

Ein weiteres Beispiel ist ein großes Einzelhandelsunternehmen, in dem benutzergenerierte Datenmodelle im User Mart häufig zur Unterstützung von Marketinganalysen verwendet werden. Hier könnte das Unternehmen ein temporäres Mixed Model implementieren, das schnelle Analysen liefert, während parallel eine phasenweise Migration in vollwertige Data-Vault-Strukturen vorangetrieben wird.

Fazit: Flexibilität und Data-Vault-Integrität in Einklang bringen

Obwohl ein Mixed Model innerhalb der Data-Vault-Architektur nicht die reine Lehre darstellt, kann es als temporäre, pragmatische Lösung dienen, wenn Non-Data-Vault-Entitäten kurzfristig integriert werden müssen. Virtuelle Hubs und Links, User Marts und klare Governance-Richtlinien helfen dabei, die durch nicht standardisierte Tabellen entstehende Komplexität zu beherrschen. Dennoch sollten Unternehmen der sukzessiven Migration aller Daten in das Data-Vault-Modell Priorität einräumen, um die langfristigen Vorteile von Data Vault – wie vollständige Auditierbarkeit, Data Lineage und Automatisierbarkeit – nachhaltig zu sichern.

Letztlich gilt: Die Stärke von Data Vault liegt in seiner Flexibilität, Auditierbarkeit und Skalierbarkeit. Der Einsatz von Non-Data-Vault-Tabellen als Übergangslösung ist machbar – für eine zukunftssichere und verlässliche Informationsarchitektur bleibt ein vollständig Data-Vault-konformes Modell jedoch die beste Wahl.

Modellierung von Adressdaten

Video ansehen

Modellierung von Adressdaten: Wichtige Erkenntnisse und Empfehlungen

Adressdaten gehören zu den grundlegenden Bestandteilen moderner Unternehmensdatenbanken – insbesondere dort, wo detaillierte Kundeninformationen unverzichtbar sind. Die Vielschichtigkeit von Adressen kann den Modellierungsprozess jedoch anspruchsvoll gestalten, vor allem wenn das Ziel ein einzelner zentraler Hub ist, der sämtliche Adressdaten konsolidiert. In einer Ausgabe des Formats Data Vault Friday untersuchte Michael Olschimke von Scalefree die besten Ansätze zur effektiven Modellierung von Adressdaten unter Berücksichtigung zentraler geschäftlicher und regulatorischer Anforderungen. Dieser Artikel fasst die wichtigsten Erkenntnisse zusammen und gibt praxiserprobte Empfehlungen für den Aufbau eines robusten, skalierbaren und effizienten Adressdatenmodells.

Der Kontext: Adressdaten in einem einzelnen Hub

In dem diskutierten Szenario bestand die Herausforderung darin, unterschiedliche Adresstypen innerhalb eines einzigen Hubs abzubilden. Das Hauptziel lag darin, redundante Adressdaten zu vermeiden und den Umgang mit NULL-Werten zu vereinfachen. Gemäß den ISO-20022-Standards und Vorgaben der Europäischen Union umfasste das Datenmodell Attribute wie STREET_NAME, BUILDING_NUMBER, BUILDING_NAME, ROOM, FLOOR, POSTAL_CODE, TOWN_NAME, COUNTRY_CODE, ADDRESS_LINE_1 und ADDRESS_LINE_2. Jedes dieser Felder ist Teil eines zusammengesetzten Business-Keys, der zur eindeutigen Identifizierung jeder einzelnen Adresse dient.

Ein pragmatischer Vorschlag aus dem Projektteam sah vor, NULL-Werte durch Platzhalter (wie beispielsweise „-2“) zu ersetzen, um Ladevorgänge zu vereinfachen und Abbrüche bei der Verarbeitung zu verhindern. Olschimke zeigte jedoch alternative Lösungswege auf, die sicherstellen, dass das Datenmodell langfristig wartbar und skalierbar bleibt.

Herausforderungen beim Ersetzen von NULL-Werten

Das Ersetzen von NULL-Werten in Business-Keys mag Ladeprozesse auf den ersten Blick erleichtern, bringt jedoch in nachgelagerten Prozessen (Downstream) gravierende Nachteile mit sich, vor allem bei der dimensionalen Modellierung und der konsistenten Abbildung der Geschäftslogik. Werden NULL-Werte unreflektiert durch Werte wie „-2“ substituiert, können diese Platzhalter bis in operative Berichte durchschlagen und Fehlinterpretationen auslösen. Olschimke empfahl stattdessen ein systematisches Vorgehen mit festen Hash-Werten („Fixed Hash Values“) etwa reinen Null- oder F-Werten –, um Standard-, Leer- oder Fehlerzustände eindeutig zu kennzeichnen.

Durch die Verwendung definierter Hash-Werte lassen sich Ausnahme- und Fehlerfälle direkt auf Datenebene abfangen. Dies erspart fehleranfällige Filterlogiken in nachgelagerten Schichten und sorgt für transparente, nachvollziehbare Verarbeitungsprozesse.

Vermeidung überladener Hubs und von NULL-Werten in zusammengesetzten Keys

Ein zentraler Schwerpunkt lag auf der Vermeidung überladener Hubs („Hub Overloading“). Dieses Problem entsteht, wenn fachlich unterschiedliche Konzepte in ein und derselben Hub-Tabelle vermengt werden. Typischerweise geschieht dies, wenn stark abweichende Adressarten unter einem gemeinsamen Business-Key zusammengefasst werden, obwohl Attribute wie ROOM oder FLOOR nur für einen Bruchteil der Datensätze relevant sind.

Laut Olschimke führen überladene Hubs zu unnötiger Komplexität, die durch ungleiche Granularitätsstufen und lückenhafte Datenprofile verursacht wird. So können unter einer einzigen postalischen Adresse mehrere Gebäude, Etagen oder Einzelräume existieren. Werden diese unterschiedlichen Granularitäten in einem Hub erzwungen, leidet die Aussagekraft der Datenbeziehungen. Die Empfehlung lautet daher, Granularitätsebenen strikt voneinander zu trennen, Adresstypen bei Bedarf in separate Strukturen aufzuteilen oder flexiblere Datenformate einzusetzen.

Alternative Modellierungsansätze: JSON-Strukturen und Reference Tables

Wenn verschiedene Adresstypen ein hohes Maß an Flexibilität erfordern, stellen JSON-basierte Datenstrukturen eine elegante Alternative dar. JSON erlaubt es, Adressattribute dynamisch zu erfassen, sodass stets nur die Attribute gespeichert werden, die für den jeweiligen Adresstyp tatsächlich vorliegen. Dadurch wird eine Überladung des Schemas vermieden, ohne auf starre Tabellendefinitionen angewiesen zu sein.

In einem JSON-basierten Hub können die Adressdaten vor dem Hashing in ein standardisiertes, nach Attributnamen sortiertes JSON-Objekt überführt werden. Eine einheitliche Sortierung der Schlüssel ist hierbei zwingend erforderlich, um identische Hash-Werte für identische Adressen zu garantieren. Richtig umgesetzt, sorgt dieser Ansatz für schlanke Hubs, flexible Laderoutinen und eine unkomplizierte Weiterverarbeitung im Downstream.

Als weiterer praxistauglicher Weg bieten sich Reference Tables für häufig genutzte, normierte Adressdaten an. Als zentrale Referenzquelle ermöglichen sie eine zuverlässige Deduplizierung über eine eindeutige Adress-ID, was Redundanzen über mehrere Hubs hinweg wirksam minimiert.

Adressdaten als deskriptive Attribute in Satellites führen

Statt Adressbestandteile in den Business-Key eines Hubs aufzunehmen, ist es häufig sinnvoller, sie als rein deskriptive Attribute innerhalb einer Satellite-Tabelle zu führen. Auf diese Weise bleibt der Hub frei von Attributen, die für die eindeutige fachliche Identifikation der Kernentität nicht zwingend erforderlich sind. Werden Adressdaten in Satellites gespeichert und mit der übergeordneten Business-Entität (wie Kunden oder Standorten) verknüpft, entsteht eine ausgewogene Balance aus Deduplizierung und Modellierungsaufwand.

Olschimke rät insbesondere dann zu dieser Lösung, wenn die Vermeidung von Redundanzen oberste Priorität hat. Dies folgt einem Kernprinzip von Data Vault: Satellite-Tabellen erfassen deskriptive, zeitlich veränderliche Kontextdaten, während Hubs ausschließlich stabile fachliche Schlüssel abbilden.

Anwenden von Business Rules in der Data-Vault-Modellierung

Adressdaten erfordern häufig spezifische Business Rules – insbesondere bei mehrteiligen Schlüsseln oder der Dublettenbereinigung. Das bloße Ersetzen fehlender Werte durch Standardzeichenketten behindert den sauberen Aufbau dimensionaler Modelle im Downstream. Empfohlen wird stattdessen ein zweistufiges Vorgehen: Erstens die Definition der Business-Keys im Hub unter Nutzung standardisierter Hash-Ersatzwerte für das Fehler- und Default-Handling, zweitens die einheitliche Ausgestaltung der Satellite-Strukturen, um unterschiedliche Adressformate dynamisch aufzunehmen.

Jedes Unternehmen hat individuelle Rahmenbedingungen. Ob die Wahl auf spezialisierte Hubs, JSON-Attribute oder Reference Tables fällt, richtet sich maßgeblich danach, welche operative Rolle Adressdaten in Ihren Kernprozessen spielen. Wer eine Überladung von Hubs konsequent vermeidet und auf Skalierbarkeit setzt, schafft ein Datenmodell, das den Wartungsaufwand minimiert und gleichzeitig maximale Datenqualität bietet.

Fazit

Die Modellierung von Adressdaten in Data Vault erfordert Sorgfalt vor allem beim Versuch, ein universelles Hub-Design für heterogene Adresstypen zu etablieren. Die vorgestellten Lösungsansätze setzen auf Flexibilität, strukturelle Klarheit und saubere Business Rules, ohne Hubs zu überfrachten. JSON-basierte Strukturen, Reference Tables und die Auslagerung in Satellites bieten tragfähige Alternativen, mit denen sich die Risiken zusammengesetzter Business-Keys und unklarer NULL-Wert-Substitutionslogiken vermeiden lassen.

Für Unternehmen mit vielschichtigen Adresslandschaften zahlt sich die Prüfung dieser Ansätze aus – sowohl hinsichtlich automatisierter Deduplizierung als auch mit Blick auf Governance und Skalierbarkeit.

Möchten Sie Ihr Wissen vertiefen? Nutzen Sie die Webinare von Scalefree und werden Sie Teil der Community Data Innovators Exchange, um sich über Best Practices rund um Datenmodellierung, Cloud-Architekturen und Data Vault 2.0 zu informieren.

Haben Sie noch immer mit der DSGVO zu kämpfen?

Video ansehen

DSGVO-Compliance im Data Warehousing meistern

Im heutigen digitalen Zeitalter ist die DSGVO-Compliance ein entscheidender Aspekt für jedes Unternehmen, das personenbezogene Daten verarbeitet. Mit der zunehmenden Bedeutung von Data Warehousing und modernen Modellierungsansätzen wie Data Vault 2.0 (DV 2.0) stellen sich häufig Fragen zum Umgang mit personenbezogenen Daten (Personally Identifiable Information, PII) innerhalb dieser Frameworks. Dieser Artikel befasst sich mit gängigen Herausforderungen und liefert praxisnahe Empfehlungen zur Gewährleistung der DSGVO-Compliance in Data Warehouses.


Die Herausforderung verstehen

Die DSGVO schreibt vor, dass personenbezogene Daten mit größter Sorgfalt behandelt werden müssen, um die Privatsphäre und Sicherheit von Personen zu gewährleisten. Im Kontext des Data Warehousing bedeutet dies häufig den sachgerechten Umgang mit Business Keys, die möglicherweise PII enthalten. Betrachten wir dazu einige konkrete Fragestellungen:

  1. Wie sollte die Aktivitätshistorie verwaltet werden, wenn der Main Hub einen PII-Business-Key enthält?
  2. Entspricht es der Best Practice, gehashte Business Keys in Link Tables zu verwenden, um die Ladeperformance zu verbessern?
  3. Sollten Artificial Keys aus der jeweiligen Business Domain stammen, und wie sollten sie verwaltet werden, falls dies nicht der Fall ist?

Frage 1: Verwaltung der Aktivitätshistorie bei PII-Business-Keys

Das Problem

In einem typischen Data-Warehouse-Modell können Kundendatensätze PII wie Sozialversicherungsnummern oder Steuer-IDs enthalten. Gemäß der DSGVO ist es entscheidend, dass die Aktivitätshistorie nicht mehr auf die betroffene Person zurückgeführt werden kann, sobald diese von ihrem Recht auf Vergessenwerden Gebrauch macht.

Die Lösung

Ein effektiver Ansatz besteht darin, beschreibende Attribute auf verschiedene Satellites aufzuteilen – einen für personenbezogene Daten und einen weiteren für nicht-personenbezogene Daten. Auf diese Weise muss bei einem Löschantrag lediglich der personenbezogene Satellite bereinigt (gepurged) werden. Der nicht-personenbezogene Satellite kann anonymisierte Daten beibehalten, wodurch die Integrität des Datensatzes gewahrt und gleichzeitig die Compliance sichergestellt wird.


Frage 2: Verwendung von Hashed Business Keys in Link Tables

Das Problem

Das Hashen von Business Keys wird in DV 2.0 häufig empfohlen, um die Ladeperformance zu steigern. Die direkte Verwendung von Business Keys in Link Tables kann jedoch eine Herausforderung darstellen, insbesondere wenn diese Keys PII enthalten.

Die Lösung

In DV 2.0 ist es gängige Praxis, Hash-Werte der Business-Key-Komponenten anstelle der eigentlichen Business Keys zu verwenden. Dieser Ansatz gewährleistet eine bessere Performance und Sicherheit. Der Ablauf gestaltet sich wie folgt::

  1. Den Business Key hashen: Verwenden Sie eine kryptografische Hashfunktion (z. B. SHA-256), um den Business Key in einen Hashwert umzuwandeln.
  2. Hashed Keys in Link Tables verwenden: Der Hashed Key dient anschließend als Foreign Key in Link Tables, wodurch sichergestellt wird, dass PII nicht direkt offengelegt werden.

Frage 3: Erzeugung und Verwaltung von Artificial Keys

Das Problem

Es wird diskutiert, ob Artificial Keys innerhalb der jeweiligen Business Domain oder im Data Warehouse selbst generiert werden sollten. Dies wirft Fragen hinsichtlich der Konsistenz und Verwaltung auf, insbesondere wenn der Artificial Key aus PII abgeleitet werden muss.

Die Lösung

Artificial Keys sollten idealerweise im Data Warehouse generiert werden, um Konsistenz und Kontrolle zu gewährleisten. Der Prozess gestaltet sich wie folgt:

  1. Eine UUID generieren: Verwenden Sie einen Universally Unique Identifier (UUID) für den Artificial Key. Dies gewährleistet Zufälligkeit und minimiert das Risiko von Duplikaten.
  2. Artificial Keys mit Business Keys verknüpfen: Stellen Sie innerhalb des Data Warehouse eine Beziehung zwischen dem Artificial Key und dem Business Key her, um sicherzustellen, dass der Artificial Key in operativen Systemen niemals offengelegt wird.

Umgang mit Szenarien ohne Artificial Keys

Falls die Bereitstellung von Artificial Keys durch die jeweilige Business Domain nicht realisierbar ist, sollte das Data Warehouse diese Keys während des Ingestion-Prozesses erzeugen. Diese Methode stellt sicher, dass alle Keys konsistent und sicher verwaltet werden.


Gewährleistung von Compliance und Sicherheit

Satellite Splitting

Durch das Aufteilen von Satellites in personenbezogene und nicht-personenbezogene Daten können Unternehmen Löschanträge problemlos abwickeln, ohne die Datenintegrität zu beeinträchtigen.

Kryptografisches Hashing

Der Einsatz von kryptografischem Hashing für Business Keys in Link Tables verbessert sowohl die Sicherheit als auch die Performance – ein wesentlicher Aspekt zur Einhaltung der DSGVO.

Verwaltung von Artificial Keys

Die Erzeugung von Artificial Keys innerhalb des Data Warehouse gewährleistet Konsistenz sowie Sicherheit und verringert das Risiko einer PII-Offenlegung.

Regelmäßige Audits und rechtliche Beratung

Regelmäßige Audits und die Abstimmung mit Rechtsexperten stellen die fortlaufende Einhaltung der DSGVO und weiterer regulatorischer Vorgaben sicher. Durch die Umsetzung dieser Praktiken können Unternehmen potenziellen Compliance-Risiken vorausschauend begegnen.


Fazit

Der Umgang mit PII in Data Warehouses erfordert eine sorgfältige Planung und robuste Lösungen. Durch die Implementierung von Satellite Splitting, kryptografischem Hashing und einer konsistenten Verwaltung von Artificial Keys können Unternehmen die DSGVO-Compliance gewährleisten und gleichzeitig Datenintegrität sowie Performance aufrechterhalten. Regelmäßige Audits und juristische Begleitung stärken diese Verfahren zusätzlich und stellen sicher, dass Datenverarbeitungsprozesse auch bei sich wandelnden regulatorischen Anforderungen sicher und konform bleiben.

Laden technischer Counter-Transactions

Watch the Video

Data-Vault-Performance bei inkrementellen Änderungen und Löschungen steuern

In der Welt des Data Warehousing hat sich die Data-Vault-Methodik als robuste und skalierbare Lösung für die Verwaltung riesiger Datenmengen etabliert. Eine häufige Frage in der Praxis lautet jedoch, wie sich inkrementelle Änderungen und Löschungen effizient handhaben lassen – insbesondere bei Tabellenstrukturen mit Milliarden von Zeilen. Dieser Artikel erläutert das Vorgehen und konzentriert sich dabei auf das Laden von Datenstrukturen, Performance-Aspekte sowie praxiserprobte Strategien zur Aufrechterhaltung maximaler Effizienz.


Die Grundlagen verstehen: Nachverfolgung von Änderungen und Löschungen

Das Kernprinzip von Data Vault besteht darin, alle Änderungen und Löschungen inkrementell zu erfassen. Dadurch wird sichergestellt, dass das Data Warehouse stets eine historisch exakte Abbildung der Quell- und Unternehmensdaten bleibt. Dieses Prinzip lässt sich wie folgt zusammenfassen:

  1. Initial Load: Wird eine neue Transaktion erfasst, fließt sie als neuer Datensatz in das Data Vault ein. Kauft beispielsweise Kunde A an Tag 1 das Produkt C in Filiale B, wird diese Transaktion mit einem Wert von 7 € gespeichert.
  2. Umgang mit Updates: Ändert sich der Wert der Transaktion an Tag 2 von 7 € auf 5 €, wird der bestehende Datensatz nicht überschrieben. Stattdessen werden zwei neue Datensätze erzeugt: einer zur Neutralisierung der ursprünglichen Transaktion (-7 €) und ein weiterer zur Erfassung des neuen Werts (5 €).
  3. Umgang mit Löschungen: Wird eine Transaktion gelöscht, erfolgt die Verarbeitung analog durch das Einfügen eines kompensierenden Datensatzes, der die ursprüngliche Transaktion aufhebt.

Diese Methode stellt sicher, dass das Data Vault unveränderlich (immutable) bleibt, da Datensätze nach dem Laden niemals direkt modifiziert werden. Stattdessen werden Änderungen ausschließlich additiv nachverfolgt, was die Ladeprozesse vereinfacht und die lückenlose Datenintegrität wahrt.


Laden von Strukturen: Der praxisnahe Ansatz

Das Beladen von Data-Vault-Strukturen kann bei sehr großen Datenmengen eine Herausforderung darstellen. Bewährt haben sich hierbei folgende Strategien:

Einsatz von CDC (Change Data Capture)

Sofern das Quellsystem CDC unterstützt, bietet dies den geradlinigsten Ansatz:

  • Neue Datensätze einfügen: Schreiben Sie neue Datensätze direkt in das Zielsystem.
  • Updates und Deletes verarbeiten: Fügen Sie für Aktualisierungen und Löschungen die entsprechenden Counter-Transactions ein.

CDC ermöglicht eine transparente und performante Erfassung von Änderungen und Löschungen, was den Ladeprozess spürbar vereinfacht.

Full Load vs. Incremental Load

In Szenarien mit vollständigen Datenabzügen (Full Loads) umfasst der Ablauf typischerweise folgende Schritte:

  • Neue Datensätze identifizieren: Selektieren Sie Datensätze aus der Staging-Area, die im Zielsystem noch nicht vorhanden sind, und fügen Sie diese mit einem Counter-Wert von 1 ein.
  • Löschungen identifizieren: Ermitteln Sie Datensätze aus dem Zielsystem, die in der Staging-Area fehlen, und erzeugen Sie Counter-Transactions, um diese Datensätze zu neutralisieren.

Obwohl Full Loads ressourcenintensiv sind, lassen sie sich durch eine gezielte Optimierung der Differenzlogik zwischen Quell- und Zielbestand kontrolliert betreiben.


Performance-Aspekte

Die Verarbeitung von Milliarden Datensätzen verlangt eine vorausschauende Architektur, um Engpässe zu vermeiden. Die folgenden Ansätze tragen entscheidend zur Systemstabilität bei:

Parallele Verarbeitung

Durch die Parallelisierung von Ladejobs lässt sich der Durchsatz deutlich steigern. So können beispielsweise separate Prozesse Inserts und Counter-Transactions gleichzeitig abarbeiten.

Hash-Keys und Indizes

Der gezielte Einsatz von Hash-Keys und Indizes reduziert den Suchaufwand beim Abgleich bestehender Datensätze drastisch. Stellen Sie sicher, dass Ihre Hash-Keys alle relevanten Business-Keys und Transaction-IDs abbilden, um eine eindeutige Zuordnung zu garantieren.

High-Water-Marks und Systemindikatoren

Bestimmte Datenbanksysteme bieten Mechanismen wie die SCN (System Change Number) bei Oracle oder zeilenbasierte Versionsnummern, mit denen sich modifizierte Datensätze schnell lokalisieren lassen. Durch diese Indikatoren lässt sich das zu verarbeitende Datenvolumen auf die tatsächlich veränderten Datensätze eingrenzen.


Praxisbeispiel: Incremental Loading ohne CDC

Steht quellseitig kein CDC zur Verfügung, lässt sich dennoch ein effizientes inkrementelles Laden realisieren:

  1. Inkrementelle Updates aus der Quelle: Stellt das Quellsystem tägliche Deltas (neue und geänderte Datensätze) bereit, nutzen Sie diese Bestände direkt zur Fortschreibung des Zielsystems.
  2. Umgang mit Löschungen: Für gelöschte Datensätze empfiehlt sich eine separate Protokolltabelle oder ein Abgleichmechanismus. Liegen diese Informationen vor, generieren Sie daraus die erforderlichen Counter-Transactions.
  3. Full-Load-Ansatz: Stehen ausschließlich vollständige Datensätze zur Verfügung, empfiehlt sich ein zweistufiges Verfahren zur systematischen Erkennung von neuen, modifizierten und gelöschten Datensätzen.

Fazit

Das Verwalten inkrementeller Änderungen und Löschungen in Data-Vault-Umgebungen erfordert – vor allem bei hohem Datenaufkommen – eine maßgeschneiderte Strategie, abgestimmt auf die technischen Gegebenheiten Ihrer Quellsysteme. Ob über CDC, Full Loads oder inkrementelle Updates: Das Ziel bleibt ein historisch verlässliches und performantes Data Warehouse. Mit einem fundierten Architekturverständnis und pragmatischen Lösungsansätzen behalten Sie die Performance Ihrer Data-Vault-Plattform auch bei wachsender Systemlast sicher im Griff.

Behalten Sie im Blick: Der Projekterfolg basiert auf einer soliden Planung, der schonenden Nutzung von Datenbankressourcen und der stetigen Optimierung Ihrer Laderoutinen. Mit diesen Leitlinien stellen Sie sicher, dass Ihre Data-Vault-Architektur flexibel und stabil mit Ihren Datenanforderungen wächst.

Definieren mehrerer Snapshots pro Tag mittels Control-Tabelle

Video ansehen

In unserer fortlaufenden Reihe beantwortet unser CEO Michael Olschimke eine Frage aus dem Publikum:

„Würde eine Micro- oder Mini-Batch-Aktualisierungsfrequenz in den PIT-Tabellen des Data Warehouse mit anschließend synchronisiertem Reporting zu mehreren Zeitstempeln für ein bestimmtes Datum in der Snapshot-Control-Tabelle führen?“

Michael Olschimke geht detailliert auf das Konzept mehrerer Snapshots ein und erläutert, wie diese wertvolle Einblicke in die zeitliche Entwicklung von Daten liefern. Durch das Erfassen von Snapshots zu verschiedenen Zeitpunkten gewinnen Unternehmen ein tieferes Verständnis für Trends, Muster und Anomalien in ihren Beständen. Dieser differenzierte Ansatz im Datenmanagement ermöglicht fundiertere Entscheidungen und eine nachhaltig verbesserte Performance.

Erfahren Sie im Video mehr über die Funktionsweise mehrerer Snapshots und deren konkrete Auswirkungen auf moderne Data-Warehouse-Architekturen.

Soft-Deleting Records in Data Vault 2.0

Video ansehen

In unserer fortlaufenden Reihe beantwortet unser CEO Michael Olschimke eine Frage aus dem Publikum:

„Hallo, meine Frage bezieht sich auf Effectivity Satellites. Mir ist aufgefallen, dass es in Data Vault keine Updates gibt. Ich kann nicht ganz nachvollziehen, wie wir das End_Date-Feld in einer Satellite-Tabelle schließen können, ohne tatsächlich ein Update durchzuführen.“

Michael erläutert dazu das Konzept des Soft Delete von Datensätzen und dessen Auswirkungen auf das Datenmanagement sowie die Datenintegrität. Anhand praxisnaher Beispiele verdeutlicht er die Bedeutung von Strategien wie dem Soft-Deleting für die Gewährleistung von Datenkonsistenz und Datenpräzision innerhalb von Satellite-Tabellen.

HL7-FHIR-Ressourcen in Data Vault

Video ansehen

Im Rahmen unserer fortlaufenden Auseinandersetzung mit Data-Vault-Konzepten in der Reihe „Data Vault Friday“ geht unser CEO, Michael Olschimke, auf eine spannende Frage aus unserem Publikum ein:

„Wie würden Sie Daten, die als HL7-FHIR-Ressourcen übertragen werden, in Data Vault modellieren?“

Michael erläutert detailliert die Feinheiten im Umgang mit HL7-FHIR-Ressourcen innerhalb des Data-Vault-Frameworks. Diese Session ist eine wertvolle Informationsquelle für alle, die praxisnahe Einblicke in die effektive Modellierung von Healthcare-Daten suchen, die als HL7-FHIR-Ressourcen vorliegen.

Data Vault auf Databricks

Watch the Video

In unserer fortlaufenden Reihe „Data Vault Friday“ geht unser CEO Michael Olschimke auf eine relevante Frage aus der Community ein und beleuchtet die Diskussion rund um die Kompatibilität von Data Vault 2.0 (DV2.0) mit Databricks.

„Auf LinkedIn gab es eine hitzige Debatte darüber, ob sich DV2.0 für den Einsatz auf Databricks eignet oder nicht. Viele bezweifeln das. Die prägnantesten Einwände lauten: ‚zu viele Joins‘, ‚Performance-Probleme bei der Datenabfrage‘ und ‚ungeeignet für moderne Automatisierung‘. Letzteres bezieht sich auf Werkzeuge, die pro Objekt separaten Code generieren, im Gegensatz zu parametrisierten Pipelines.“

In diesem aufschlussreichen Video vertieft Michael die Diskussion rund um die Eignung von Data Vault 2.0 in der Databricks-Umgebung. Er analysiert die geäußerten Bedenken – insbesondere die vermeintlichen Hürden bei Join-Operationen, der Abfrage-Performance sowie der Vereinbarkeit mit modernen Automatisierungsansätzen.

Dabei liefert Michael eine fundierte und ausgewogene Einschätzung, beleuchtet die feinen Nuancen beim Einsatz von DV2.0 auf Databricks und geht detailliert auf die Kernfragen ein, die in den LinkedIn-Diskussionen aufgeworfen wurden.

Über Information Marts in Data Vault 2.0 – Teil 2

In der Data-Vault-2.0-Architektur werden Information Marts verwendet, um Endanwendern Informationen bereitzustellen. Konzeptionell folgt ein Information Mart derselben Definition wie ein Data Mart im Legacy-Data-Warehousing. Dort wird ein Data Mart jedoch primär dazu genutzt, aufbereitete, nützliche Informationen statt reiner Rohdaten bereitzustellen. Aus diesem Grund wurde der Begriff Data Mart in Data Vault 2.0 in „Information Mart“ umbenannt, um diesen Anwendungszweck noch präziser widerzuspiegeln.

„Klassische“ Information Marts

Die Definition von Information Marts umfasst jedoch noch weitere Facetten. In dem Buch „Building a Scalable Data Warehouse with Data Vault 2.0“ stellen wir drei grundlegende Arten von Marts vor:

  • Information Mart: Dient der Bereitstellung von Informationen für Business-User, typischerweise über Dashboards und Reports.
  • Metrics Mart: Wird in Verbindung mit einem Metrics Vault verwendet, der EDW-Logdaten in einem Data-Vault-Modell erfasst. Der Metrics Mart wird aus dem Metrics Vault abgeleitet, um Metriken darzustellen, mit denen Performance-Engpässe oder der Ressourcenverbrauch von Power-Usern und Data Scientists in Managed-Self-Service-BI-Lösungen analysiert werden können.
  • Error Mart: Speichert diejenigen Datensätze, die beim Laden der Daten in das Enterprise Data Warehouse eine Hard Rule verletzen.

Zusätzliche Information Marts

Zusätzlich zu diesen „klassischen“ Information Marts setzen wir in unserer Beratungspraxis weitere Typen ein:

  • Interface Mart: Dies ist im Grunde ein Information Mart, bei dem die Informationen jedoch nicht an Menschen übermittelt werden (z. B. über ein Dashboard oder einen Report). Stattdessen werden sie an eine nachgelagerte Anwendung oder als Write-Back an das Quellsystem übergeben, beispielsweise wenn das Enterprise Data Warehouse zur Datenbereinigung genutzt wird.
  • Quality Mart: Der Quality Mart ist ebenfalls ein Information Mart, dient jedoch nicht der eigentlichen Bereinigung fehlerhafter Daten, sondern dem Reporting über diese. Im Wesentlichen kehrt er die zur Datenbereinigung genutzte Business-Logik um: Nur fehlerhafte Daten auch „Ugly Data“ genannt, werden an den Endanwender, beispielsweise den Data Steward, übermittelt. Dies geschieht häufig in Verbindung mit Frontends zur Datenbereinigung, in denen der Data Steward entweder Quelldaten korrigieren oder Ausnahmen kommentieren und mit Tags versehen kann.
  • Source Mart: Ein weiterer Information Mart, der jedoch keines der gängigen Schemata wie Star-Schemata, Snowflake-Schemata oder vollständig denormalisierte Schemata verwendet. Stattdessen nutzt der Source Mart das Datenmodell der Quellanwendung, ähnlich dem Schema eines Operational Data Store (ODS). Er ist jedoch keine physische Datenkopie, sondern ein virtualisiertes Modell auf Basis des Data-Vault-Modells, das die ursprünglichen Strukturen abbildet. Er eignet sich hervorragend für das Ad-hoc-Reporting und bietet sowohl Data Scientists als auch Power-Usern einen erheblichen Mehrwert.

Damit ist unsere Übersicht der Information Marts vollständig. Wir setzen diese Typen seit vielen Jahren erfolgreich in Kundenprojekten ein, um den konkreten Nutzen und Einsatz von Information Marts im Unternehmen greifbar zu machen.

Teilen Sie uns gerne in den Kommentaren mit, ob dieser Überblick auch für Ihre Praxis hilfreich ist!