All Posts By

Michael Olschimke

Michael Olschimke is the Co-Founder and CEO of Scalefree and a "Data Vault 2.0 Pioneer" with over 20 years of IT experience. A Fulbright scholar and co-author of Building a Scalable Data Warehouse with Data Vault 2.0, Michael is a global authority on AI, Big Data, and scalable Lakehouse design across sectors like banking, automotive, and state security.

Data Vault auf Databricks

Watch the Video

In unserer fortlaufenden Reihe „Data Vault Friday“ geht unser CEO Michael Olschimke auf eine relevante Frage aus der Community ein und beleuchtet die Diskussion rund um die Kompatibilität von Data Vault 2.0 (DV2.0) mit Databricks.

„Auf LinkedIn gab es eine hitzige Debatte darüber, ob sich DV2.0 für den Einsatz auf Databricks eignet oder nicht. Viele bezweifeln das. Die prägnantesten Einwände lauten: ‚zu viele Joins‘, ‚Performance-Probleme bei der Datenabfrage‘ und ‚ungeeignet für moderne Automatisierung‘. Letzteres bezieht sich auf Werkzeuge, die pro Objekt separaten Code generieren, im Gegensatz zu parametrisierten Pipelines.“

In diesem aufschlussreichen Video vertieft Michael die Diskussion rund um die Eignung von Data Vault 2.0 in der Databricks-Umgebung. Er analysiert die geäußerten Bedenken – insbesondere die vermeintlichen Hürden bei Join-Operationen, der Abfrage-Performance sowie der Vereinbarkeit mit modernen Automatisierungsansätzen.

Dabei liefert Michael eine fundierte und ausgewogene Einschätzung, beleuchtet die feinen Nuancen beim Einsatz von DV2.0 auf Databricks und geht detailliert auf die Kernfragen ein, die in den LinkedIn-Diskussionen aufgeworfen wurden.
Über Information Marts in Data Vault 2.0 – Teil 2

In der Data-Vault-2.0-Architektur werden Information Marts verwendet, um Endanwendern Informationen bereitzustellen. Konzeptionell folgt ein Information Mart derselben Definition wie ein Data Mart im Legacy-Data-Warehousing. Dort wird ein Data Mart jedoch primär dazu genutzt, aufbereitete, nützliche Informationen statt reiner Rohdaten bereitzustellen. Aus diesem Grund wurde der Begriff Data Mart in Data Vault 2.0 in „Information Mart“ umbenannt, um diesen Anwendungszweck noch präziser widerzuspiegeln.

„Klassische“ Information Marts

Die Definition von Information Marts umfasst jedoch noch weitere Facetten. In dem Buch „Building a Scalable Data Warehouse with Data Vault 2.0“ stellen wir drei grundlegende Arten von Marts vor:

  • Information Mart: Dient der Bereitstellung von Informationen für Business-User, typischerweise über Dashboards und Reports.
  • Metrics Mart: Wird in Verbindung mit einem Metrics Vault verwendet, der EDW-Logdaten in einem Data-Vault-Modell erfasst. Der Metrics Mart wird aus dem Metrics Vault abgeleitet, um Metriken darzustellen, mit denen Performance-Engpässe oder der Ressourcenverbrauch von Power-Usern und Data Scientists in Managed-Self-Service-BI-Lösungen analysiert werden können.
  • Error Mart: Speichert diejenigen Datensätze, die beim Laden der Daten in das Enterprise Data Warehouse eine Hard Rule verletzen.

Zusätzliche Information Marts

Zusätzlich zu diesen „klassischen“ Information Marts setzen wir in unserer Beratungspraxis weitere Typen ein:

  • Interface Mart: Dies ist im Grunde ein Information Mart, bei dem die Informationen jedoch nicht an Menschen übermittelt werden (z. B. über ein Dashboard oder einen Report). Stattdessen werden sie an eine nachgelagerte Anwendung oder als Write-Back an das Quellsystem übergeben, beispielsweise wenn das Enterprise Data Warehouse zur Datenbereinigung genutzt wird.
  • Quality Mart: Der Quality Mart ist ebenfalls ein Information Mart, dient jedoch nicht der eigentlichen Bereinigung fehlerhafter Daten, sondern dem Reporting über diese. Im Wesentlichen kehrt er die zur Datenbereinigung genutzte Business-Logik um: Nur fehlerhafte Daten auch „Ugly Data“ genannt, werden an den Endanwender, beispielsweise den Data Steward, übermittelt. Dies geschieht häufig in Verbindung mit Frontends zur Datenbereinigung, in denen der Data Steward entweder Quelldaten korrigieren oder Ausnahmen kommentieren und mit Tags versehen kann.
  • Source Mart: Ein weiterer Information Mart, der jedoch keines der gängigen Schemata wie Star-Schemata, Snowflake-Schemata oder vollständig denormalisierte Schemata verwendet. Stattdessen nutzt der Source Mart das Datenmodell der Quellanwendung, ähnlich dem Schema eines Operational Data Store (ODS). Er ist jedoch keine physische Datenkopie, sondern ein virtualisiertes Modell auf Basis des Data-Vault-Modells, das die ursprünglichen Strukturen abbildet. Er eignet sich hervorragend für das Ad-hoc-Reporting und bietet sowohl Data Scientists als auch Power-Usern einen erheblichen Mehrwert.

Damit ist unsere Übersicht der Information Marts vollständig. Wir setzen diese Typen seit vielen Jahren erfolgreich in Kundenprojekten ein, um den konkreten Nutzen und Einsatz von Information Marts im Unternehmen greifbar zu machen.

Teilen Sie uns gerne in den Kommentaren mit, ob dieser Überblick auch für Ihre Praxis hilfreich ist!

Data Vault 2.0: Best of Breed aus Data Warehousing und Data Lakes

Image of the structure from Data Vault

In der Branche gibt es zwei konkurrierende Ansätze für die Datenanalyse, und die meisten Fachleute tendieren zu einem von beiden: Data Warehousing vs. Data Lake. Dieser Artikel beleuchtet die Unterschiede zwischen den beiden Ansätzen und zeigt auf, wie Data Vault 2.0 eine Best-of-Breed-Lösung bietet, die die Stärken beider Welten in einem einheitlichen Konzept vereint.

Data Warehousing

Data Warehousing ist die traditionelle Unternehmenslösung, um Entscheidungsträgern auf allen Ebenen einer Organisation verlässliche Informationen bereitzustellen. Data-Warehouse-Lösungen basieren auf einem Datenmodell, das traditionell entweder anhand konkreter Informationsanforderungen über einen Bottom-up-Ansatz oder auf Basis eines integrierten Unternehmensdatenmodells über einen Top-down-Ansatz definiert wird.

In beiden Fällen beruht das traditionelle Data Warehouse auf dem „Schema-on-Write“-Prinzip: Das Datenmodell wird bereits beim Laden der Daten festgeschrieben. Dies führt häufig zu einer starren Datenverarbeitung, da jede geschäftliche Veränderung aufwendige Modellanpassungen nach sich zieht.

Data Lakes

Data Lakes hingegen basieren auf dem „Schema-on-Read“-Konzept. Anstatt vorab ein Zielmodell zu entwerfen und Datenstrukturen anzupassen, werden die Daten zunächst unverändert so im Data Lake gespeichert, wie sie aus den Quellsystemen angeliefert werden – ohne vorherige Modellierung.

Während traditionelles Data Warehousing häufig zu einer Übermodellierung und trägen Prozessen führt, birgt der Data-Lake-Ansatz das gegenteilige Risiko: unkontrollierten Datenwuchs und inkonsistente Analyseergebnisse.

Der Best-of-Breed-Ansatz

Beide Ansätze bilden die extremen Enden des Spektrums der Datenanalyse und haben in der Praxis jeweils eigene Herausforderungen offenbart. Mit dem Data Vault 2.0-Standard steht Datenexperten eine moderne dritte Option für den Aufbau von Datenanalyseplattformen zur Verfügung.

Data Vault 2.0 verbindet als Best-of-Breed-Lösung das Beste aus Data Warehousing und Data Lakes: Einerseits nutzt es ein klares Datenmodell zur Strukturierung von Daten und Geschäftslogik wie beim klassischen Data Warehouse, andererseits ermöglicht es bei der Bereitstellung die Flexibilität eines Schema-on-Read-Ansatzes wie bei Data Lakes.

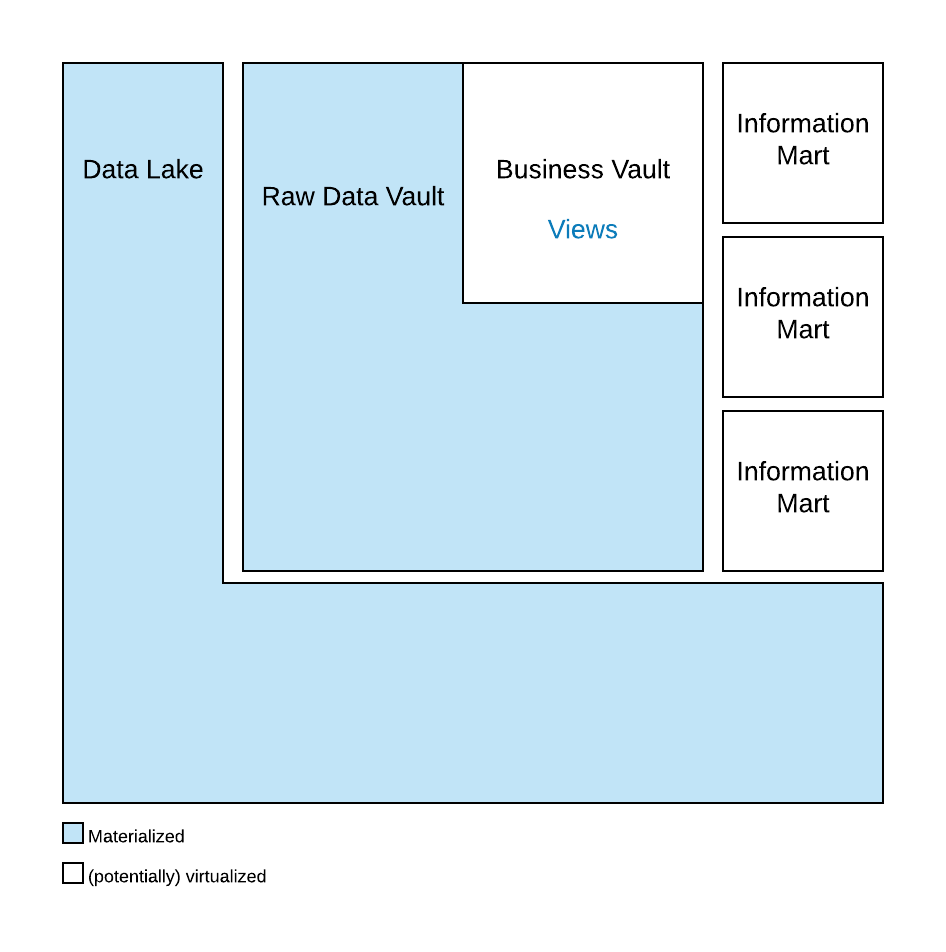
Die Data Vault 2.0-Architektur gliedert sich in mehrere Schichten:

Image of the structure from Data Vault

Die erste Schicht ist die Staging Area: Sie dient der reinen Extraktion der Daten aus den Quellsystemen. Die nächste Schicht ist der Raw Data Vault. Diese Schicht bleibt wie die Staging Area funktional an den Quellen orientiert, führt die Daten jedoch historisiert und integriert zusammen. Dazu wird das eingehende Quelldatenmodell in modulare Komponenten zerlegt: fachliche Schlüssel (gespeichert in Hubs), Beziehungen zwischen diesen Schlüsseln (gespeichert in Links) und beschreibende Kontextdaten (gespeichert in Satellites).


Der Business Vault bildet die darauf aufbauende Schicht, wird jedoch gezielt und sparsam modelliert: Nur dort, wo Geschäftslogik zwingend erforderlich ist, um verwertbare Informationen zu erzeugen, wird eine Business-Vault-Entität implementiert. Der Business Vault schließt die Lücke zwischen den Rohdaten und dem finalen Informationsmodell. Entsprechen Rohdaten hinsichtlich Datenqualität, Vollständigkeit oder Formatierung noch nicht den Anforderungen der Fachbereiche, wird hier die entsprechende Berechnungs- und Transformationslogik angewendet.

Die letzte Schicht bildet der Information Mart. Hier wird das eigentliche Zielmodell erzeugt, um die Daten im gewünschten Format bereitzustellen, beispielsweise als dimensionales Star-Schema. Fachanwender greifen auf diese Schicht entweder direkt über Ad-hoc-Abfragen oder über Business-Intelligence-Tools wie Dashboarding- und Reporting-Software zu.

Die Schichten bis hin zum Raw Data Vault bleiben quellsystemnah, da sich das Modell entweder direkt aus den Quellsystemen ableitet oder durch die Normalisierung in Hubs, Links und Satellites entsteht. Das fachliche Zielschema greift erst auf der Ebene des Information Marts. Da diese Schicht häufig über SQL-Views virtualisiert wird, erfolgt die Transformation zur Laufzeit der Abfrage. Abfragen auf die Views greifen direkt auf die materialisierten Daten im Raw Data Vault zu. Somit setzt Data Vault 2.0 das Schema-on-Read-Prinzip optimal in die Praxis um.

Data Vault 2.0 gewährleistet maximale Agilität: Das Konzept hat sich in zahlreichen Projekten bewährt und lässt sich flexibel erweitern, ganz gleich, ob sich Quellsystemstrukturen ändern, Geschäftsregeln angepasst werden müssen oder neue Informationsanforderungen entstehen. Zusätzliche Datenquellen und Geschäftsregeln können jederzeit ohne Ausfallzeiten integriert werden.

Zudem lässt sich das Data Vault 2.0-Modell nahtlos mit einem Data Lake kombinieren: Ein Data Lake kann für Staging-Zwecke genutzt werden, was der empfohlenen hybriden Architektur für moderne Projekte bei Scalefree entspricht. Ebenso eignet sich der Data Lake, um semi-strukturierte oder unstrukturierte Daten für das Enterprise Data Warehouse aufzunehmen oder spezielle Information Marts zu speisen.

Dadurch vereint Data Vault 2.0 als Best-of-Breed-Ansatz die Stärken des traditionellen Data Warehouse mit der Agilität des Data Lake. Unternehmen jeder Größenordnung profitieren so von einer skalierbaren und zukunftssicheren Datenanalyseplattform.

Lambda-Architektur vs. Data Vault 2.0-Architektur

Video ansehen

In unserer fortlaufenden Reihe „Data Vault Friday“ widmet sich unser CEO Michael Olschimke einer Frage zum Vergleich zwischen der Data Vault 2.0-Architektur und der Lambda-Architektur für Echtzeitsysteme:

„Wir vergleichen derzeit die Data Vault 2.0-Architektur mit der Lambda-Architektur für Echtzeitsysteme. Können Sie die Gemeinsamkeiten und Unterschiede näher erläutern?“

In diesem aufschlussreichen Video analysiert Michael detailliert die Unterschiede und Gemeinsamkeiten beider Ansätze. Sie erhalten wertvolle Einblicke in die jeweiligen Konzepte, Stärken und Einsatzbereiche, die Sie bei einer fundierten Entscheidungsfindung für die Implementierung Ihrer Echtzeitsysteme unterstützen.

Nicht-funktionale Anforderungen

Nicht-funktionale Anforderungen im Data Warehouse

Ein Enterprise Data Warehouse besteht aus mehr als nur Berichten und Dashboards. Neben den sichtbaren Funktionen müssen zahlreiche technische Grundlagen geschaffen werden, die als nicht-funktionale Anforderungen bezeichnet werden.

Warum nicht-funktionale Anforderungen wichtig sind

In unseren Schulungen und Beratungsprojekten empfehlen wir häufig, den Fokus konsequent auf den geschäftlichen Mehrwert (Business Value) zu legen. Mehrwert im Enterprise Data Warehousing ist definiert als „etwas von Wert für das Unternehmen“ – ob Sie es glauben oder nicht, das muss gelegentlich betont werden.

Typischerweise stellen Unternehmen ein Budget für das Enterprise Data Warehouse bereit, weil sie Berichte oder Dashboards mit handlungsrelevanten Informationen benötigen. Dem steht jedoch das Argument gegenüber, dass ein Enterprise Data Warehouse weit mehr umfasst als reine Berichte und Dashboards. In der Praxis müssen viele weitere technische Komponenten und Anforderungen umgesetzt werden, darunter: Continue Reading