All Posts By

Tim Kirschke

Tim Kirschke is a Managing BI Consultant and Head of Internal Development at Scalefree. With a background in Applied Mathematics, he specializes in architecting auditable data solutions using Microsoft Fabric, Snowflake, and dbt. A dbt Certified Architect and CDVP2, Tim has led major warehouse implementations and conducts strategic workshops on data automation and enablement.

Data Streaming in Snowflake

Data Streaming in Snowflake

In diesem Newsletter geben wir Ihnen einen Überblick über die Möglichkeiten des Datenstreamings mit Snowflake.

Die hier vorgestellten Ansätze konzentrieren sich darauf, wie die Funktionen und Leistungsmerkmale von Snowflake die Ingestion und Verarbeitung von Datenströmen mit hoher Geschwindigkeit ermöglichen. Ziel ist es, aufzuzeigen, wie Unternehmen sich durch die Nutzung von Echtzeitdaten einen Wettbewerbsvorteil verschaffen können, um zeitkritische Entscheidungen zu treffen, die betriebliche Effizienz zu steigern und das Kundenerlebnis zu verbessern. Darüber hinaus untersuchen wir die Architektur von Snowflake als verlässliche Lösungsgrundlage, ihre Eignung für Streaming-Workloads sowie die Herausforderungen, die sie adressiert.

Data Streaming in Snowflake

In diesem Webinar am 11. Februar 2025 um 11:00 Uhr MEZ erfahren Sie, wie Sie datengestützte Entscheidungen mithilfe der Echtzeitdaten-Funktionen von Snowflake beschleunigen können. Lernen Sie, wie Sie Batch- und Streaming-Datenpipelines vereinheitlichen, um große Datenmengen mit Snowpipe Streaming, Hybrid Tables und Dynamic Tables zu verarbeiten. Entdecken Sie, wie Sie Erkenntnisse mit geringer Latenz gewinnen und schnellere Entscheidungen treffen, ohne Ihre bestehenden Prozesse zu beeinträchtigen. Wir beleuchten Praxisbeispiele dafür, wie andere Unternehmen Echtzeitdaten für Dashboards, Customer Experiences und mehr nutzen, ergänzt durch Best Practices zur Sicherstellung von Datenqualität und Performance. Diese Session ist ideal für Data Engineers und Architekten geeignet und zeigt Ihnen, wie Snowflake Ihre Analytik revolutionieren und Sie in der dynamischen digitalen Welt von heute voranbringen kann.

Watch Webinar Recording

Was Sie erwartet

Sie erhalten einen Überblick über die verschiedenen integrierten Tools und Techniken, die Snowflake für das Real-Time-Data-Streaming bereitstellt, einschließlich der Funktionen für Dateningestion, -verarbeitung und -abfrage. Wir behandeln die Architekturkomponenten von Snowflake wie Tabellen, Views und Verarbeitungsfunktionen und untersuchen, wie diese zur Verwaltung transaktionaler Workloads eingesetzt werden.

Der Schwerpunkt dieses Beitrags liegt darauf, Einblicke zu vermitteln, wie Snowflake die Echtzeit-Datenverarbeitung ermöglicht, welche Chancen sich daraus ergeben und welche Kompromisse bei der Implementierung von Streaming-Lösungen zu berücksichtigen sind.

Echtzeitdaten – ein Überblick

Echtzeitdaten ermöglichen es Unternehmen, Informationen unmittelbar nach deren Erzeugung zu verarbeiten. Im Gegensatz zur traditionellen Batch-Verarbeitung, die in festen Intervallen erfolgt, fließen Echtzeitdaten kontinuierlich und ermöglichen so dynamische und unmittelbare Maßnahmen. Diese Form der Datenverarbeitung gewinnt für Organisationen, die in einem schnelllebigen Markt wettbewerbsfähig bleiben wollen, zunehmend an Bedeutung.

Wichtigste Merkmale von Echtzeitdaten

Echtzeitdaten weisen charakteristische Merkmale auf, die sie von anderen Datenflüssen unterscheiden:

  • Hohe Geschwindigkeit (High Velocity): Daten werden mit hoher Geschwindigkeit verarbeitet, oft innerhalb von Millisekunden oder Sekunden.
  • Geringe Latenz (Low Latency): Systeme sind darauf ausgelegt, Verzögerungen zu minimieren und einen zeitnahen Zugriff auf Erkenntnisse zu gewährleisten.
  • Dynamische Datenströme (Dynamic Streams): Kontinuierliche und oft unvorhersehbare Datenströme erfordern eine flexible und skalierbare Verarbeitung.

Jedes dieser Merkmale bringt eigene Vorteile und Herausforderungen mit sich. Aus diesem Grund benötigen Unternehmen spezialisierte Tools und Plattformen, um Echtzeitdaten effektiv zu handhaben.

Warum Echtzeitdaten wichtig sind

Der Wert von Echtzeitdaten liegt in ihrer Fähigkeit, unmittelbare Erkenntnisse zu liefern, die es Unternehmen ermöglichen, ohne Verzögerung zu handeln. Sie können verschiedene Geschäftsbereiche maßgeblich verbessern, wie etwa:

  • Verbesserte Entscheidungsfindung: Echtzeit-Erkenntnisse ermöglichen proaktive Reaktionen, wie beispielsweise die dynamische Anpassung von Preisen oder Lagerbeständen basierend auf der aktuellen Nachfrage
  • Personalisierte Customer Experience: Durch die Analyse des Nutzerverhaltens in Echtzeit können Unternehmen maßgeschneiderte Erlebnisse bieten, die den Kundenerwartungen im jeweiligen Moment entsprechen.
  • Operative Effizienz: Kontinuierliches Monitoring hilft Unternehmen dabei, Probleme frühzeitig zu erkennen und zu beheben, was Ausfallzeiten reduziert und die Performance optimiert.
  • Risiko- und Betrugserkennung (Fraud Detection): Die schnelle Identifizierung von Anomalien oder Bedrohungen verringert die Anfälligkeit für Betrug und operative Risiken.

Die Vorteile von Echtzeitdaten liegen auf der Hand; ihre Implementierung bringt jedoch spezifische Herausforderungen mit sich, die im Folgenden detailliert beschrieben werden.

Herausforderungen bei Echtzeitdaten

Obwohl die Vorteile von Echtzeitdaten beträchtlich sind, gehen sie mit einer Reihe spezifischer Herausforderungen einher:

  • Bewältigung von Geschwindigkeit und Datenvolumen: Die Verarbeitung großer Datenströme bei hoher Geschwindigkeit erfordert hochgradig skalierbare Systeme.
  • Sicherstellung der Konsistenz: Die Gewährleistung der Datengenauigkeit über verteilte Systeme hinweg kann komplex sein, insbesondere bei der Einbindung mehrerer Datenquellen.
  • Integrationskomplexität: Echtzeitdaten müssen häufig mit Batch-Systemen oder bestehenden Legacy-Analyselösungen kombiniert werden, was zusätzliche technische Komplexität mit sich bringt.

Der kontinuierliche Fluss und die Unmittelbarkeit von Echtzeitdaten machen sie unverzichtbar für Unternehmen, die in ihrer Branche eine Vorreiterrolle einnehmen wollen. Mit den richtigen Tools und der passenden Architektur können Organisationen dieses Potenzial erschließen und sich einen entscheidenden Wettbewerbsvorteil sichern.

Echtzeitdaten in Snowflake

Snowflake bietet einen modernen Ansatz für den Umgang mit Echtzeitdaten, indem es seine cloudnative Architektur mit Funktionen für die kontinuierliche Ingestion, Verarbeitung und Abfrage kombiniert. Mit nativen Tools wie Snowpipe, Streams und Tasks ermöglicht Snowflake Unternehmen die Integration von Echtzeitdaten. In diesem Abschnitt untersuchen wir, wie Snowflake Echtzeitdaten verwaltet und welche Möglichkeiten die Plattform bietet, um den Anforderungen von Streaming-Workloads gerecht zu werden.

Die Architektur von Snowflake für Echtzeitdaten

Die Architektur von Snowflake kombiniert Shared-Disk- und Shared-Nothing-Konzepte. Sie nutzt ein zentrales, cloudbasiertes Daten-Repository (die „Shared-Disk“-Komponente), während Rechenressourcen (Virtual Warehouses) unabhängig voneinander skalieren und Daten parallel verarbeiten (der „Shared-Nothing“-Aspekt).

  • Batch: Traditionell laden Data Engineers große Datenmengen mittels COPY-Befehl oder über geplante Ladevorgänge in Batches in Snowflake. Die Compute-Ebene skaliert für rechenintensive Lasten hoch und anschließend zur Kostenoptimierung wieder herunter.
  • Real Time: Die kontinuierliche Ingestion konzentriert sich auf kleine, häufig eintreffende Datenmengen. Auch hier profitiert die Architektur von der Trennung von Storage und Compute, sodass Snowflake Echtzeit-Feeds verarbeiten kann, ohne Batch-Workloads oder Analyseabfragen zu blockieren.

Micro-Partitions

Snowflake unterteilt Tabellen automatisch in Micro-Partitions – kompakte Speichereinheiten, die Daten basierend auf ihrer natürlichen Reihenfolge oder Lademustern gruppieren.

  • Batch: Micro-Partitions spielen ihre Stärken bei großen analytischen Abfragen aus, da Snowflake irrelevante Partitionen schnell ausschließen kann (Pruning), was die Performance umfangreicher Abfragen deutlich steigert.
  • Real Time: Häufige Ladevorgänge erzeugen eine größere Anzahl an Micro-Partitions. Die feingranulare Struktur bleibt zwar vorteilhaft, Sie müssen jedoch einen etwas höheren Overhead bei der Partitionsverwaltung einplanen, insbesondere dann, wenn Ihre Echtzeit-Datenströme extrem hohe Volumina erzeugen.

Dynamic Tables und Hybrid Tables

Apropos Tabellen: Die folgenden beiden Entitäten sind besonders hilfreich, wenn es um die Verarbeitung von Echtzeitdaten in Snowflake geht.

Dynamic Tables ermöglichen es Ihnen, kontinuierliche Transformationen direkt in Snowflake zu definieren. Sie ähneln Materialized Views, sind jedoch flexibler und in der Lage, komplexe Transformationen und Abhängigkeiten zu verarbeiten. Sie definieren über eine SQL-Abfrage, wie die Tabelle aufgebaut werden soll, und Snowflake verarbeitet inkrementelle Änderungen aus den Quelltabellen automatisch im Hintergrund.

  • Inkrementelle Datenverarbeitung: Anstatt Ad-hoc- oder zeitgesteuerte Jobs auszuführen, aktualisieren sich Dynamic Tables automatisch, sobald neue Daten eintreffen. Sie können einen Ziel-Lag (Target Lag) festlegen, indem Sie eine Aktualisierungsdauer angeben oder eine Downstream-Abhängigkeit definieren. Bei einer Downstream-Abhängigkeit bestimmt die letzte Dynamic Table, wann die Daten aktualisiert werden müssen.
  • Kontinuierliche Pipelines: Sie reduzieren den Bedarf an manueller Orchestrierung über Snowflake Tasks oder externe Job-Scheduler.
  • Komplexe Transformationen: Im Gegensatz zu Materialized Views (die sich meist für einfachere Aggregationen eignen) unterstützen Dynamic Tables Joins, Window-Funktionen und weitere erweiterte SQL-Operationen.


Hybrid Tables sind ein neueres Konzept, das Snowflakes spaltenbasierten Micro-Partition-Speicher mit zeilenorientierten Funktionen verbindet. Dadurch lassen sich schnelle Inserts oder Updates mit hohem Volumen einfacher durchführen. Ziel ist es, sowohl analytische (OLAP) als auch transaktionale (OLTP-ähnliche) Workloads in einer einzigen Snowflake-Umgebung zu unterstützen.

  • Schnellere Operationen auf Zeilenebene: Herkömmliche Snowflake-Tabellen können Inserts und Updates zwar in großem Umfang verarbeiten, sind jedoch primär für analytische Lesezugriffe optimiert. Hybrid Tables machen Operationen auf Zeilenebene effizienter.
  • Unterstützung gemischter Workloads (Mixed Workloads): Kombinieren Sie die Echtzeit-Ingestion von Events (die häufig zeilenbasierten Datenbanken zugeordnet wird) mit analytischen Abfragen (bei denen spaltenbasierter Speicher seine Stärken voll ausspielt).
  • Geringere Latenz: Durch die verbesserte Verarbeitung kleiner Transaktionen und häufiger Datenänderungen tragen Hybrid Tables dazu bei, die Zeitspanne zu verkürzen, bis neue Daten für Abfragen bereitstehen.

Snowpipe und Snowpipe Streaming

Snowpipe ist der kontinuierliche Dateningestion-Dienst von Snowflake, der Daten aus externen oder internen Stages lädt. Typischerweise wird Snowpipe mit einem Cloud-Speicherort (z. B. Amazon S3) verknüpft, an dem neue Dateien eingehen, und importiert diese automatisch.

  • Klassischer Batch-Betrieb: Der COPY-Befehl wird häufig in festen Intervallen ausgeführt (z. B. stündlich oder täglich), was zu Latenzen führen kann.
  • Snowpipe: Anstatt auf einen geplanten Batch-Lauf zu warten, lädt Snowpipe kleinere Datei-Inkremente automatisch kurz nach deren Eintreffen in der Stage. Dadurch verkürzt sich die Zeitspanne zwischen der Datengenerierung und der Verfügbarkeit für Abfragen.

Allerdings ist Snowpipe für das kontinuierliche Laden kleiner Dateien optimiert, man kann sich dies als Micro-Batches anstelle großer Einzeldateien vorstellen. Sollte Ihr Datenvolumen sprunghaft ansteigen, können höhere Kosten entstehen oder ein Wechsel der Ingestion-Strategie erforderlich sein, um den Durchsatz aufrechtzuerhalten.

Snowpipe Streaming ist ein API-basierter Ansatz, der Daten direkt in Snowflake-Tabellen schreibt und Zwischenspeicher vollständig umgeht. Dadurch lassen sich Latenzzeiten und Ladedauern im Vergleich zu Standard-Snowpipe noch weiter reduzieren.

Warum ist das „noch mehr Echtzeit“? Die Daten treffen sofort (oder nahezu verzögerungsfrei) in Snowflake ein und ermöglichen so ein Near-Real-Time-Reporting. Sie müssen nicht mehr warten, bis Batch-Dateien im Cloud-Speicher abgelegt werden, und der Ansatz ist bei entsprechender Skalierung oft kosteneffizienter – insbesondere bei hochfrequenten, kleinen Datenereignissen.

Zudem unterstützt der Snowflake Connector for Apache Kafka Snowpipe Streaming, was einen nahezu nahtlosen Fluss von Nachrichten aus Kafka-Topics direkt in Snowflake-Tabellen ermöglicht. Diese Integration ist ein entscheidender Schritt, um die Lücke zwischen Streaming-Datenplattformen und dem Cloud Data Warehouse von Snowflake zu schließen.

Snowflake Streams

Schließlich erfasst ein Snowflake „Stream“ Änderungen an einer Tabelle (Inserts, Updates und Deletes). Dies ist besonders nützlich für Change-Data-Capture-Workflows (CDC) und ermöglicht eine effiziente Verarbeitung von Echtzeitdaten.
Sie können Pipelines erstellen, die auf diese CDC-Streams reagieren und nachgelagerte Transformationen oder Prozesse anstoßen. Dies eignet sich ideal für Szenarien, in denen Aktualisierungen von Echtzeitdaten in transaktionale oder operative Systeme einfließen müssen.

Grenzen und Möglichkeiten von Echtzeitdaten in Snowflake

Nachdem wir einige Schlüsselfaktoren aufgeschlüsselt haben, betrachten wir nun verschiedene Grenzen und Möglichkeiten bei der Arbeit mit Snowflake und Echtzeitdaten.

Obwohl Snowflake auf eine Verarbeitung nahezu in Echtzeit (Near Real Time) abzielt, ist es nicht als Event-Processing-Engine für den Subsekundenbereich mit Ultra-Low-Latency konzipiert. Eine schnelle, kontinuierliche Ingestion kann die Kosten in die Höhe treiben, wenn Warehouse-Dimensionierung und Auto-Suspend-Einstellungen nicht sorgfältig konfiguriert sind. Jedes Warehouse und jede Streaming-Komponente kann bei häufigen Abfragen und Ladevorgängen Kosten verursachen.

Das Monitoring mehrerer Datenströme sowie deren Skalierung und Durchsatzsteuerung können komplex sein. Sie benötigen solide DevOps- und DataOps-Praktiken, um die Datenintegrität und eine gleichbleibende Performance sicherzustellen.

Auf der anderen Seite können Sie Echtzeit-Dashboards und Analysen realisieren. Mit Snowpipe Streaming und dem Kafka-Connector können Sie Daten direkt in Snowflake einspeisen und Dashboards betreiben, die sich innerhalb von Sekunden oder Minuten aktualisieren. CDC-Streams ermöglichen ereignisgesteuerte Pipelines, bei denen Änderungen in Ihren transaktionalen Datenbanken sofortige Aktionen in Snowflake auslösen – etwa nachgelagerte Transformationen oder Warnmeldungen. Die Trennung von Storage und Compute in Snowflake erleichtert den Umgang mit Lastspitzen (Spiky Workloads). Echtzeit-Pipelines können unabhängig von anderen Batch- oder Analyseaufgaben hochskaliert werden, was eine reibungslose parallele Verarbeitung gewährleistet.

Viele Unternehmen kombinieren Echtzeit-Datenströme mit traditionellen Batch-Ladevorgängen. Die Architektur von Snowflake kann beide Ansätze problemlos und ohne Konflikte parallel bedienen.

Fazit

Durch das Zusammenspiel von Hybrid Tables für zeilenbasierte Schreibzugriffe, Snowpipe Streaming für die Ingestion nahezu in Echtzeit, Snowflake Streams für die kontinuierliche Änderungserkennung und Dynamic Tables für automatisierte Transformationen können Unternehmen Echtzeit-Datenflüsse auf Basis ihrer bestehenden Batch-Architektur etablieren. Dieses Zusammenspiel der Snowflake-Funktionen eröffnet die Möglichkeit, Daten mit hoher Geschwindigkeit zu erfassen und fast unmittelbar zu verarbeiten. Dadurch erhalten Entscheidungsträger Zugriff auf Live-Metriken, können Kundeninteraktionen in Echtzeit personalisieren, operative Prozesse optimieren und Anomalien oder Betrugsfälle mit minimaler Verzögerung aufdecken. In Kombination mit der standardmäßigen Batch-Ingestion bewahrt diese Architektur historische Daten und groß angelegte Analysen und ergänzt diese um eine Schicht für latenzarme, ereignisgesteuerte Erkenntnisse.

Es gibt jedoch auch Herausforderungen und Einschränkungen zu beachten. Häufigere Schreibvorgänge können die Compute-Kosten in die Höhe treiben, insbesondere dann, wenn Daten mit unvorhersehbarem Volumen und unbeständiger Geschwindigkeit eintreffen. Die Gewährleistung konsistenter Datenmodelle wird anspruchsvoller, wenn sich Schemata schnell ändern, da Echtzeit-Pipelines mit Anpassungen in den Quellsystemen Schritt halten müssen. Hybrid Tables eignen sich zwar hervorragend für schnelle Inserts, liefern bei umfangreichen analytischen Workloads jedoch unter Umständen nicht dieselbe Abfrage-Performance wie spaltenbasierte Tabellen. Ebenso kann der Kostenaufwand für permanent aktive Streaming-Pipelines erheblich sein, wenn diese nicht sorgfältig dimensioniert und überwacht werden. Zudem steigt die Komplexität mit der Anzahl der beweglichen Teile, weshalb ein robustes DataOps- oder DevOps-Framework unerlässlich ist, um Ingestion, Transformation und Monitoring über verschiedene Verarbeitungsmodi hinweg zu steuern.

Dennoch lässt sich die Integration dieser Echtzeit-Funktionen in eine bestehende Batch-Loading-Architektur schrittweise umsetzen: indem eine dedizierte Echtzeit-Pipeline eingerichtet wird, die parallel zu den traditionellen Bulk-Loads in Snowflake einspeist. Die neue Pipeline könnte Event-Daten mittels Snowpipe Streaming erfassen und zunächst in Hybrid Tables speichern, wo Streams und Dynamic Tables Änderungen nahezu in Echtzeit verarbeiten. Historische Datenladevorgänge und rechenintensive analytische Abfragen würden weiterhin den bestehenden Batch-Ansatz mit spaltenbasierten, mikropartitionierten Tabellen nutzen. Im Laufe der Zeit können Teams beide Ansätze auf der Consumption-Ebene zusammenführen, sei es in BI-Dashboards, ML-Pipelines oder operativer Analytik, um die Unmittelbarkeit von Echtzeitdaten mit der Tiefe historischer Kontexte zu verbinden und das alles innerhalb desselben Snowflake-Ökosystems.
dbt Semantic Layer – Vereinheitlichen Sie Ihr Datenverständnis

dbt_semantic_layer_lineage

dbt Semantic Layer

Je größer ein Unternehmen wird, desto mehr Daten stehen zur Verfügung und desto mehr Anwender möchten diese Daten nutzen. In einer traditionellen Data-Warehouse-Umgebung (DWH) stellt das DWH typischerweise einen Consumption Layer bereit. Dieser besteht aus verschiedenen Information Marts, die anschließend in mehrere Business-Intelligence-Tools (BI) geladen werden. Dort transformieren und aggregieren Geschäftsanwender die Daten, um KPIs zu berechnen und fundierte Geschäftsentscheidungen zu treffen.

Dies ist jedoch oft leichter gesagt als getan: Um aussagekräftige KPIs aus den Daten abzuleiten, benötigen Geschäftsanwender ein gemeinsames Verständnis der vom DWH bereitgestellten Informationen. Häufig sind die dafür notwendigen Dokumentationen jedoch schwer auffindbar und nicht an einem zentralen Ort zugänglich.

Dies kann letztlich dazu führen, dass verschiedene Abteilungen dieselben Daten unterschiedlich interpretieren und abweichende Werte für denselben KPI ableiten. Im schlimmsten Fall schwindet so das Vertrauen in die eigenen Daten. Genau hier setzt ein einheitlicher Semantic Layer an.

Von den Rohdaten zum Semantic Layer – mit Turbovault und dbt Cloud

Data Vault ist aufgrund seiner Anpassungsfähigkeit und Skalierbarkeit für Unternehmen bei der Verwaltung dynamischer Datenumgebungen unverzichtbar. Die Hub-and-Spoke-Architektur gewährleistet Nachvollziehbarkeit sowie Agilität und ermöglicht eine schnelle Anpassung an sich ändernde Anforderungen und unterschiedlichste Datenquellen.

Nehmen Sie an unserem Webinar teil und erfahren Sie, wie Sie dbt Cloud gemeinsam mit Turbovault und einem Datenmodellierungstool einsetzen, um Data Vault in Ihrem Unternehmen erfolgreich zu implementieren. Darüber hinaus werfen wir einen detaillierten Blick auf den dbt Semantic Layer.

Watch Webinar Recording

Komponenten des dbt Semantic Layer

Der dbt Semantic Layer vereinfacht die Definition und Nutzung kritischer Geschäftskennzahlen in Ihrem dbt-Projekt. Metrikdefinitionen werden zentralisiert, um eine konsistente Self-Service-Nutzung für alle Datenteams zu gewährleisten.

Durch die Verlagerung der Metrikdefinitionen von der BI-Ebene in die Modellierungsebene können Geschäftsanwender verschiedener Abteilungen darauf vertrauen, stets dieselbe Definition zu verwenden, unabhängig vom eingesetzten Tool. Ändert sich eine Metrikdefinition im Laufe der Zeit, wird diese Änderung automatisch an allen Verwendungsstellen übernommen, was durchgängige Konsistenz garantiert.

Um einen einheitlichen Semantic Layer innerhalb Ihres dbt-Projekts aufzubauen, sind folgende Schritte erforderlich:

  1. Ein semantisches Modell entwerfen
    • Vor der Implementierung muss das semantische Modell konzipiert werden. Dies geschieht idealerweise in enger Zusammenarbeit zwischen den technischen Teams und den Fachabteilungen, um zentrale Geschäftskonzepte und deren Beziehungen zueinander eindeutig zu identifizieren.
  2. dbt-Modelle erstellen, die Ihrem semantischen Modell entsprechen
    • Jedes Objekt Ihres semantischen Modells sollte 1:1 in ein dbt-Modell überführt werden. Achten Sie bei der Erstellung besonders darauf, Spaltennamen an einheitlichen Namensstandards auszurichten und die Ladelogik fehlerfrei zu entwickeln.
  3. Neue .yml-Dateien im Ordner „metrics“ anlegen
    • Alle Konfigurationen, die den dbt Semantic Layer betreffen, werden in einem dedizierten Ordner namens „metrics“ abgelegt. Dort dienen .yml-Dateien der Definition Ihrer semantischen Modelle. Wir empfehlen, pro semantischem Modell eine eigene .yml-Datei anzulegen.
  4. Entities definieren
    • Entities im semantischen Modell beschreiben im Wesentlichen die Schlüsselspalten semantischer Modelle. Entities können vier verschiedene Typen aufweisen: Primary, Unique, Foreign oder Natural. Jedes Modell muss eine Primary Entity besitzen, wobei eine Entity aus einer einzelnen Spalte oder einem transformierenden SQL-Ausdruck bestehen kann.
  5. Dimensions definieren
    • Eine Dimension im dbt Semantic Layer entspricht einer Betrachtungsweise Ihres Modells, also der Gruppierung von Daten nach einem bestimmten Attribut. Jede Dimension muss an eine Primary Entity gekoppelt sein, die für die Gruppierung herangezogen wird. Ein klassisches Beispiel ist eine Datumsspalte, mit der Sie Ihre Daten nach Tag, Monat oder Jahr gruppieren.
  6. Measures definieren
    • Measures stellen Aggregationen dar, die auf bestimmte Spalten in Ihrem Datenmodell angewendet werden. Measures können in anderen Measures wiederverwendet werden, um komplexere Kennzahlen zu berechnen. Zudem lassen sie sich mit verschiedenen Parametern konfigurieren, die bei der Generierung von ausführbarem SQL-Code unterstützen.
  7. Metrics definieren
    • Metrics bilden die eigentliche Sprache der Geschäftsanwender ab. Sie können verschiedene Typen aufweisen, die unterschiedliche Berechnungsarten repräsentieren – beispielsweise Conversion Metrics, Cumulative Metrics, Derived Metrics und Ratio Metrics. Sie bauen stets auf Measures auf und bilden den finalen Baustein des Semantic Layer.


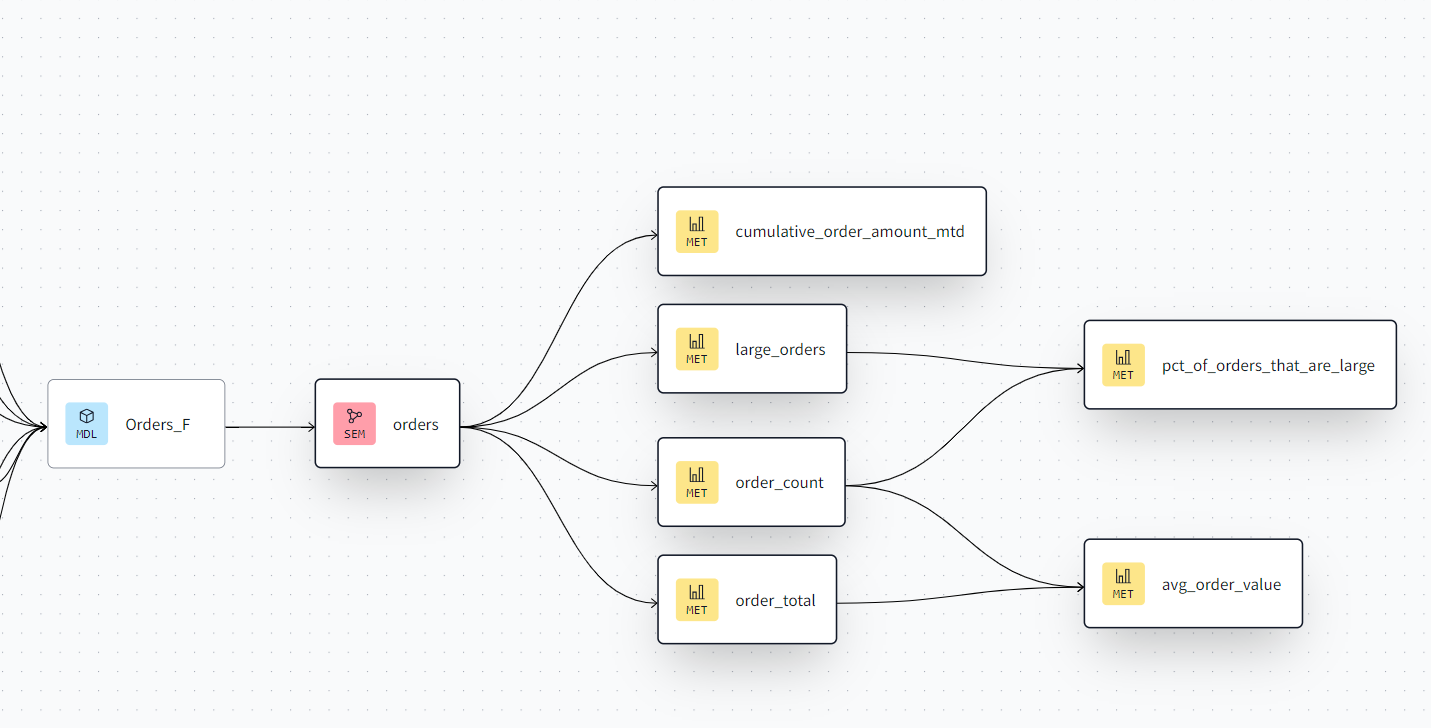
So wird der Semantic Layer in Ihrer dbt-Lineage dargestellt:

Nutzung des dbt Semantic Layer

Sobald ein Semantic Layer in Ihrem dbt-Projekt definiert ist, kann dieser für Datenkonsumenten freigegeben werden. Der dbt Semantic Layer ermöglicht es unterschiedlichen BI-Tools, sich direkt mit Ihrem dbt-Cloud-Projekt zu verbinden und Metrics, Measures sowie Filter unmittelbar im jeweiligen Tool bereitzustellen.

Folgende Tools werden bereits nativ unterstützt:

  • Tableau
  • Google Sheets
  • Microsoft Excel
  • Hex
  • Klipfolio PowerMetrics
  • Lightdash
  • Mode
  • Push.ai
  • Steep

Weitere Tools lassen sich über benutzerdefinierte Integrationen anbinden, sofern sie generische JDBC-Verbindungen unterstützen und mit Arrow Flight SQL kompatibel sind.

Fazit

Der dbt Semantic Layer hilft dabei, das Vertrauen in Ihr Data Warehouse nachhaltig zu stärken. Durch die Verlagerung von Berechnungslogiken aus den Fachabteilungen zurück in das Datenmodell wird eine verlässliche, unternehmensweit einheitliche Definition aller Business-KPIs geschaffen.

Auch wenn die Implementierung eines Semantic Layer einen gewissen Initialaufwand erfordert, steigert sie den geschäftlichen Nutzen Ihrer Daten erheblich. Die direkte Integration in die gewohnten BI-Tools Ihrer Geschäftsanwender vereinfacht den Datenzugriff und die Datenanalyse spürbar.

Wenn Sie mehr über den dbt Semantic Layer erfahren möchten und wissen wollen, wie er sich optimal in ein auf Data Vault 2.0 basierendes Data Warehouse einfügt, nehmen Sie an unserem nächsten Webinar am 13. August teil!

Skalieren Sie Ihr Data Vault-Projekt – mit dbt Mesh

dbt Mesh - data mesh solution

dbt Mesh

Erfahren Sie, wie dbt Mesh Data Vault-Projekte in dbt Cloud optimiert, indem es eine effizientere Data Mesh-Architektur ermöglicht. Je größer ein Data-Warehouse-Projekt wird, desto mehr Personen verlassen sich auf die bereitgestellten Daten und arbeiten mit ihnen. Diese Arbeit kann im Anwenden von Geschäftsregeln, dem Modellieren von Fakten und Dimensionen oder anderen typischen Aufgaben innerhalb einer Datenumgebung bestehen. In einer großen Organisation verteilt sich diese Nutzerschaft oft über verschiedene Abteilungen, und die verarbeiteten Daten gehören möglicherweise zu unterschiedlichen Fachbereichen (Business Domains). An einem bestimmten Punkt steht die gesamte Organisation vor der Herausforderung, Data-Sharing- und Governance-Richtlinien umzusetzen, die beispielsweise verhindern, dass Benutzer aus der Vertriebsabteilung auf Daten der Finanzabteilung zugreifen. Ein Data Mesh bietet hierfür eine passende Lösung, die Organisationen bei der Bewältigung dieser Herausforderungen unterstützt. Wenn Sie mehr über Data Mesh erfahren möchten, lesen Sie hier unseren neuesten Blogartikel über Data Vault und Data Mesh hier.

Wir bieten außerdem ein Webinar genau zu diesem Thema an. Verpassen Sie es nicht und sehen Sie sich die Aufzeichnung kostenlos an!

Data Mesh-Unterstützung in dbt Cloud

Viele Organisationen tun sich schwer damit, einen Data Mesh-Ansatz in ihre Data Vault-Landschaft einzuführen. In diesem Webinar tauchen wir tief in dbt Mesh ein und zeigen Ihnen, wie Sie es in einem Data Vault-Projekt gewinnbringend einsetzen können.

Watch Webinar Recording

Was ist dbt Mesh?

dbt Mesh ist eine Funktion, mit der dbt Cloud noch effizienter mit einem Data Mesh-Ansatz funktioniert. Die bereits bekannte {{ ref() }}-Funktion ist nicht mehr nur auf Modelle innerhalb eines einzelnen dbt-Projekts beschränkt, sondern kann nun auch auf Modelle anderer dbt-Projekte verweisen.

Warum sollten Sie auf andere dbt-Projekte verweisen?

Stellen Sie sich eine große Organisation vor, die dbt Cloud für ihre Data Vault-Implementierung nutzt. Das Projekt umfasst beispielsweise 400 definierte Quellen, 2.000 implementierte Modelle und wird von 30 Entwicklern aktiv genutzt. Von diesen 30 Entwicklern arbeiten vielleicht 5 Personen gezielt an den Schichten des Business Data Vault und der Information Marts für finanzbezogene Objekte. Weitere 5 Entwickler arbeiten an denselben Schichten, jedoch für vertriebsbezogene Objekte.

Ab einem gewissen Punkt möchten Sie verhindern, dass Personen aus dem Finanzbereich Modifikationen an den vertriebsbezogenen dbt-Modellen vornehmen, weshalb eine Data Mesh-Architektur implementiert werden soll. Dies ermöglicht es der Organisation, Richtlinien bezüglich Data Sharing, Data Ownership und weiterer Governance-Maßnahmen festzulegen.

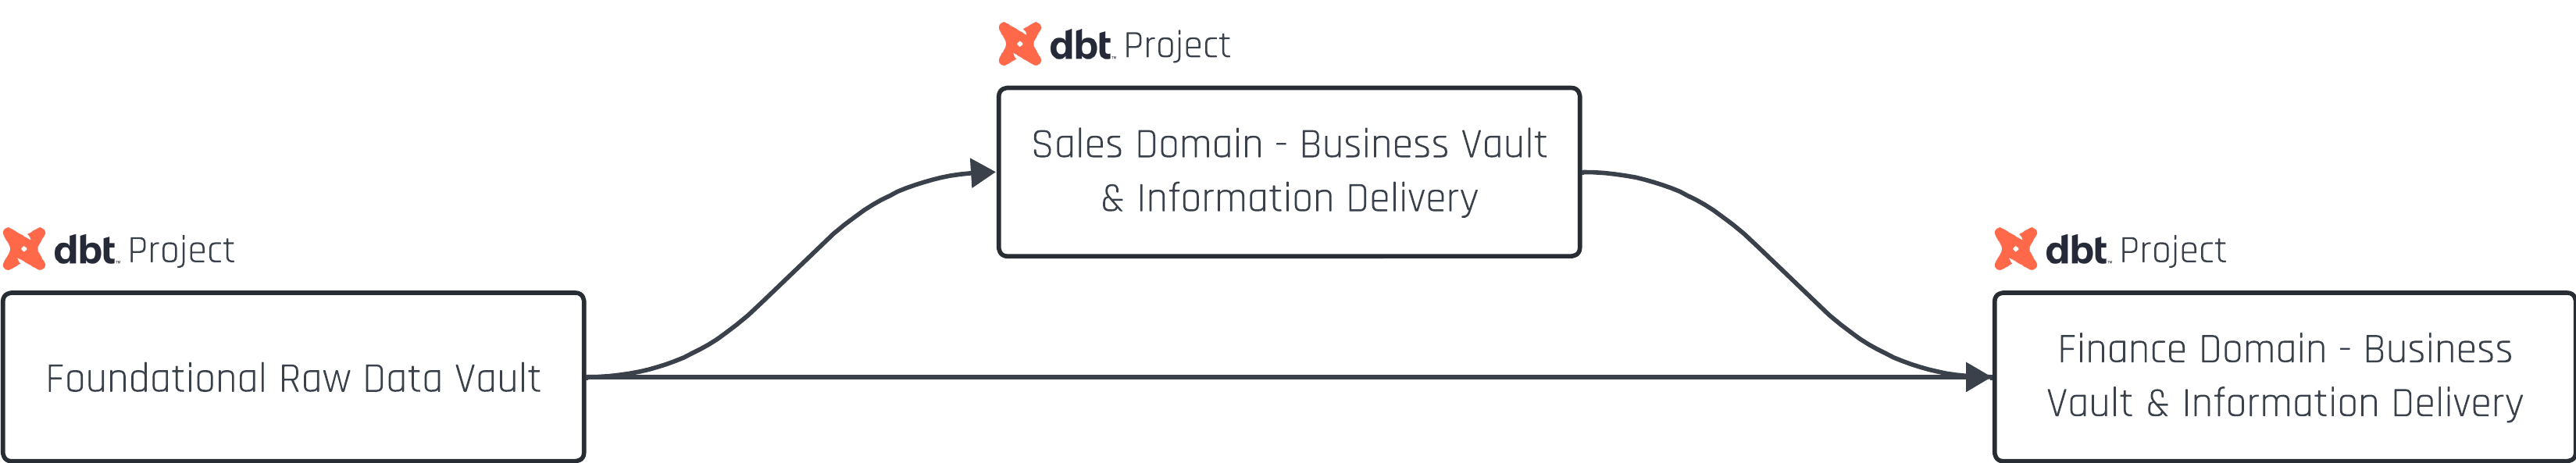
Mit dbt Mesh erhalten sowohl das Sales- als auch das Finance-Team ein jeweils eigenes dbt-Projekt. Da beide auf demselben Raw Data Vault aufbauen sollen, wird ein zusätzliches Basis-dbt-Projekt exklusiv für Staging- und Raw Data Vault-Objekte erstellt. Beide domänenspezifischen dbt-Projekte (Sales und Finance) können nun auf Raw Vault-Objekte innerhalb des Basis-dbt-Projekts verweisen, ohne die Daten physisch duplizieren zu müssen.

dbt Mesh - data mesh solution

Wie können Sie dbt Mesh in einem Data Vault-basierten Data Mesh nutzen?

Data Contracts definieren

dbt-Modelle oder Gruppen von Modellen können nun so konfiguriert werden, dass sie Data Contracts enthalten. In den bereits bekannten .yml-Dateien lässt sich festlegen, dass Modelle öffentlich verfügbar sind (innerhalb einer Organisation), ihnen Data Owner zugewiesen werden und Tabellenschemata gesperrt werden.

Ein Basis-dbt-Projekt erstellen

In einer Data Mesh-Architektur besteht der gängigste Weg zur Implementierung von Data Vault 2.0 darin, einen gemeinsam genutzten Raw Vault als Grundlage zu nutzen, während Business Vault und Information Marts nach Fachbereichen (Business Domains) aufgeteilt sind. In dbt Mesh spiegelt sich dies in einem Basis-dbt-Projekt wider, das alle Staging- und Raw Data Vault-Objekte enthält. Nur die Raw Data Vault-Objekte werden so konfiguriert, dass andere dbt-Projekte auf sie zugreifen können, da Staging-Modelle nicht außerhalb von Raw Data Vault-Modellen verwendet werden sollten.

dbt-Projekte auf Domänenebene hinzufügen

Aufbauend auf dem Basis-dbt-Projekt des Raw Vaults kann jedes Domänenteam nun in einem eigenen dbt-Projekt arbeiten. Die Teams greifen über die erweiterte {{ ref() }}-Funktion auf den Raw Data Vault zu und müssen sich nicht um die Wartung dieser Raw Vault-Objekte kümmern. Zudem können sie definieren, welche ihrer Artefakte für andere Domänen nützlich sein könnten, und diese über eigene Data Contracts bereitstellen.

Verantwortlichkeiten verteilen

Typischerweise erstellt ein Fachanwender keine Hubs, Links und Satellites und es liegt auch nicht in seiner Verantwortung, für einen verlässlichen Raw Data Vault als Grundlage für Transformationen zu sorgen. Daher ist es wichtig, die Verantwortlichkeiten innerhalb jedes dbt-Projekts klar zu definieren. Insbesondere Objekte, die außerhalb eines Projekts geteilt werden, sollten immer über Data Contracts und definierte Owner verfügen. Dies stellt sicher, dass sich die Nutzer dieser gemeinsam genutzten Objekte darauf verlassen können.

Fazit

Alles in allem bietet dbt Mesh eine hervorragende Möglichkeit, einen echten Data Mesh-Ansatz gewinnbringend umzusetzen. Dies ist besonders relevant, wenn verschiedene Fachbereiche einer Organisation in dbt zusammenarbeiten, um verlässliche Ergebnisse zu liefern. In den meisten Szenarien ist es sinnvoll, bereits frühzeitig mit der Nutzung von dbt Mesh zu beginnen, selbst wenn Ihr Projekt noch nicht übermäßig groß ist. Klare Verantwortlichkeiten und Data Contracts helfen stets dabei, das Vertrauen in Ihre Daten zu stärken und die Transparenz zu wahren.

Enterprise-Datentransformationen mit Turbovault & dbt Cloud

Webinar ansehen

Webinar-Zusammenfassung

Data Vault ist aufgrund seiner Anpassungsfähigkeit und Skalierbarkeit für Unternehmen bei der Verwaltung dynamischer Datenumgebungen von entscheidender Bedeutung. Seine Hub-and-Spoke-Architektur gewährleistet Nachvollziehbarkeit sowie Agilität und ermöglicht eine schnelle Anpassung an sich verändernde Anforderungen und vielfältige Datenquellen.

Nehmen Sie an unserem bevorstehenden Webinar teil und erfahren Sie, wie Sie dbt Cloud mit Turbovault und einem Datenmodellierungstool nutzen können, um Data Vault in Ihrem Unternehmen erfolgreich zu implementieren.

In diesem Webinar werden Sie

  • Eine detaillierte 90-minütige „Show-and-Tell“-Demonstration einer End-to-End-Data-Vault-Implementierung auf Basis modernster Tools erleben
  • Die nahtlose Integration von Ellie.ai, Turbovault4dbt und Datavault4dbt für eine optimierte Datenmodellierung und Automatisierung kennenlernen
  • Die praktische Umsetzung von Data Vault ganz ohne vorkonfigurierte Demo-Umgebung verstehen

Webinar-Details

  • Datum: 27. Februar
  • Uhrzeit: 14:00 – 15:45 Uhr MEZ

Webinar-Agenda

  1. Einführung in das Power-Trio: dbt Cloud, Turbovault und Datenmodellierungstools
  2. 90-minütiger „Show-and-Tell“-Walkthrough einer End-to-End-Data-Vault-Implementierung
    • Verwendung von Ellie.ai für das ER-Modell, Turbovault4dbt für die dbt-Automatisierung und Datavault4dbt für die Generierung des DV-Modells
  3. Einblicke in die Data-Vault-Implementierung in mittelständischen und großen Unternehmen
  4. Q&A-Runde mit Branchenexperten

In Partnerschaft mit

Monitoring eines Data Vault-basierten EDW

Einleitung

In diesem Newsletter geben wir Ihnen einen Überblick über die Möglichkeiten zur Überwachung Ihrer Lösung innerhalb eines Enterprise Data Warehouse (EDW), das auf Data Vault 2.0 basiert.
Die vorgestellten Monitoring-Ansätze zeigen Ihnen verschiedene Wege auf, um fundierte Einblicke in die Performance Ihrer Data-Warehouse-Lösung zu gewinnen. Das Ziel besteht darin, nützliche Informationen über die technischen Daten Ihres EDW zu gewinnen und diese gezielt zu nutzen: zur Fehlernachverfolgung, zur Identifikation von Engpässen in Lade- und Transformationsprozessen sowie zur Steigerung der Gesamtperformance Ihres Data Warehouse.

In unserer Webinar-Session sind wir tiefer in das Thema technischer Test- und Monitoring-Methoden für ein Data Vault-basiertes EDW eingetaucht. Dabei wurden alle EDW-Schichten abgedeckt und Performance-Einblicke mit Schwerpunkt auf der Modellierung von Metrics Vaults und Marts unter Berücksichtigung der Quelldaten vermittelt.

Sehen Sie sich die Aufzeichnung hier kostenlos an!

Was Sie erwartet

Sie erhalten einen Überblick über verschiedene Metriken und Metadatenarten zur Überwachung Ihrer Lösung. Im nächsten Schritt wird der Modellierungsansatz zur Erfassung und späteren Analyse der Daten für die verschiedenen Schichten Ihres EDW behandelt vom klassischen Metrics Vault bis hin zu den Metrics Marts. Darüber hinaus werden relevante Monitoring-Bereiche mit Fokus auf potenzielle Herausforderungen innerhalb Ihrer Architektur thematisiert. Der Schwerpunkt dieses Newsletters liegt darauf, wie Metadaten bereitgestellt und für wertvolle Erkenntnisse nutzbar gemacht werden können.

Modellierung von Metadaten

Im Folgenden werden vier Instanzen behandelt, die nützliche technische Daten enthalten: der Metrics Vault und der darauf aufbauende Metrics Mart, der Meta Mart sowie der Error Mart. Jede dieser Komponenten erfüllt ihren eigenen Zweck, auch wenn sich Modellierung und Datenquellen ähneln können. Die Gemeinsamkeiten und Unterschiede zwischen den Modellierungsansätzen dieser überwiegend technischen Tabellen und ihren Datenquellen werden in den folgenden Abschnitten erläutert.

Metrics Vault

Der Metrics Vault wird verwendet, um definierte Metriken zu erfassen, die aus ETL/ELT-Datenflüssen stammen. Er ist keine obligatorische Komponente von Data Vault. Wird er jedoch implementiert, profitiert Ihre Lösung von verschiedenen Vorteilen und technischen Funktionen, wie zum Beispiel:

  • Fehlerprüfung (Error Inspection)
  • Ursachenanalyse (Root Cause Analysis)
  • Performance-Metriken

Im Hinblick auf Datenflüsse liegt der Fokus auf der Identifizierung von Fehlern sowie auf Ursachenanalysen von Systemausfällen, um gezielte Maßnahmen zur künftigen Fehlervermeidung abzuleiten.

Die Metriken selbst können aus unterschiedlichen Quellen stammen – etwa der Datenplattform, der ETL/ELT-Pipeline oder dem von Ihnen verwendeten EDW-Job-Orchestrierungs-Tool. Aus diesem Grund empfehlen wir, diese Datenquellen nach denselben Mustern und Standards zu modellieren, die Sie auch für die Erstellung des Raw Data Vault nutzen. Dies gewährleistet eine skalierbare Lösung zur Erfassung und Verarbeitung Ihrer Metriken.

Metrics Mart

Im Metrics Vault werden die Daten im Hinblick auf Speicherung, Skalierbarkeit und Flexibilität modelliert und optimiert. Um die gesammelten Daten auswerten zu können, muss das Modell den Anforderungen der Endbenutzer entsprechen. Aus diesem Grund ist der Metrics Mart Teil des Information Delivery Layer. Da der Metrics Vault ausschließlich dafür aufgebaut ist, Daten für den Metrics Mart bereitzustellen, werden mit diesem Ansatz die Standards der Data Vault 2.0-Architektur konsequent eingehalten. Der Metrics Mart ist ein zweckgebundener Information Mart, der primär aus dem Metrics Vault gespeist wird. Für die Umsetzung kommen sowohl die Materialisierung als physische Tabellen als auch die Virtualisierung über Views in Betracht. Der Virtualisierungsansatz ist hierbei häufig vorzuziehen, da die Bereitstellungsgeschwindigkeit (Deployment Speed) von dieser Entscheidung profitiert.

Wie oben erwähnt, bildet der Metrics Vault die Hauptdatenquelle für den Metrics Mart, wenngleich er nicht darauf beschränkt ist. In bestimmten Fällen kann sich der Fachbereich dazu entscheiden, Business Objects mit Metriken zu verknüpfen, um die Performance konkreter Geschäftsobjekte nachzuverfolgen. Dies trägt ebenfalls dazu bei, die Performance weiter zu optimieren.

Das Datenmodell des Metrics Mart ist nicht starr vorgegeben und variiert je nach Anforderung der Endbenutzer. Daher kann ein dimensionales Modell die passende Lösung sein, ist jedoch nicht zwingend erforderlich. Stammen Daten direkt aus Quellwerkzeugen, kann mitunter deren Ursprungsstruktur beibehalten werden, um eine effizientere Datenanalyse zu ermöglichen.

Meta Mart

Metadaten werden direkt im Meta Mart gespeichert. Diese Marts speisen sich nicht aus dem Raw Data Vault; daher existiert kein Meta Vault als Quelle für eine Virtualisierung. Folglich wird der Meta Mart in Form von Tabellen materialisiert. Der Aufbau ähnelt dem anderer Information Marts: Die fachlichen Anforderungen bestimmen das exakte Modell des Meta Marts, da dessen Kernfunktion darin besteht, Daten für den maximalen geschäftlichen Nutzen bereitzustellen. Je nach Anwendungsfall wird dies als dimensionales Modell oder in der dritten Normalform umgesetzt.

Error Mart

Der Error Mart ist ein weiterer Information Mart. Auch hier hängt die genaue Implementierung des Modells vom jeweiligen Fachbereich ab, wenngleich in der Praxis meist ein dimensionales Modell gewählt wird. Das Ziel des Error Marts ist es, fehlerhafte Datensätze, sogenannte „Ugly Data“ abzufangen. Dabei handelt es sich um Daten, die von Ihren Transformationswerkzeugen abgewiesen wurden, beispielsweise aufgrund definierter Soft Rules. Da sich Soft Rules im Zeitverlauf verändern können, passen sich auch Ihre Error Marts entsprechend an. Diese Fehlerdaten stammen nicht aus dem Raw Data Vault, weshalb es keinen Error Vault gibt. Die Daten für die Error Marts speisen sich aus verschiedenen Quellen, überwiegend jedoch direkt aus der ETL/ELT-Engine.

Verwaltung von Metadaten

Nachdem im vorherigen Abschnitt beschrieben wurde, wie ausgewählte Information Marts modelliert werden und welchem Zweck sie dienen, widmet sich dieser Abschnitt den Details der Datenbeladung. Dazu betrachten wir die zugrunde liegenden Daten, deren Ursprung sowie die jeweiligen Anwendungsfälle genauer.

Business Metadata

Business Metadata sind definiert als Metadaten mit direkter Relevanz für den Fachbereich. Obwohl die fachliche Verantwortung je nach Unternehmensstruktur variieren kann, liegt die technische Datenverwaltung beim Data-Warehouse-Team. Der Meta Mart deckt diesen Bereich der Metadaten ab.

Zu den Metadaten, die Sie erfassen sollten, gehören unter anderem:

  • Fachliche Spaltennamen
    Entscheidet sich der Fachbereich für Abkürzungen in Präfixen oder Suffixen, müssen diese dokumentiert werden, um eine einheitliche und verständliche Begrifflichkeit im Business zu gewährleisten.
  • Fachliche Definitionen
    Sie bilden das Fundament für alle nachfolgenden Datenanalysen. Eine lückenlose fachliche Beschreibung der Attribute und Tabellen belegt zudem deren Notwendigkeit. Kann der Fachbereich keine Definition für eine Spalte oder Tabelle liefern, sollte geprüft werden, ob das Element im Information Mart benötigt wird oder fachlich neu definiert werden muss.
  • Ontologien und Taxonomien
    Sie liefern Kontext zum Business Object hinter den Quelldaten – etwa Klassifizierungen, Hierarchien sowie Beziehungen zu anderen Objekten.
  • Physische Tabellen- und Spaltennamen
    Sie stellen die Verknüpfung zwischen den fachlichen Namen der Business Objects und den Bezeichnungen der physischen Tabellen und Spalten her.
  • Record Source
    Sie beschreibt die Datenquellen in fachlicher Sprache. Das Ziel besteht nicht im rein technischen Verweis auf Datenbanken, sondern in der Vermittlung der geschäftlichen Bedeutung der jeweiligen Quellen.
  • Tabellenspezifikation
    Sie dokumentiert den Zweck der Quelltabelle und der Daten sowie die relevanten Spaltennamen und Schlüssel.
  • Exception-Handling Rules
    Sie erfassen potenzielle Fehler sowie Datenqualitätsprobleme und legen fest, wie der ETL/ELT-Prozess bei Ausnahmen verfährt.
  • Fachliche Definitionen der Quellsysteme
    Sie erläutern die fachliche Bedeutung der Attribute aus den Quellsystemen.
  • Business Rules
    Sie erzeugen neue Daten auf Basis von Geschäftslogiken. Entwickler benötigen ein klares Verständnis dieser Regeln und Transformationen, um fachliche Anforderungen exakt umzusetzen. Als Business Metadata werden Geschäftsregeln fachlich verständlich formuliert, wobei stets sauber zwischen Hard Rules und Soft Rules unterschieden werden sollte.

Technical Metadata

Während Business Metadata in erster Linie dem Fachbereich dienen, profitiert vor allem das Data-Warehouse-Team von den Technical Metadata, die ebenfalls im Meta Mart hinterlegt werden. Diese Metadaten stammen überwiegend direkt aus den beteiligten Systemkomponenten, wie die folgenden Beispiele zeigen:

  • Quellsysteme
    Sie liefern eine technische Spezifikation der Quellsysteme, beispielsweise Datenbanknamen, Schnittstellen oder Speicherpfade von Flat Files.
  • Datenmodelle
    Sie stellen eine essenzielle technische Referenz dar, veranschaulichen die Beziehungen zwischen den genutzten Tabellen und können grafisch aufbereitet werden.
  • Datendefinitionen
    Sie beschreiben die Daten auf technischer Ebene und umfassen Details zu Tabellen- und Spaltennamen, Datentypen, Constraints sowie Standardwerten.
  • Business Rules
    Geschäftsregeln sind ebenso Teil der Technical Metadata. Hier liegt der Fokus auf der technischen Ausgestaltung der Logiken, die in den ETL/ELT-Tools implementiert werden. Hard Rules und Soft Rules müssen hierbei analog zu den Business Metadata klar getrennt werden.
  • Volumetrie
    Sie dokumentiert Ladeprozesse, Tabellengrößen und Datenwachstum, um die Auslastung und Skalierung des Data Warehouse präzise zu steuern.
  • Ontologien und Taxonomien
    Technische Metadaten konkretisieren Begriffskürzel, Attributstrukturen, Business-Key-Konventionen, Hierarchien sowie Neudefinitionen (Re-defines).
  • Datenqualität
    Diese Metadaten erfassen Qualitätsmetriken und Regeln zur technischen Standardisierung der Quelldaten.

Process Execution Metadata

Process Execution Metadata werden im Gegensatz zu Business und Technical Metadata nicht vom Fachbereich oder von Quellanwendungen geliefert, sondern automatisiert vom Data-Warehouse-Team bzw. der Infrastruktur generiert, um Transparenz über die ETL/ELT-Pipelines zu schaffen. Das Hauptziel besteht darin, die Performance des Data Warehouse messbar zu machen und gezielt zu optimieren. Die Daten stammen primär aus dem eingesetzten ETL/ELT-Tool und umfassen folgende Bereiche:

  • Control-Flow-Metadaten
    Da ein Control Flow mindestens einen Data Flow ausführt, liefert er Statusdaten über Abläufe und die Data Lineage sämtlicher EDW-Komponenten.
  • Data-Flow-Metadaten
    Sie dokumentieren die Datenflüsse selbst, einschließlich übertragener Datenvolumina sowie abgewiesener Zeilen innerhalb von Lade- und Transformationsschritten.
  • Package-Metadaten
    Sie fassen die Ausführungsinformationen eines Packages zusammen, welches in der Regel einen übergeordneten Control Flow abbildet.
  • Prozess-Metadaten
    Da die meisten Packages automatisiert über Scheduling-Lösungen laufen, protokollieren diese Metadaten Details zum auslösenden Gesamtprozess.

Process Execution Metadata sollten im Metrics Vault abgelegt und getrennt von den Business und Technical Metadata verwaltet werden.

Fazit

In diesem Newsletter haben wir Ihnen die zentralen Monitoring-Optionen für Ihr Data Vault-basiertes EDW vorgestellt. Wir haben erläutert, wie spezialisierte Information Marts modelliert werden, aus welchen Quellen sie gespeist werden und wie Fachbereich und Data-Warehouse-Team davon profitieren. Zudem haben wir die verschiedenen Metadatenarten und ihre Einsatzbereiche strukturiert: von Business Metadata für den Fachbereich über Technical Metadata für die technische Administration bis hin zu Process Execution Metadata für die Überwachung Ihrer ETL/ELT-Pipelines. Damit verfügen Sie über eine verlässliche Grundlage, um Ihr EDW nach den Best Practices von Data Vault 2.0 professionell zu überwachen.

In unserem Webinar gehen wir noch weiter ins Detail. Nutzen Sie die Gelegenheit und sehen Sie sich die Aufzeichnung kostenlos an! Wir freuen uns darauf, Sie dort begrüßen zu dürfen.

Data-Vault-Automatisierung mit DataVault4coalesce

SALESFORCE SOLUTIONS

Data-Vault-Automatisierung mit DataVault4coalesce

Durch eine Kooperation ist DataVault4coalesce entstanden, ein Open-Source-Erweiterungspaket für coalesce.io. In einem früheren Webinar haben wir coalesce.io bereits näher beleuchtet einen neuen Mitbewerber im stark umkämpften Markt der Data-Warehouse-Automatisierungstools.

coalesce

Bringen Sie Ihre Data-Vault-Automatisierung auf das nächste Level

Coalesce ist ein modernes, spaltenorientiertes (column-aware) Data-Warehouse-Automatisierungstool. In diesem Webinar erfahren Sie, wie die neueste Veröffentlichung von Scalefree bewährte Best Practices aus der Data-Vault-Welt nahtlos in coalesce.io einbringt. Dies umfasst Datenlademuster, Data-Vault-bezogene Funktionen und vieles mehr – alles eingebettet in einfach zu bedienende UI-Optionen, um die einzigartige, konfigurierbare Benutzeroberfläche von Coalesce optimal zu nutzen. Schalten Sie ein, um DataVault4coalesce in Aktion zu sehen!

Watch Webinar Part 1Watch Webinar Part 2

Alle, die dieses Webinar gesehen haben, erinnern sich vielleicht daran, dass wir am Ende eine noch engere Partnerschaft zwischen coalesce.io und Scalefree angekündigt haben – verbunden mit dem Versprechen, die Best Practices von Scalefree direkt in coalesce.io zu integrieren.

Falls Sie das Webinar verpasst haben, finden Sie die Aufzeichnung hier.

Zusammenfassung: Was ist Coalesce?

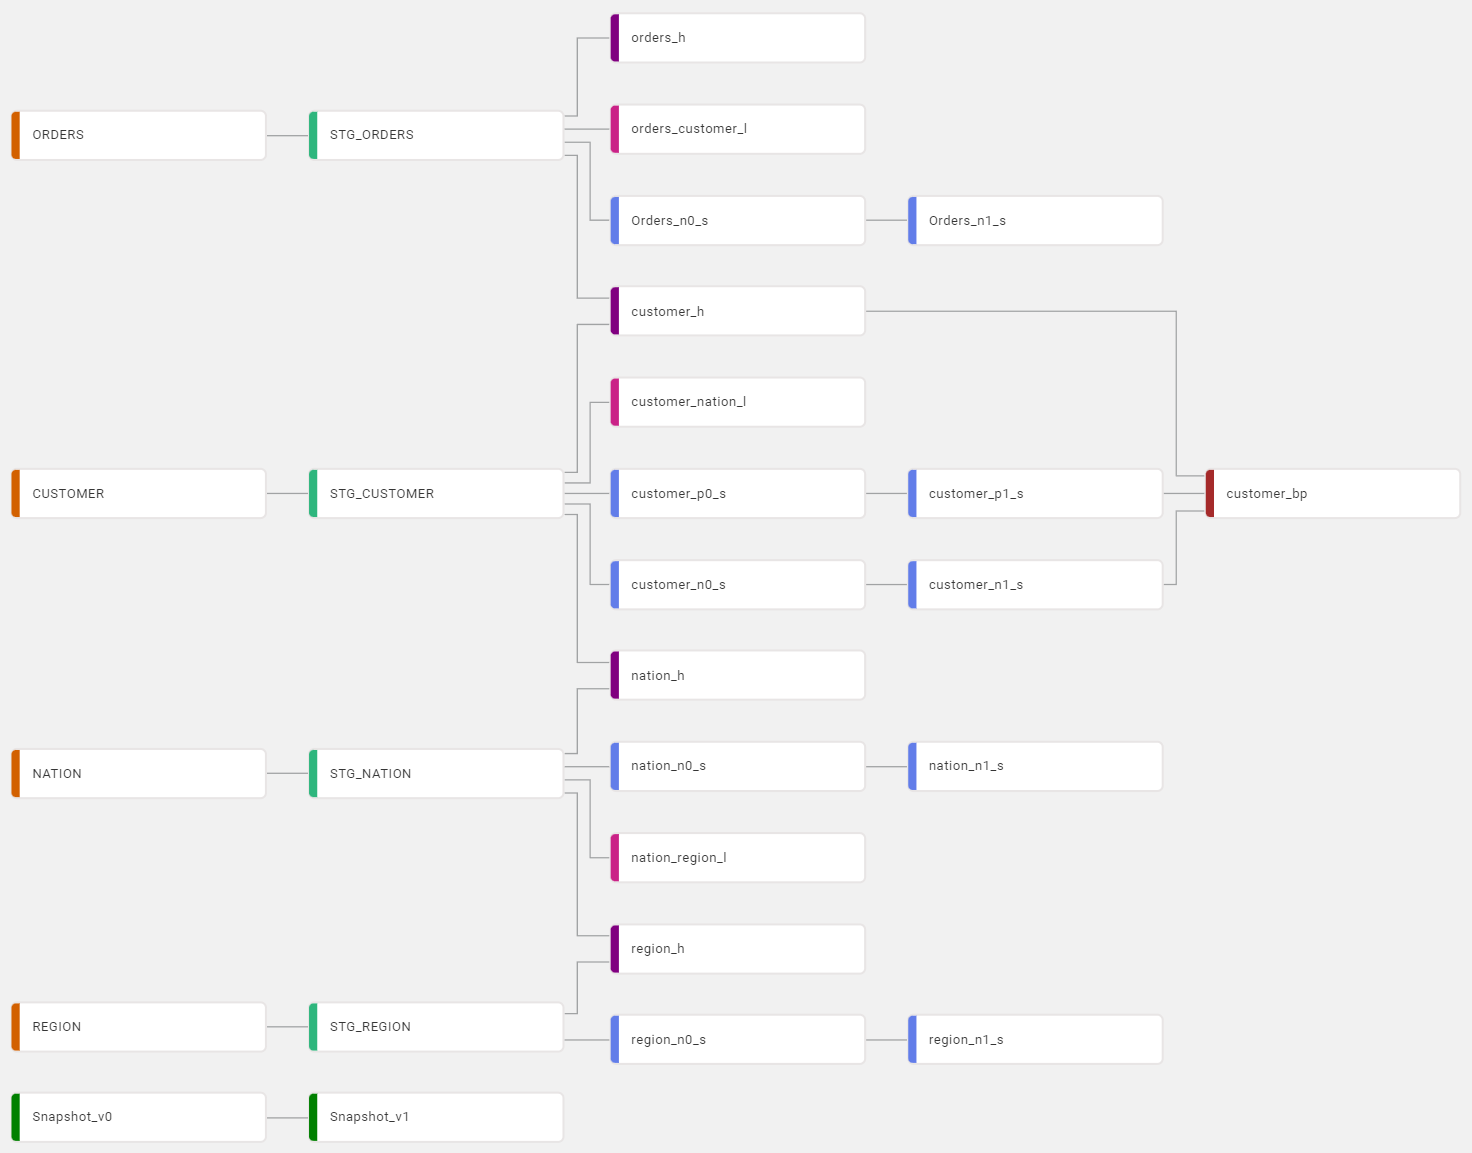
coalesce.io ist eine Datentransformationslösung für Snowflake. Wenn Sie mit Coalesce arbeiten, erstellen Sie gerichtete azyklische Graphen (Directed Acyclic Graphs, DAGs), die Knoten (Nodes) enthalten. Ein Knoten repräsentiert dabei jeweils ein physisches Datenbankobjekt, wie etwa Tabellen, Views oder auch Stages und externe Tabellen.

Coalesce basiert auf Metadaten, die Informationen auf Tabellen- und Spaltenebene speichern und die Struktur innerhalb Ihres Data Warehouses beschreiben. Dieses metadatenorientierte Design ermöglicht eine Reihe von Funktionen, die Skalierbarkeit und Verwaltbarkeit stark fördern.

Die zentralen Metadaten ermöglichen es Ihrem Team, vergangene, aktuelle und gewünschte Zustände des Data Warehouses nachzuverfolgen und alle damit verbundenen Workflows tief zu integrieren. Zudem können Anwender standardisierte Muster und Templates auf Spalten- und Tabellenebene definieren.

Wie kommt Data Vault hier ins Spiel?

Die genannten Templates öffnen die Tür für die Implementierung von Data-Vault-2.0-Mustern und Best Practices. Besonders auf Tabellenebene liegt der Gedanke nahe, Vorlagen für Hubs oder Links zu erstellen.

Auf Spaltenebene kann dies eine wiederkehrende Transformation sein, die zentral in einem Makro verwaltet wird. Das macht es sehr einfach, Änderungen mit minimalen oder gar keinen Auswirkung umzusetzen, denken Sie hierbei beispielsweise an Hash-Key-Berechnungen oder virtuelles Load-End-Dating.

Genau das haben wir bei Scalefree seit dem Webinar im vergangenen Jahr getan: Lead-Entwickler von coalesce.io haben sich mit den Data-Vault-Experten von Scalefree zusammengesetzt. Das gemeinsame Ziel: Eine Lösung zu schaffen, die Anwendern hilft, ihre Data-Vault-2.0-Implementierung effizient zu automatisieren.

Datavault4Coalesce

Wie schnell kann man ein Data Vault aufbauen? Die Antwort lautet: Ja!

Aus dieser Kooperation ist DataVault4coalesce entstanden, ein Open-Source-Erweiterungspaket für coalesce.io, das ab dem 16. März verfügbar ist! Werfen wir einen kurzen Blick auf die Möglichkeiten, die DataVault4coalesce bietet.

Die erste Version von DataVault4coalesce enthält ein grundlegendes Set an Data-Vault-2.0-Entitäten:

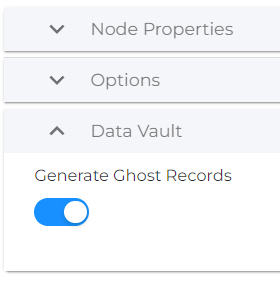
DataVault4coalesce stellt nicht nur DDL- und DML-Templates für die oben genannten Entitätstypen bereit, sondern nutzt auch die Flexibilität von Coalesce, die Benutzeroberfläche für jeden Knotentyp anzupassen. Für Stages bedeutet dies beispielsweise, dass Anwender entscheiden können, ob DataVault4coalesce Ghost Records automatisch generieren soll.

Datavault4Coalesce

Diese Data-Vault-spezifische Benutzeroberfläche zieht sich durch alle Knotentypen und ermöglicht es Anwendern, DataVault4coalesce komfortabel an die eigenen Anforderungen anzupassen.

Fazit

Zunächst ein kleiner Dämpfer für die Vorfreude: DataVault4coalesce ist erst ab dem 16. März verfügbar. Es gibt jedoch keinen Grund, so lange zu warten, um tiefer in coalesce.io einzutauchen! Da die Lösung jetzt Teil von Snowflake Partner Connect ist, war es noch nie so einfach, direkt eine neue coalesce.io-Umgebung auszuprobieren.

Melden Sie sich einfach für eine kostenlose Snowflake-Testversion an und richten Sie Ihren Zugang zu coalesce.io innerhalb von Sekunden über das Partner-Connect-Portal ein. Anschließend laden Sie Ihre Daten und können sofort mit dem Aufbau Ihrer Datenpipelines beginnen. Sobald der 16. März da ist, fügen Sie DataVault4coalesce einfach Ihrer coalesce.io-Umgebung hinzu – und bauen Ihr Data Vault schneller auf als je zuvor.

Verpassen Sie außerdem nicht unsere Webinar-Aufzeichnung, in der wir Ihnen DataVault4coalesce in Aktion zeigen. Sehen Sie sich das Video direkt hier an!

Starten Sie Ihre Data Vault-Implementierung mit datavault4dbt

DataVault4dbt Powered by Scalefree

Datavault4dbt

Scalefree hat datavault4dbt veröffentlicht. Ein Open-Source-Paket, das Best-Practice-Ladetemplates für Data Vault 2.0-Entitäten bereitstellt, eingebettet in das Open-Source-Data-Warehouse-Automatisierungstool dbt.

Datavault4dbt unterstützt derzeit Snowflake, BigQuery sowie Exasol und bietet eine Vielzahl leistungsstarker Funktionen:

  • Eine Data Vault 2.0-Implementierung, die der ursprünglichen Data Vault 2.0-Definition von Dan Linstedt entspricht
  • Einsatzbereit für Persistent Staging Areas und Transient Staging Areas, da alle Makros mehrere Deltas verarbeiten können, ohne Zwischenänderungen zu verlieren
  • Erstellung eines zentralisierten, Snapshot-basierten Business-Interfaces durch eine zentrale Snapshot-Tabelle mit Unterstützung logarithmischer Logik
  • Optimierung inkrementeller Ladevorgänge durch die Implementierung einer High-Water-Mark, die auch für aus mehreren Quellen geladene Entitäten zuverlässig funktioniert
dbt, Scalefree's partner

Starten Sie Ihre Data Vault 2.0-Implementierung – mit datavault4dbt

Dieses Webinar gibt detaillierte Einblicke in datavault4dbt, ein Open-Source-Paket von Scalefree, das die Implementierung von Data Vault 2.0 in dbt vereinfacht. Es bietet Best-Practice-Templates für Hubs, Links und Satellites, stellt die Einhaltung von Data Vault-Standards sicher und unterstützt flexibles Staging mit optimierten inkrementellen Ladevorgängen – ein Webinar, das Sie keinesfalls verpassen sollten.

Watch webinar recording

Aufbau einer Data Vault 2.0-Lösung – leicht gemacht

Das übergeordnete Ziel bei der Veröffentlichung von Data Vault 2.0-Templates für dbt besteht darin, unsere jahrelange Erfahrung im Aufbau und Laden von Data Vault 2.0-Lösungen in Form öffentlich zugänglicher Lademuster und Best Practices für jedermann nutzbar zu machen. Aus dieser Ambition heraus entstand datavault4dbt: ein Open-Source-Paket für dbt, das vom Scalefree-Expertenteam kontinuierlich gepflegt und weiterentwickelt wird.

Die größte Stärke von datavault4dbt ist die originalgetreue Umsetzung der ursprünglichen Data Vault 2.0-Definition von Dan Linstedt. Es stellt eine vollständig auditierbare Lösung für Ihr Data Vault 2.0-basiertes Data Warehouse dar. Mit einem geradlinigen, standardisierten Ansatz ermöglicht es Ihrem Team die Durchführung agiler Entwicklungszyklen.

Durch die Verarbeitung mehrerer Inkremente pro Batch beim Laden jedes Data Vault-Entitätstyps unterstützt datavault4dbt sowohl Persistent als auch Transient Staging Areas, ohne dass Zwischenänderungen verloren gehen. Diese inkrementellen Ladevorgänge werden durch die Implementierung einer dynamischen High-Water-Mark zusätzlich optimiert, welche selbst beim Laden einer Entität aus mehreren Quellen reibungslos funktioniert.

Darüber hinaus fördert datavault4dbt strenge Namenskonventionen und Standards durch die Implementierung verschiedener globaler Variablen, die sich über alle Data Vault-Schichten und unterstützten Datenbanken erstrecken. Der Prozess des End-Datings ist vollständig virtualisiert, um einen modernen Insert-only-Ansatz zu gewährleisten und Updates von Datensätzen zu vermeiden.

Mit all diesen Funktionen ist datavault4dbt die perfekte Lösung für Ihr modernes Enterprise Data Warehouse im Big-Data-Umfeld.

Von der Stage über das Spine bis hin zu den PITs

Um all dies zu erreichen, haben wir intensiv an der Entwicklung einer soliden und universellen Staging Area gearbeitet. Alle Hash-Keys und Hash-Diffs werden hier berechnet, und Benutzer haben die Möglichkeit, abgeleitete Spalten hinzuzufügen, Pre-Joins mit anderen Stages zu generieren sowie Ghost Records zu ihren Daten hinzuzufügen. All dies erfolgt hochautomatisiert auf Basis parametrisierter Benutzereingaben.

Auf Basis der Staging Areas kann das Data Vault 2.0-Spine erstellt werden. Hubs, Links und Non-Historized Links können aus mehreren Quellen geladen werden, einschließlich Mapping-Optionen zur Sicherstellung der fachlichen Harmonisierung.

Dieses Spine wird anschließend durch Standard Satellites, Non-Historized Satellites, Multi-Active Satellites und/oder Record-Tracking Satellites angereichert. Alle Entitäten, die dies erfordern, verfügen über eine Version 0 für Tabellen und eine Version 1 für end-dated Views.

Basierend auf dem Raw Data Vault können PITs automatisch erstellt werden. Deren Beladung wird durch eine automatisierte, hochgradig konfigurierbare und optionale logarithmische Snapshot-Logik unterstützt. Diese Logik ist in der Control Snapshot Table enthalten, die ebenfalls in zwei aufeinanderfolgenden Versionen bereitgestellt wird. Um die logarithmische Snapshot-Logik abzurunden, ist ein praktischer Post-Hook zur Bereinigung aller PITs integriert.

DataVault4dbt Powered by Scalefree

Starten Sie jetzt und optimieren Sie Ihr Data Vault-Erlebnis!

Haben die obigen Zeilen in Ihnen den Gedanken geweckt: „Das klingt fast zu gut, um wahr zu sein!“? Überzeugen Sie sich selbst oder geben Sie uns Ihr wertvolles Feedback, indem Sie datavault4dbt auf GitHub besuchen!

Natürlich sind unsere zukünftigen Ambitionen für datavault4dbt groß. Als Nächstes stehen viele wichtige Themen auf unserer Agenda, wie zum Beispiel:

  • Bereitstellung eines detaillierten Anwendungsbeispiels (Working Example) für datavault4dbt
  • Erweiterung und Migration der bestehenden Dokumentation des Pakets
  • Unterstützung weiterer Datenbanken
  • Hinzufügen weiterer fortgeschrittener und spezifischer Data Vault 2.0-Entitäten
  • Entwicklung automatisierter Data Vault-bezogener Tests
  • Überprüfung und Implementierung von Benutzerfeedback und Vorschlägen

Bleiben Sie über alle unsere Kanäle auf dem Laufenden, um keine weiteren Neuigkeiten und Inhalte zu datavault4dbt zu verpassen!

Dokumentenverarbeitung in MongoDB

Als Fortsetzung unserer Blogserie beschreibt dieser Beitrag die grundlegenden Mechanismen zur Abfrage und Bearbeitung von Daten in MongoDB – mit dem Schwerpunkt auf den Anforderungen für den Data Vault Load sowie für Query Patterns.

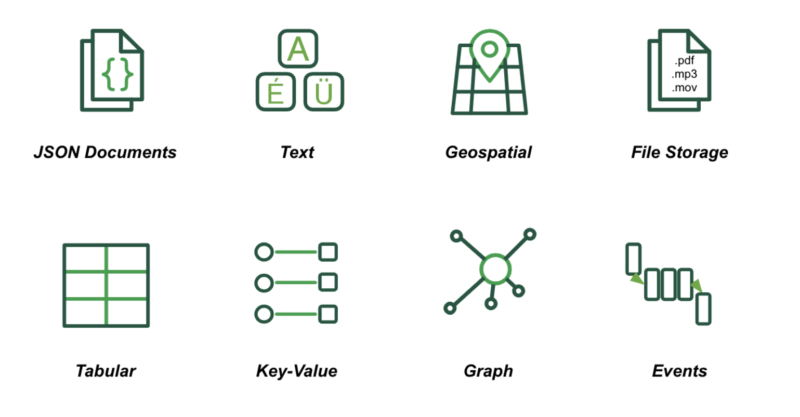
Im Gegensatz zu den in relationalen Datenbanken üblichen Tabellen nutzt MongoDB ein JSON-basiertes Dokumentendatenmodell. Dokumente stellen eine natürlichere Möglichkeit dar, Daten in einer einzigen Struktur abzubilden: Durch die Einbettung zugehöriger Daten als Unterdokumente und Arrays wird zusammengeführt, was in einer relationalen Datenbank andernfalls über Fremdschlüssel verknüpfte Parent-Child-Tabellen erfordern würde. Sie können Daten exakt so modellieren, wie es Ihre Anwendung erfordert – von komplexen, hierarchischen Dokumenten über flache, tabellenartige Strukturen und einfache Key-Value-Paare bis hin zu Freitexten, Geodaten sowie Knoten und Kanten für die Graphverarbeitung.

Continue Reading