
Als Fortsetzung unserer Blogserie beschreibt dieser Beitrag die grundlegenden Mechanismen zur Abfrage und Bearbeitung von Daten in MongoDB – mit dem Schwerpunkt auf den Anforderungen für den Data Vault Load sowie für Query Patterns.
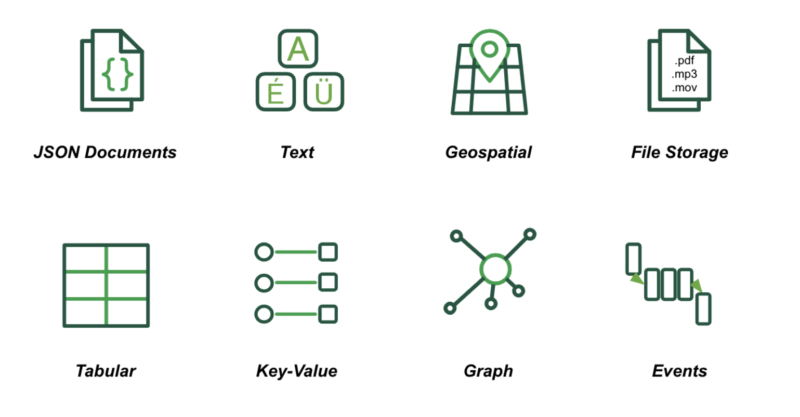
Im Gegensatz zu den in relationalen Datenbanken üblichen Tabellen nutzt MongoDB ein JSON-basiertes Dokumentendatenmodell. Dokumente stellen eine natürlichere Möglichkeit dar, Daten in einer einzigen Struktur abzubilden: Durch die Einbettung zugehöriger Daten als Unterdokumente und Arrays wird zusammengeführt, was in einer relationalen Datenbank andernfalls über Fremdschlüssel verknüpfte Parent-Child-Tabellen erfordern würde. Sie können Daten exakt so modellieren, wie es Ihre Anwendung erfordert – von komplexen, hierarchischen Dokumenten über flache, tabellenartige Strukturen und einfache Key-Value-Paare bis hin zu Freitexten, Geodaten sowie Knoten und Kanten für die Graphverarbeitung.
Um Abfragen zu beschleunigen, können in Dokumenten gespeicherte Daten über beliebige Attribute indiziert werden:
- Primary Indexes existieren standardmäßig in jeder Collection über das _id-Attribut.
- Compound Indexes ermöglichen die Indizierung über mehrere Felder innerhalb eines Dokuments hinweg.
- MultiKey Indexes werden für Array-Werte verwendet.
- Wildcard Indexes indizieren automatisch alle übereinstimmenden Felder, einschließlich Unterdokumenten und Arrays.
- Text Indexes unterstützen Textsuchen, ergänzt durch Full-Text-Search-Funktionen auf Basis von Apache Lucene in MongoDB Atlas.
- GeoSpatial Indexes dienen der Verarbeitung räumlicher Geometrien und Geodaten.
- Hashed Indexes unterstützen das Sharding, also das horizontale Skalieren.
Indizes bieten zudem spezifische Eigenschaften, um entweder erweiterte Anwendungsfälle abzudecken oder die Indexgröße zu optimieren:
- Unique Indexes stellen sicher, dass ein Wert innerhalb einer Collection nur einmal vorkommt.
- Partial Indexes erstellen Indizes selektiv auf Teilmengen von Daten basierend auf definierten Filterkriterien.
- Sparse Indexes berücksichtigen ausschließlich Dokumente, die das angegebene Feld tatsächlich enthalten.
- TTL Indexes löschen Dokumente automatisch nach Ablauf einer definierten Zeitspanne.
- Case Insensitive Indexes unterstützen die Textsuche unabhängig von Groß- und Kleinschreibung.
Die flexible Modellierung komplexer Datenstrukturen setzt eine ebenso leistungsfähige Sprache für CRUD-Operationen voraus.
Hierfür bietet die MongoDB Query Language (MQL) präzise und ausdrucksstarke Abfragemöglichkeiten für polystrukturierte Dokumente – wie etwa: „Finde alle Personen mit einer Telefonnummer, die mit ‚1-212*‘ beginnt“ oder „Prüfe, ob die Person mit der Nummer ‚555-444-333‘ auf der ‚Do Not Call‘-Sperrliste steht“.
Zudem stehen Methoden zum Einfügen und Aktualisieren von Daten sowie für Upserts zur Verfügung (falls ein Dokument noch nicht existiert, wird es neu angelegt). Weitere Einzelheiten dazu finden Sie hier der offiziellen MongoDB-Dokumentation.
MongoDB unterstützt zudem die Verwendung von Aggregation Pipeline Stages innerhalb von Update–Anweisungen. Aggregation Pipelines sind leistungsstarke Datenverarbeitungsketten für Transformationen und analytische Auswertungen. Dabei durchlaufen Dokumente eine mehrstufige Pipeline, die Zwischenergebnisse schrittweise verarbeitet und aggregiert. Jede Stage transformiert die Dokumente beim Durchlauf. Dabei muss eine Pipeline Stage nicht zwingend für jedes Eingabedokument genau ein Ausgabedokument erzeugen: Stages können neue Dokumente generieren oder Datensätze herausfiltern.
Ein typisches Beispiel ist eine Pipeline mit zwei Stages auf der Orders-Collection: Die $match-Stage filtert die Dokumente anhand des Feldes status und leitet nur diejenigen Dokumente an die nächste Stufe weiter, deren Status „A“ lautet. . Die anschließende $group-Stage gruppiert die verbliebenen Dokumente nach dem Feld cust_id, um die Gesamtsumme des Feldes amount für jede eindeutige cust_id zu berechnen.

Pipeline Stages können innerhalb einer Abfrage mehrfach und in beliebiger Reihenfolge kombiniert werden
Eine vollständige Übersicht aller verfügbaren Stages finden Sie in der Dokumentation zu Aggregation Pipeline Stages.
Die folgenden Stages spielen bei Data Vault Patterns eine zentrale Rolle:
- $match: Filtert Dokumente, sodass nur Datensätze an die nächste Pipeline Stage übergeben werden, welche die definierten Bedingungen erfüllen.
- $project: Leitet Dokumente mit einer festgelegten Feldauswahl weiter. Dabei kann es sich um bestehende Felder aus den Eingabedokumenten oder um neu berechnete Werte handeln.
- $unwind: Löst ein Array-Feld aus den Eingabedokumenten auf und gibt für jedes Array-Element ein eigenständiges Dokument aus.
- $group: Gruppiert Dokumente anhand eines Kriteriums und liefert für jede eindeutige Gruppe ein Dokument zurück. Die Ausgabedokumente enthalten ein _id-Feld mit dem Gruppierungsschlüssel sowie optional berechnete Aggregatwerte über Operatoren wie min, max, avg oder sum.
- $lookup: Führt einen Left Outer Join zu einer nicht geshardeten Collection innerhalb derselben Datenbank aus. Für jedes Eingabedokument fügt die $lookup-Stage ein neues Array-Feld hinzu, das die passenden Dokumente der verknüpften Collection enthält.
Darüber hinaus schreiben die Stages $out und $merge die Ergebnisse einer Aggregation Pipeline direkt in neue oder bestehende Collections zurück.
Für die Manipulation von Datenwerten stellt MongoDB ein breites Spektrum an Aggregationsoperatoren bereit: (https://docs.mongodb.com/manual/reference/operator/aggregation/) von mathematischen Operatoren über Datumsfunktionen, String-Transformationen und Typkonvertierungen bis hin zu regulären Ausdrücken und trigonometrischen Berechnungen.
Im nächsten Beitrag unserer Serie zeigen wir konkret, wie Sie Aggregation Pipelines für das Laden von Data-Vault-Hubs einsetzen. Wenn Sie Ihr Wissen vertiefen möchten, empfehlen wir die kostenfreien Kurse der MongoDB University: M001 (MongoDB Basics) und M121 (The MongoDB Aggregation Framework).
Haben Sie Fragen oder Anmerkungen?
Nutzen Sie gerne den Kommentarbereich für Ihr Feedback!