All Posts By

Marc Winkelmann

As Senior Managing Consultant and official CDVP2.1 Instructor since 2020, Marc brings more than ten years of dedicated Data Vault experience to complete end-to-end data platform implementations. His core strength lies in empowering entire data teams to build highly scalable data and AI solutions.

Multi-Temporalität in Data Vault 2.0 – Teil 1

An abstract illustration features a large clock in the center with connected circuitry-like lines. Icons of a calendar and a smaller clock are in the background. Two large arrows pointing outward appear on both sides, and the backdrop has splashes of blue and gray.

Multi-Temporalität in Data Vault 2.0

Der folgende Artikel gibt einen Überblick über das theoretische Verständnis von Multi-Temporalität in einem Data Warehouse.

Multi-Temporalität in Data Vault 2.0

Vielleicht haben Sie bereits von bitemporalen Daten gehört. Doch in der Regel gibt es in Ihren Daten mehr als nur zwei Zeitachsen, was Ihre Arbeit komplexer macht. Meist finden Sie in Ihren Datensätzen mehrere Zeitstempel und Daten aus unterschiedlichen Perspektiven. Dies eröffnet vielfältige Möglichkeiten, Ihre Daten aus einer zeitlichen Perspektive zu betrachten. Sie sollten jedoch auch in der Lage sein, dieses „Biest“ von einer Zeitmaschine zu beherrschen. Wussten Sie, dass Data Vault 2.0 in der Lage ist, multi-temporale Daten zu verarbeiten? Wie beeinflusst dies Ihre Arbeit und wie können Sie davon profitieren? Nehmen Sie an diesem Webinar teil, um zu erfahren, wie Data Vault 2.0 Ihnen helfen kann, die Multi-Temporalität zu meistern.

Watch webinar recording

Was ist „Multi-Temporalität“ in einem Data Warehouse?

Bevor wir über Multi-Temporalität sprechen, definieren wir zunächst den Begriff Bitemporalität, da ein weit verbreitetes Missverständnis darin besteht, dass Data Vault 2.0 nur bitemporal sei (was falsch ist):

„Die bitemporale Modellierung ist ein Spezialfall einer temporalen Datenbank-Modellierungstechnik, die für den Umgang mit historischen Daten entlang zweier unterschiedlicher Zeitachsen entwickelt wurde. Dies ermöglicht es, die Informationen auf den Zustand zurückzuspulen, ‚wie sie tatsächlich waren‘, kombiniert mit dem Zustand, ‚wie sie zu einem bestimmten Zeitpunkt aufgezeichnet wurden‘.“ (Frei nach Wikipedia)

Die Bitemporalität adressiert lediglich zwei Zeitachsen, die gemeinhin als „System Time“ (die technische Zeitachse) und „Valid Time“ (die fachliche Zeitachse) bezeichnet werden. Data-Vault-Satelliten (Satellites), Point-in-Time-Tabellen (PIT) und Bridge-Tabellen sind in der Lage, mehrere aktive Zeitachsen im selben Datensatz abzubilden. Diese lassen sich wie folgt kategorisieren:

  • Quellgesteuerte Zeiten (Source-driven Times)
    • Erstellungszeitpunkt (Created Time)
    • Aktualisierungszeitpunkt (Updated Time)
    • Löschzeitpunkt (Deleted Time)
  • Systemzeiten (System Times)
    • CDC-Zeitstempel (CDC Time)
    • Ereigniszeitpunkt der Nachricht (Message Event Time)
  • Fachliche Zeiten (Business Times)
    • alle Zeiten, die darstellen, wann etwas in der „realen Welt“ passiert ist oder passieren wird (wie z. B. ein Kauf- oder Verkaufszeitstempel)
  • Zeitspannen (Time Spans)
    • können technisch oder fachlich motiviert sein
    • Vertragsstart- und -enddaten/-zeiten (Contract Start and End Dates/Times)
    • Technische Gültig-von- und Gültig-bis-Daten/Zeitstempel (Technical Valid-from and Valid-to Dates/Timestamps)
  • Enterprise Data Warehouse (EDW)
    • Load Date Timestamp (beim Einfügen in der ersten Schicht des EDW gesetzt)
    • Zeitstempel des Schreibvorgangs eines Datensatzes in die Tabelle

All diese Datumsangaben und Zeitstempel könnten in nur einem einzigen Datensatz in einer Satellitentabelle zu finden sein. Dies ermöglicht es uns, die Daten aus mehreren zeitlichen Perspektiven zu betrachten. Daher berücksichtigt das Data-Vault-Modell die Multi-Temporalität und nicht nur die Bitemporalität.

Der Load-Date-Timestamp bei Multi-Temporalität

Eine Voraussetzung für die Realisierung von Multi-Temporalität in den Daten ist, dass der Load-Date-Timestamp beim Laden von Daten in Satelliten für den Delta-Abgleich (Delta Check) verwendet wird. Nur der Load-Date-Timestamp kann uns eine konsistente, lückenlose und überschneidungsfreie Zeit liefern, die unter unserer eigenen Kontrolle steht. Dies ermöglicht uns eine uneingeschränkte Sicht auf die verschiedenen Zeitachsen in den Satelliten.

Alle anderen Zeitstempel sind dafür nicht geeignet. Erstens würden sie die Anzahl der möglichen Perspektiven auf die Daten auf eine einzige Instanz beschränken. Zudem können sie Lücken und Überschneidungen aufweisen, NULL sein und werden nicht von den Enterprise-Data-Warehouse-Teams kontrolliert.

Kurz gesagt: Auf den Load-Date-Timestamp können wir keinesfalls verzichten. Er wird beim Einfügen (Insert) in der ersten Schicht der Enterprise-Data-Warehouse-Architektur gesetzt und so weit wie möglich durch alle Schichten durchgeschleust (beispielsweise bei Aggregaten im Business Vault über mehrere Load-Date-Timestamps hinweg).

Drei verschiedene Perspektiven auf Daten

Das Data-Vault-Kernmodell wird in den Raw Data Vault (RDV) und den Business Vault (BV) unterteilt. Der Grund dafür ist die Trennung von Soft Business Rules und Hard Business Rules, da Soft Business Rules den Inhalt der Daten verändern können. Dies führt dazu, dass sich die Anzahl der möglichen Perspektiven auf die Rohdaten verringert, wenn Soft Business Rules früh in der Ladearchitektur angewendet werden. Dieselben Regeln müssen auch auf Zeitachsen angewendet werden. Zeitachsengesteuerte geschäftliche Perspektiven auf Rohdaten finden frühestens im Business Vault statt.

Es gibt im Wesentlichen drei verschiedene Perspektiven im Zusammenhang mit Zeitachsen im Data Warehouse: eine Data-Warehouse-Perspektive, eine geschäftliche Perspektive und eine Perspektive der Informationsbereitstellung.

Die Data-Warehouse-Perspektive bezieht sich auf den Load-Date-Timestamp, um eine konsistente, inkrementelle Integration der Daten in den Raw Data Vault und den Business Vault zu gewährleisten.

Die geschäftliche Perspektive bezieht sich auf alle Daten und Zeitstempel, die vom Quellsystem geliefert werden. Auch technische Felder wie das Erstellungs-, Aktualisierungs- oder Löschdatum bzw. der entsprechende Zeitstempel aus dem Quellsystem werden auf dieselbe Weise behandelt. Alles, was Teil der Nutzdaten (Payload) ist, wird beim Laden in den Raw Data Vault als beschreibende Daten behandelt.
Nun können verschiedene Abfragen alle möglichen Sichten auf die Rohdaten erstellen – zum Beispiel Aggregate basierend auf dem neuesten Datensatz pro Business Key, gruppiert nach einem Verkaufsdatum.

Die Perspektive der Informationsbereitstellung stützt sich auf einen Snapshot, um alle Daten so „einzufrieren“, wie sie zu einem bestimmten Zeitpunkt aktiv waren. Die Interpretation dessen, was „aktiv“ bedeutet, kann jedoch unterschiedlich sein.

Um dem Rechnung zu tragen, können mehrere Perspektiven erstellt werden. Das ist auch der Grund, warum wir von der „Single Version of the Facts“ im Raw Data Vault und von „Multiple Versions of the Truth“ im Business Vault sprechen (unterschiedliche Perspektiven auf Rohdaten = unterschiedliche Wahrheiten aus verschiedenen Blickwinkeln).

Dies könnte beispielsweise ein stündlicher, täglicher, wöchentlicher, monatlicher oder jährlicher Snapshot oder eine entsprechende Zeitspanne sein. Die hier verwendeten Data-Vault-Entitäten sind die PIT- und Bridge-Tabellen. Das aktuelle Delta von Stammdaten wie Kundendaten in einem Satelliten kann basierend auf einem täglichen Snapshot in einer PIT-Tabelle „eingefroren“ werden. Auch Transaktionsdaten, die in einem Non-Historized-Link vorgehalten werden, können an einen stündlichen Snapshot in einer Bridge-Tabelle angehängt werden.

Wie das genau aussieht, wird im nächsten Teil der multitemporalen Newsletter-Serie gezeigt. Um Ihr Verständnis dieser Datenperspektiven zu vertiefen, können Sie auch unseren Kurs „Multi-Temporal Data Vault“ besuchen.

Fazit

Die Integration von Multi-Temporalität in Data Vault 2.0 ermöglicht es Unternehmen, Daten über verschiedene Zeitachsen hinweg zu verwalten und zu analysieren, was eine umfassende Sicht auf historische Änderungen aus mehreren Perspektiven bietet. Dieser Ansatz verbessert die Fähigkeit, die Datenentwicklung zu verfolgen und zu verstehen, was zu einer fundierteren Entscheidungsfindung und einer verbesserten Data Governance führt. Durch den effektiven Umgang mit mehreren zeitlichen Aspekten gewährleistet Data Vault 2.0 ein robustes und flexibles Framework zur Erfassung der Komplexität zeitvarianter Daten.
Multi-Active Satellites richtig nutzen – Teil 2

Data Vault 2.0 Training FAQ - Customized Class

Multi-Active Satellites in Data Vault 2.0

In unserem ersten Beitrag über Multi-Active-Satelliten haben wir kurz verschiedene Implementierungen erläutert, die zur Behandlung von Multi-Activity eingesetzt werden können. Nun gehen wir genauer auf die Vor- und Nachteile dieser Ansätze ein – je nachdem, ob Delta-Checks aktiviert oder deaktiviert sind.


Kurze Zusammenfassung zu Multi-Active Satellites

Multi-Active-Satelliten ermöglichen Ihnen die Implementierung multi-aktiver Datensätze pro Business-Key in Data Vault 2.0. Um die Notwendigkeit dieser Lösung zu verdeutlichen, betrachten wir den häufigen Fall eines Quellsystems, das die benötigten Metadaten nicht liefert – wie etwa bei der Arbeit mit XML-Dateien.

Eine Lösung für dieses Problem besteht darin, einen Multi-Active-Satelliten zu erstellen, indem eine Subsequence-Nummer pro Business-Key hinzugefügt wird. Dies deckt jeden Fall ab, in dem die Quelle selbst kein multi-aktives Attribut liefert. Bezogen auf Telefonnummern könnte diese Information ein Tag für eine geschäftliche, private oder mobile Telefonnummer sein. Eine weitere Möglichkeit besteht darin, einen zusätzlichen Hub für das multi-aktive Attribut zu erstellen. Da dieser jedoch kein reales Business-Objekt darstellt, ist die erste Lösung oft effektiver.

Delta-Check AUS

Es gibt zwei Möglichkeiten, neue Datensätze in einen Multi-Active-Satelliten einzufügen: mit aktivierten oder deaktivierten Delta-Checks. Wenn die Delta-Checks ausgeschaltet sind, werden alle Datensätze eines Business-Keys aus Ihrer Quelllieferung in den Satelliten eingefügt.

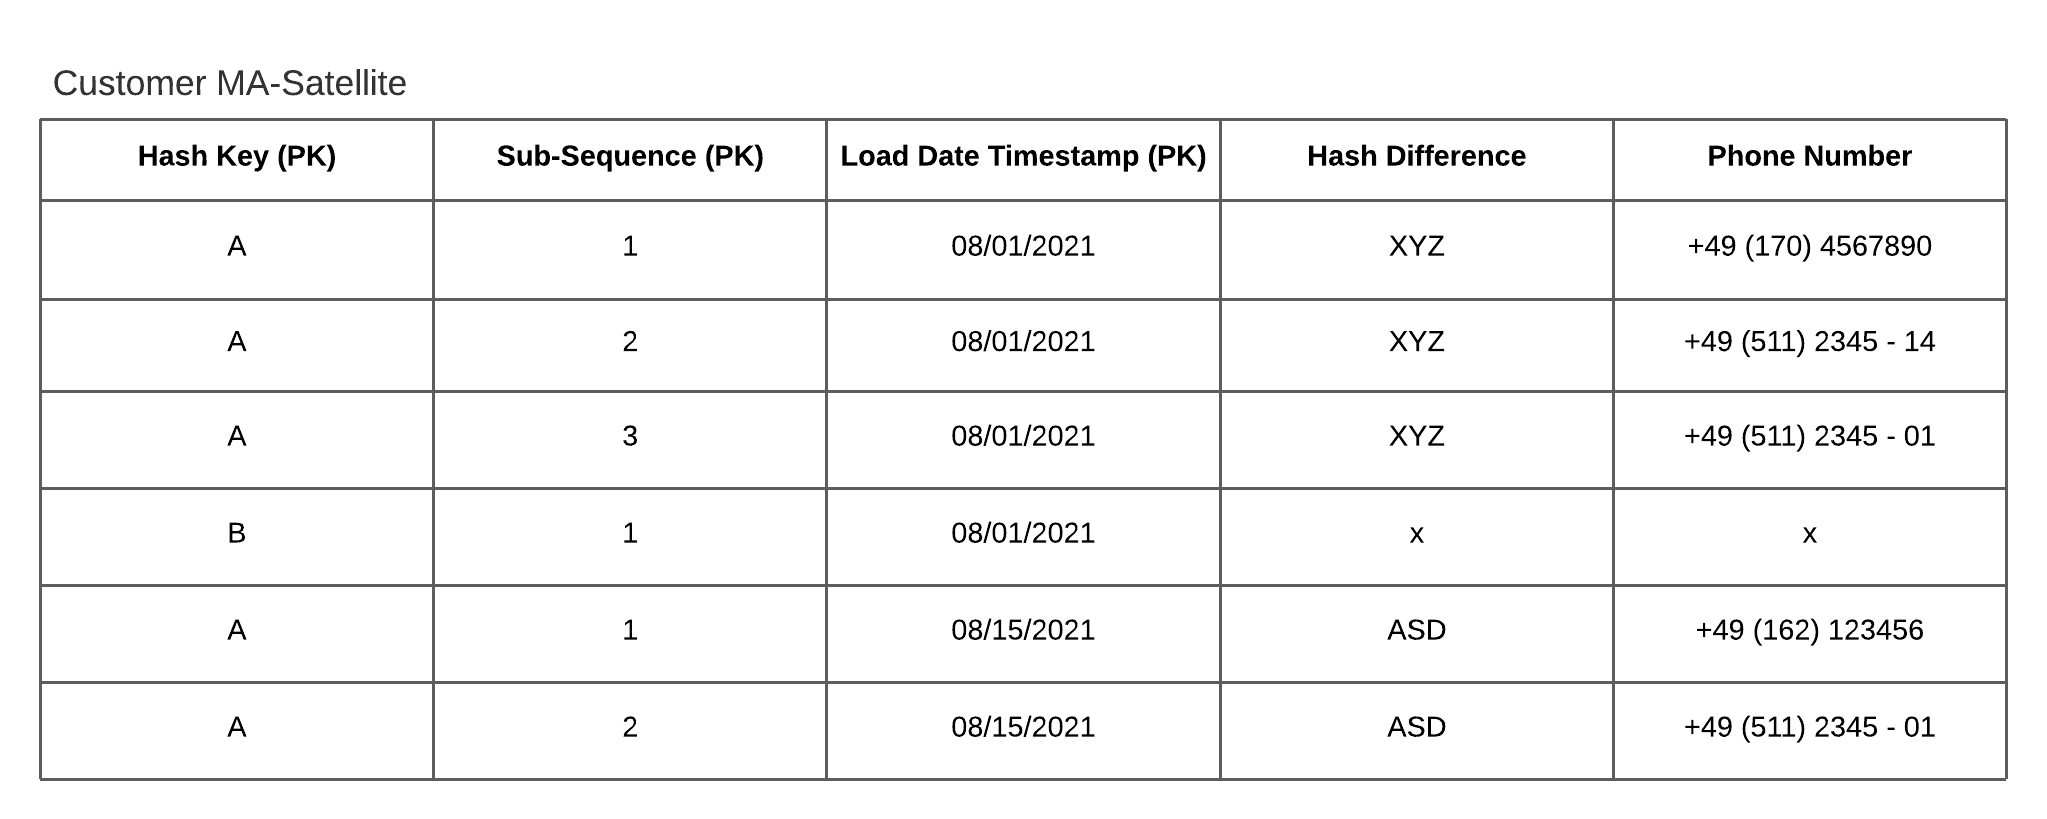
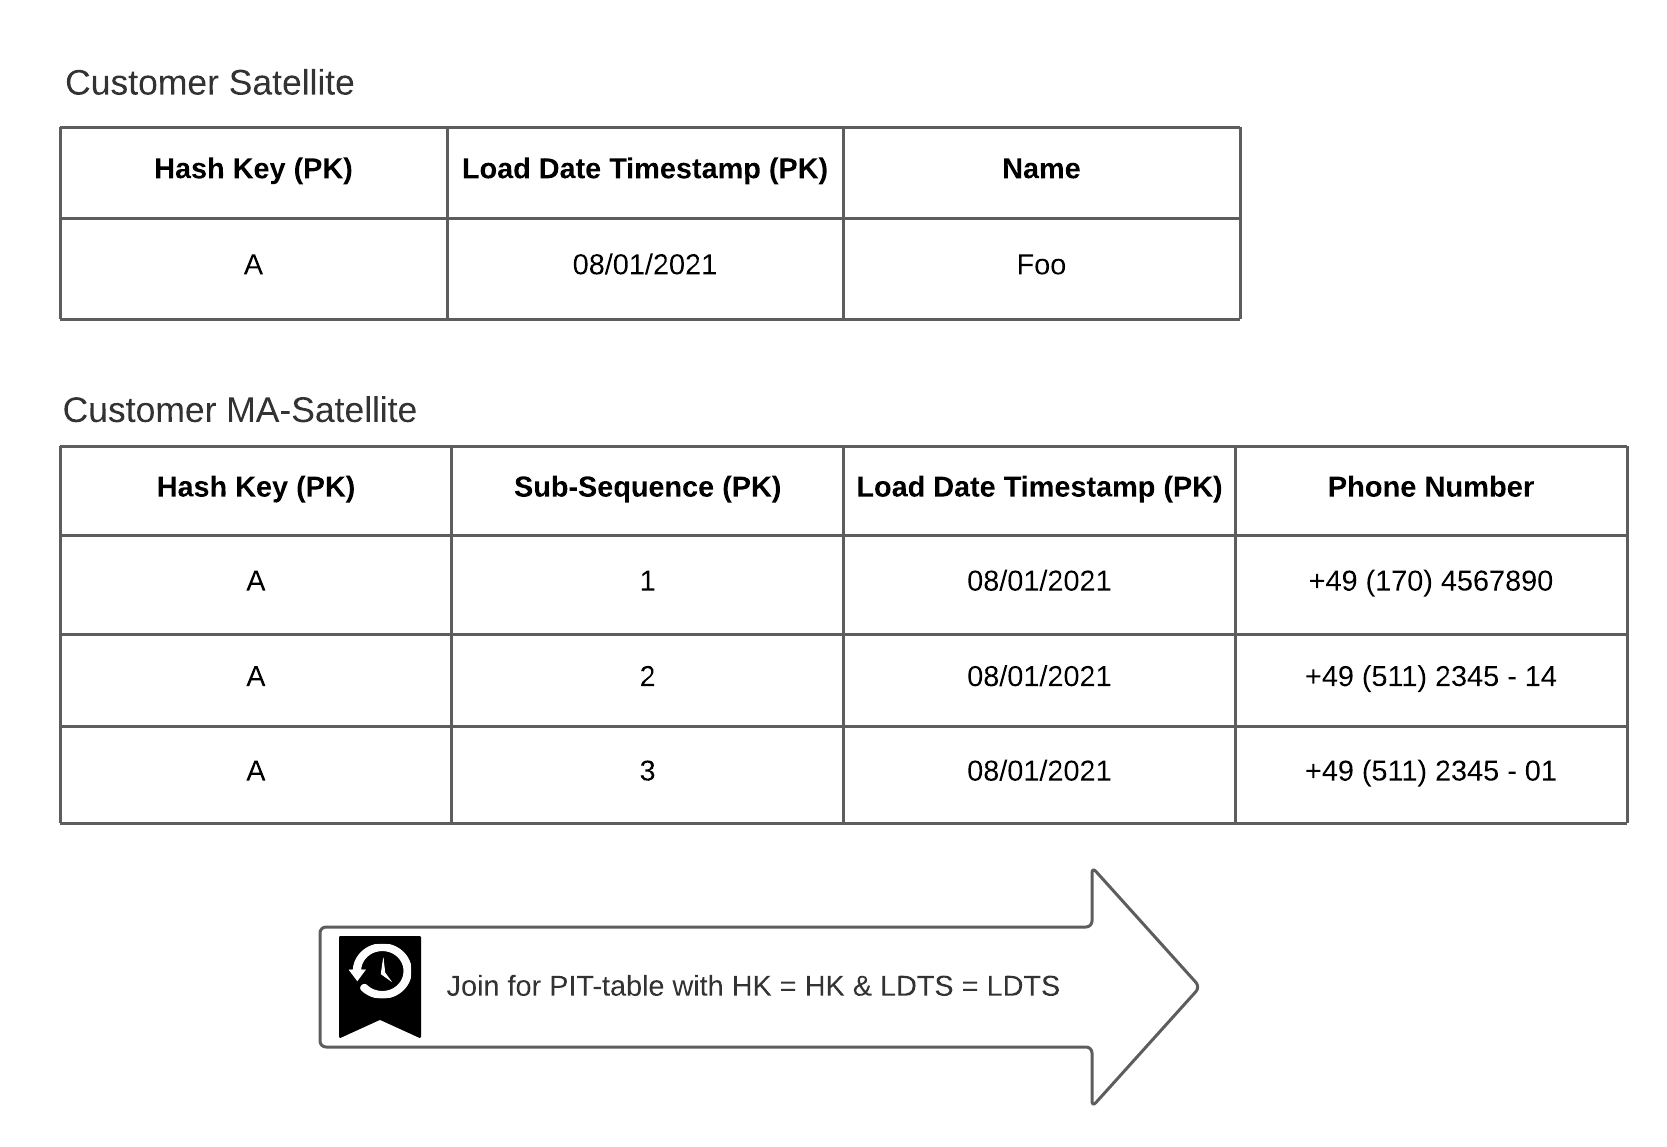
Der Vorteil dabei ist, dass die Ladevorgänge schneller sind und einen konsistenten Load Date Timestamp (LDTS) zum übergeordneten Hash-Key aufweisen, unabhängig vom multi-aktiven Attribut.

Dies vereinfacht die spätere Abfrage basierend auf den multi-aktiven Daten (siehe Abbildung 1). Ein entscheidender Nachteil ist jedoch, dass die geladene Datenmenge stark ansteigen kann, wenn vollständige Datenladungen (Full Data Loads) verarbeitet werden.

In diesem Fall sollten Sie Ihre Daten nach dem Load Date Timestamp partitionieren.

Multi-active satellites

Abbildung 1: Verknüpfen von Datensätzen über eine PIT-Tabelle bei einem einheitlichen LDTS für alle aktiven Datensätze pro Key.

Delta-Check EIN

Um die Datenmenge zu reduzieren, nutzen Sie Delta-Checks. Dabei vergleichen Sie die eingehenden Daten mit dem neuesten LDTS pro Hash-K
Die Funktion LISTAGG() ist hierbei sehr nützlich, um den Delta-Check zu unterstützen. Sie wandelt Werte aus einer Gruppe von Zeilen in eine geordnete Liste um. Dadurch sind Sie in der Lage, eine zeilenübergreifende Hash-Differenz der multi-aktiven Attribute pro Business-Key zu erstellen (siehe Abbildung 2).

Multi-active satellites

Abbildung 2: Zeilenübergreifende Hash-Differenz unter Verwendung der LISTAGG()-Funktion.

Wenn neue Daten eintreffen, können diese mithilfe der zeilenübergreifenden Hash-Differenz verglichen werden. Dadurch lässt sich ein großer Teil unveränderter Daten ignorieren. Wird ein Delta erkannt, werden alle Datensätze pro Hash-Key eingefügt – selbst wenn sich der Inhalt nur für eine einzelne Subsequence geändert hat. Das Ergebnis ist ein konsistenter Load Date Timestamp pro Hash-Key. Zudem wird ein Delta auch dann erkannt, wenn sich lediglich die Reihenfolge der Datensätze ändert. Dieser Ansatz bildet einen Kompromiss, um die Anzahl der Datensätze zu reduzieren und gleichzeitig einen konsistenten LDTS pro Hash-Key beizubehalten, sodass nur eine einzige PIT-Tabelle erforderlich ist.

Verwendung von Type-Codes

Eine weitere Möglichkeit, Multi-Activity zu handhaben, besteht darin, die Typen der Attribute zu verwenden, sofern diese vorhanden sind , wie im vorherigen Beitrag erläutert.
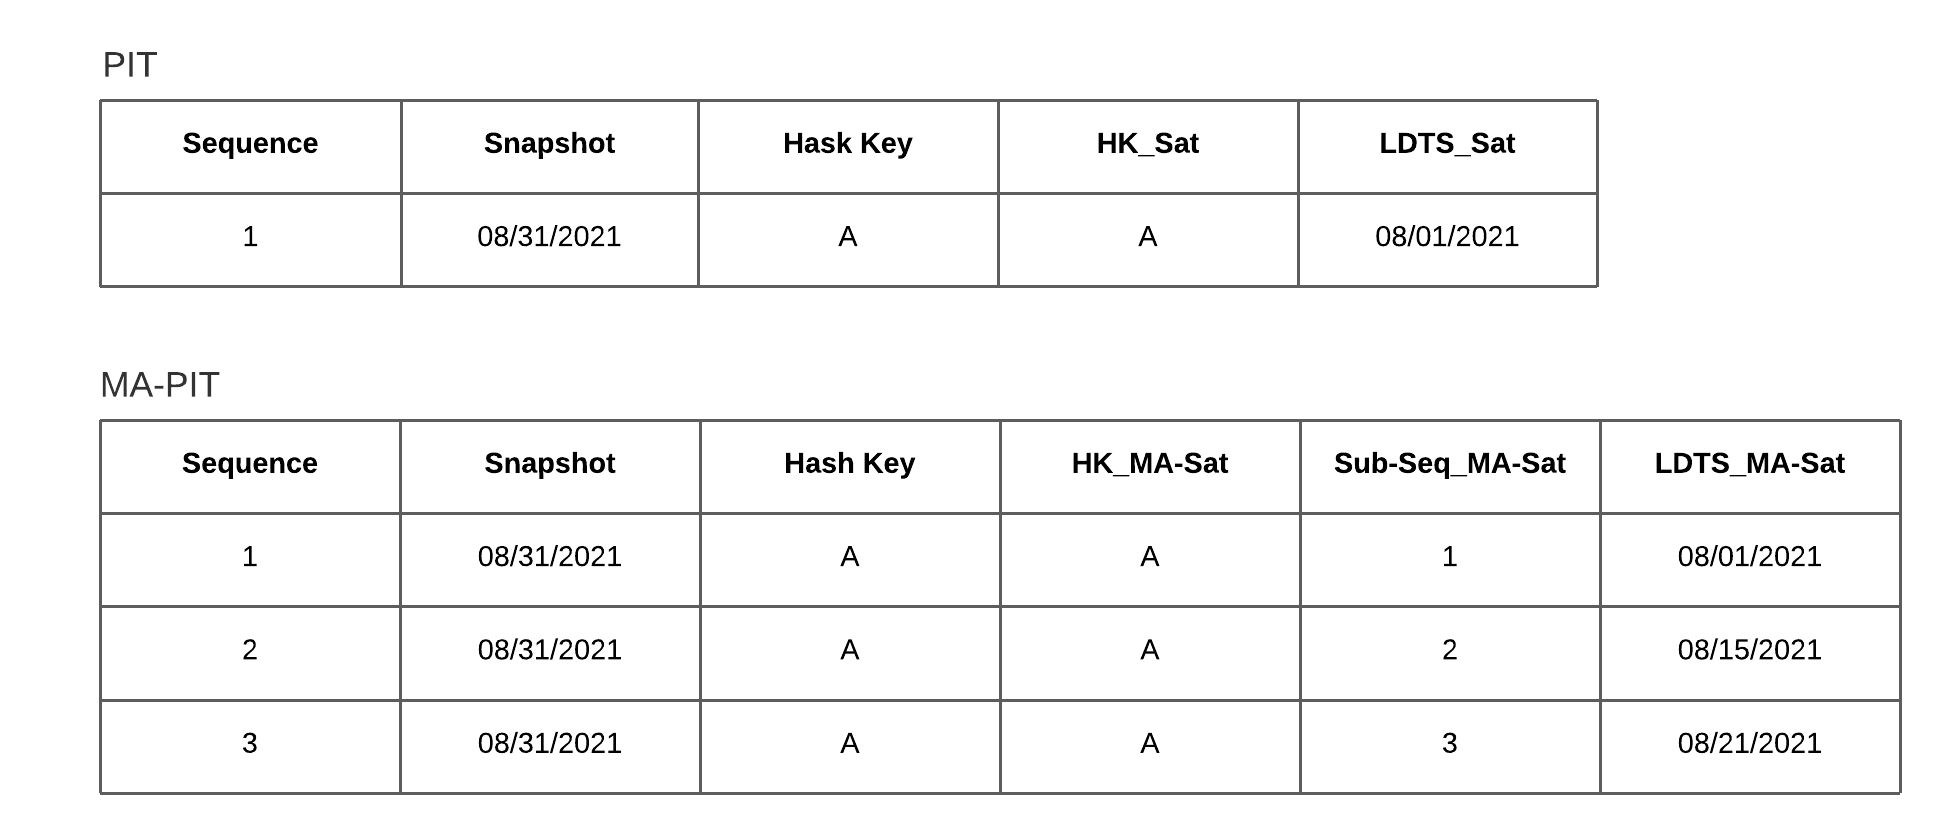
Wenn Sie Type-Codes im Einsatz haben, können Sie Zeile für Zeile vergleichen und nur die spezifischen geänderten Daten laden. Die Konsequenz daraus ist jedoch, dass Sie unterschiedliche LDTS-Werte pro multi-aktivem Attribut erhalten. Wenn Sie PIT-Tabellen im Business Vault verwenden, benötigen Sie daher eine zusätzliche Multi-Active-PIT-Tabelle. Dieses Szenario ist in Abbildung 3 dargestellt.

Multi-active satellites

Abbildung 3: Die Notwendigkeit einer MA-PIT-Tabelle bei unterschiedlichen LDTS-Werten aktiver Datensätze pro Key.

Wenn Sie die multi-aktive Spalte in mehrere Spalten pivotieren können (eine Spalte pro Ausprägung), müssen Sie die oben genannten Vor- und Nachteile nicht berücksichtigen. In diesem Fall wandeln Sie den Multi-Active-Satelliten in einen Standard-Satelliten um. Bezogen auf unser Beispiel mit den Telefonnummern würden Sie einige neue Spalten pro Telefontyp erstellen.
Diese Lösung ist gut anwendbar, wenn Sie sicher sein können, dass sich die Ausprägungen der Telefontypen in Zukunft nicht ändern. Andernfalls müssen Sie Ihren Ladeprozess bei neuen Typen anpassen, um weiterhin alle gelieferten Daten zu erfassen.

Fazit

In diesem zweiten Beitrag zu Multi-Active-Satelliten haben wir die Hintergründe der verschiedenen Modellierungsansätze untersucht. Sie können diese Informationen nutzen, um abhängig von Ihren Datenstrukturen die optimale Multi-Active-Lösung zu wählen.
Beachten Sie dabei, dass es meist ratsam ist, die zu ladende Datenmenge frühzeitig zu begrenzen – wozu sich die LISTAGG()-Funktion hervorragend eignet. Wenn Sie eine Lösung mit potenziell unterschiedlichen LDTS-Werten nutzen, denken Sie daran, diese bei der Abfrage über entsprechende PIT-Tabellen zu berücksichtigen.

Page Title: Multi-Active Satellites richtig nutzen – Teil 1

Multi-Active Satellites in Data Vault 2.0

Mit Multi-Active Satellites können Sie mehrere aktive Datensätze für einen Business-Key speichern. Je nach Struktur der eingehenden Quelldaten gibt es verschiedene Möglichkeiten, diese Multi-Aktivität in Data Vault 2.0 abzubilden. In diesem Beitrag stellen wir Ihnen die verschiedenen Modellierungsoptionen vor.

Was sind Multi-Active Satellites?

Multi-Active Satellites ähneln in ihrem Aufbau den Standard-Satellites. Wie bereits erwähnt, speichern sie jedoch mehrere aktive Datensätze pro Key zu einem bestimmten Zeitpunkt. Die genaue Struktur hängt dabei vom jeweiligen Anwendungsfall ab.
Ein Beispiel für ein solches Data-Vault-Modell finden Sie in Abbildung 1.

Continue Reading

Aufwandsschätzung in Data-Vault-2.0-Projekten

Aufwandsschätzung in Data-Vault-2.0-Projekten

In Data-Vault-2.0-Projekten empfehlen wir, den Aufwand mithilfe einer Function-Point-Analyse (FPA) zu schätzen. Bei der Auswahl einer Methode zur Aufwandsschätzung in agilen IT-Projekten stehen zahlreiche Optionen zur Verfügung. In diesem Artikel erfahren Sie, warum die FPA eine gute Wahl ist und warum Sie die Nutzung dieser Methode für Ihre eigenen Data-Vault-2.0-Projekte in Betracht ziehen sollten.

Das gute alte Planning Poker zur Aufwandsschätzung

Die wahrscheinlich bekannteste Methode zur Aufwandsschätzung in agilen Projekten ist Planning Poker. Im Verlauf des Prozesses werden sogenannte Story Points verwendet, die auf der Fibonacci-Folge (0, 0,5, 1, 2, 3, 5, 8, 13, 20, 40 und 100) basieren, um den Aufwand einer bestimmten Aufgabe zu schätzen. Zu Beginn des Prozesses kommt das gesamte Entwicklungsteam zusammen und jedes Mitglied weist jeder User Story gleichzeitig die aus seiner Sicht angemessenen Story Points zu. Stimmen die Story Points überein, steht die finale Schätzung fest. Kann kein Konsens erzielt werden, wird der Aufwand so lange diskutiert, bis eine Entscheidung getroffen ist.

Es ist jedoch wichtig zu beachten, dass diese Technik einen hohen Aufwand verursacht, wenn entweder zu viele Aufgaben vorliegen oder das Team zu groß ist. Es stellt sich also die Frage: Funktioniert Planning Poker für Data-Vault-Projekte? Die kurze Antwort lautet: „Es ergibt wenig Sinn“. Da in Data Vault 2.0 die fachlichen Anforderungen in kleine Einheiten zerlegt werden, gibt es zahlreiche Aufgaben, die alle diskutiert und bewertet werden müssen. Zudem handelt es sich bei den Teilaufgaben in Data Vault 2.0 um standardisierte Artefakte wie Hubs, Links und Satellites. Im Prinzip stellen diese Artefakte stets denselben Aufwand dar.

Warum eignet sich die Function-Point-Analyse so gut?

Hier kommt die FPA ins Spiel und das ist auch der Grund, warum sie in agilen Softwareprojekten weit verbreitet ist. Die Idee besteht darin, dass Software aus den folgenden Charakteristika besteht, welche die Function Point Types darstellen:

  • External Inputs (EI) → Daten, die in das System gelangen
  • External Outputs (EO), External Inquiries (EQ) → Daten, die das System auf die eine oder andere Weise verlassen
  • Internal Logical Files (ILF) → Daten, die innerhalb des Systems erzeugt und gespeichert werden
  • External Interface Files (EIF) → Daten, die außerhalb des Systems verwaltet werden, aber zur Ausführung der Aufgabe erforderlich sind

Bei der FPA zerlegen Sie die Funktionalität für eine bessere Analyse in kleinere Einheiten. Wie bereits erwähnt, geschieht dies in Data-Vault-2.0-Projekten aufgrund der standardisierten Artefakte ohnehin schon. Aus diesem Grund eignet sich die FPA hervorragend für Data-Vault-Projekte.

Wie Sie die FPA in Data Vault 2.0 anwenden

Um die FPA in der Data-Vault-2.0-Methodik gewinnbringend einzusetzen, müssen die funktionalen Merkmale von Software – External Inputs, External Outputs, External Inquiries, Internal Logical Files und External Interface Files – an Data-Vault-Projekte angepasst werden. Die funktionalen Merkmale von Data Warehouses, die mit Data Vault aufgebaut sind, werden wie folgt definiert:

  • Stage load (EI)
  • Hub load (ILF)
  • Link load (ILF)
  • Satellite load (ILF)
  • Dimension load (ILF)
  • Fact load (ILF)
  • Report build (EO)

Bitte beachten Sie, dass auch weitere funktionale Komponenten definiert werden können, wie beispielsweise Business-Vault-Entitäten, Point-in-Time-Tabellen usw. Sobald Sie diese Komponenten definiert haben, sollten Sie eine Tabelle erstellen, die diese den Function Points zuordnet. Function Points dienen dazu, den Umfang der fachlichen Funktionalität zu quantifizieren, die ein Element einem Anwender bietet. Im Allgemeinen wird empfohlen, zunächst einen Komplexitätsfaktor hinzuzufügen.

Complexity Factor Person Hours per Function Point
Easy 0.1
Moderate 0.2
Difficult 0.7

Verwenden Sie anschließend die Komplexitätsfaktoren und die zugewiesenen Function Points pro Komponente, um die geschätzte Stundenzahl zu berechnen, die für das Hinzufügen der jeweiligen Funktionalität erforderlich ist. Hier ist ein kurzes Beispiel dafür, wie eine solche Zuordnungstabelle für Sie aussehen könnte:

Component Complexity Factor Estimated Function Points Estimated Total Hours
Hub Load Easy 2 0.2
Dimension Load Difficult 3 2.1
Report Build Difficult 5 3.5

Das Ziel der Schätzung besteht darin, die Entwicklung operationaler Informationssysteme zu standardisieren, indem der Aufwand berechenbarer gemacht wird. Wenn Sie einen systematischen Ansatz verwenden, um den erforderlichen Aufwand für das Hinzufügen von Komponenten zu schätzen, können Sie die geschätzten Werte nach Bereitstellung der Funktionalität mit den tatsächlichen Werten vergleichen. Durch den Vergleich beider Werte kann Ihr Team aus vergangenen Schätzungen lernen und künftige Schätzungen verbessern, indem die Function Points pro Komponente angepasst werden. Denken Sie auch daran, dass Ihre Entwickler im Laufe der Zeit an Erfahrung gewinnen oder durch Personalwechsel Erfahrung verloren gehen kann.

Fazit

Ich hoffe, dieser erste Einblick in die FPA hilft Ihnen zu verstehen, welchen grundlegenden Mehrwert sie Ihrem Team in Data-Vault-2.0-Projekten bieten kann. Einen tieferen Einblick in die Anwendung der FPA in Data-Vault-2.0-Projekten erhalten Sie im Buch „Building a Scalable Data Warehouse with Data Vault 2.0“ von Michael Olschimke und Dan Lindstedt.

Organisation von Informationsanforderungen

Nur eine Empfehlung … wie wir unsere Informationsanforderungen organisieren


Fachanwender in sämtlichen Branchen sind auf verlässliche Informationen angewiesen. Im Rahmen unserer Beratungsprojekte stellen wir jedoch häufig fest, dass es an einer präzisen Beschreibung dessen fehlt, was die Fachbereiche tatsächlich benötigen.

Daher möchten wir Ihnen in diesem Artikel zeigen, wie wir Informationsanforderungen sowohl intern bei Scalefree als auch für viele unserer Kunden strukturieren.

Was ist mit User Stories?

Wir alle kennen User Stories aus Scrum und vielen Business-Intelligence-Projekten.
Ihre typische Struktur sieht etwa so aus:

Als <Benutzertyp>möchte ich <some goal> damit <ein Grund/Nutzen>.

Das folgende Beispiel zeigt eine typische User Story, wie wir sie in einem Projekt vorfinden könnten:

Als <Marketing-Mitarbeiter>möchte ich <einen Übersichtsbericht mit der Anzahl der Leads aus einem Marketingkanal> damit <ich das Marketingbudget entsprechend anpassen kann>.

Was fangen wir nun mit dieser User Story an?
Es fehlen viele Details. Zwar gibt es das Product Backlog Refinement, doch für Vorhaben im Bereich Business Intelligence reicht eine User Story allein meist nicht aus – eine detailliertere Strukturierung ist hier zwingend erforderlich.

Informationsanforderungen

Entwickler im Bereich Enterprise Data Warehousing und Business Intelligence benötigen weitaus mehr Details als nur eine reine User Story. Dennoch ist sie ein guter Ausgangspunkt für die Informationsanforderung und kann hervorragend als Einleitung dienen. Die Gesamtstruktur sieht wie folgt aus:
Continue Reading

Über Information Marts in Data Vault 2.0 – Teil 1

Information Marts in Data Vault 2.0

In der Data-Vault-2.0-Architektur werden Information Marts genutzt, um Endanwendern Informationen bereitzustellen. Konzeptionell entspricht ein Information Mart der Definition eines Data Marts im klassischen Data Warehousing. Dort dient ein Data Mart jedoch dazu, nutzbare Informationen statt Rohdaten bereitzustellen. Aus diesem Grund wurde die Komponente in Data Vault 2.0 in Information Mart umbenannt, um diesen Anwendungsfall präziser abzubilden.


Einführung in Information Marts

Die Definition von Information Marts umfasst jedoch noch weitere Facetten. Im Buch „Building a Scalable Data Warehouse with Data Vault 2.0“ stellen wir drei Arten von Marts vor:

  • Information Marts: Dienen der Bereitstellung von Informationen für Fachanwender, typischerweise über Dashboards und Berichte.
  • Metrics Mart: Wird in Kombination mit einem Metrics Vault genutzt, der EDW-Logdaten in einem Data-Vault-Modell erfasst. Der Metrics Mart wird aus dem Metrics Vault abgeleitet. Er stellt Metriken bereit, mit denen sich Performance-Engpässe sowie der Ressourcenverbrauch von Power Usern und Data Scientists in verwalteten Self-Service-BI-Lösungen analysieren lassen.
  • Error Mart: Speichert diejenigen Datensätze, die beim Laden der Daten in das Enterprise Data Warehouse typischerweise eine Hard Rule verletzen.

Information Marts im Consulting

Zusätzlich zu diesen klassischen Information Marts setzen wir in unserer Beratungspraxis weitere Typen ein:

  • Interface Mart: Hierbei handelt es sich im Prinzip um einen Information Mart. Die Informationen werden jedoch nicht an Menschen (etwa über ein Dashboard oder einen Bericht) übermittelt, sondern an eine nachgelagerte Anwendung oder als Write-Back an das Quellsystem geliefert – beispielsweise wenn das Enterprise Data Warehouse zur Datenbereinigung genutzt wird.
  • Quality Mart: Ein Information Mart, der nicht der Bereinigung fehlerhafter Daten dient, sondern der Berichterstattung darüber. Im Wesentlichen stellt er die Logik zur Datenbereinigung auf den Kopf: Nur fehlerhafte Daten (manchmal auch als „bad and ugly data“ bezeichnet) werden an den Endanwender, beispielsweise den Data Steward, geliefert. Dies geschieht häufig in Kombination mit Data-Cleansing-Frontends, in denen Data Stewards Quelldaten korrigieren oder Ausnahmen kommentieren und verschlagworten können.
  • Source Mart: Ebenfalls ein Information Mart, der jedoch auf gängige Strukturen wie Star-Schemata, Snowflake-Schemata oder vollständig denormalisierte Schemata verzichtet. Stattdessen nutzt er das Datenmodell der Quellanwendung, ähnlich dem Schema eines Operational Data Store (ODS). Der Source Mart ist keine physische Kopie der Daten, sondern ein virtualisiertes Modell auf Ebene des Data-Vault-Modells, das die ursprünglichen Strukturen widerspiegelt. Er eignet sich hervorragend für Ad-hoc-Berichte und bietet Data Scientists sowie Power Usern einen hohen Mehrwert.

Damit ist unsere Übersicht der Information Marts komplett. Wir haben diese Varianten in zahlreichen Kundenprojekten erfolgreich eingesetzt, um den konkreten Nutzen und den Einsatz von Information Marts in Organisationen verständlich zu vermitteln.

Fazit

Information Marts sind in Data Vault 2.0 essenziell, um aufbereitete Daten über Berichte und Dashboards für Endanwender bereitzustellen. Varianten wie Metrics Marts und Error Marts optimieren die Performance-Analyse sowie das Datenqualitätsmanagement. Darüber hinaus decken spezialisierte Typen wie Interface, Quality und Source Marts spezifische Fachanforderungen ab und gewährleisten eine flexible sowie effiziente Datenbereitstellung.

Granularitäten von Business Vault Entities

Der Business Vault ist die Schicht in der Data Vault 2.0-Architektur, in der die Business-Logik implementiert wird, um Daten zu transformieren, zu bereinigen und zu modifizieren.

Das Buch „Building a Scalable Data Warehouse with Data Vault 2.0“ der Scalefree-Gründer Dan Linstedt und Michael Olschimke sowie das Data Vault 2.0 Boot Camp zeigen, wie eine solche Business-Logik unter Verwendung verschiedener Business Vault Entities, wie beispielsweise Computed Satellites, implementiert werden kann.

Es ist jedoch wichtig zu beachten, dass dies nur ein Teil des Gesamtbildes ist. Das Buch zeigt Computed Satellites (und andere Entities) mit einem Load Date im Primary Key des Computed Satellite. Solche Satellites eignen sich hervorragend, um die Ergebnisse einer Business-Logik zu erfassen, die auf eingehende Deltas angewendet wird. Es gibt jedoch zwei verschiedene Arten von Granularitäten für die Business-Logik im Business Vault: Continue Reading

Data Warehousing und warum wir es brauchen

Data Warehousing

Ein Data Warehouse ist eine themenorientierte, nicht-volatile, integrierte und zeitvariante Sammlung von Daten zur Unterstützung von Managemententscheidungen
(Inmon, W. H., 2005: Building the Data Warehouse. Indianapolis, Ind.: Wiley).

Data Warehousing bietet die Infrastruktur, die für eine effektive Nutzung von Business Intelligence erforderlich ist. Sein Zweck ist es, Daten aus verschiedenen Quellsystemen zu integrieren und eine historisierte Datenbank bereitzustellen. Durch ein DWH lässt sich ein konsistentes und zuverlässiges Reporting sicherstellen. Eine standardisierte Sicht auf die Daten verhindert Interpretationsfehler, verbessert die Datenqualität und führt zu fundierteren Entscheidungen. Darüber hinaus bietet die Historisierung von Daten zusätzliche Analysemöglichkeiten und garantiert vollständige Revisionssicherheit.

Data Warehousing – Warum wir es brauchen

In diesem Webinar wird näher darauf eingegangen, wie ein Data Warehouse Daten aus verschiedenen Quellen integriert, um Business Intelligence durch eine zentrale, historisierte Datenbank zu unterstützen. Diese Integration gewährleistet ein konsistentes sowie zuverlässiges Reporting, erhöht die Datenqualität und erleichtert die Entscheidungsfindung. Zudem ermöglicht die Speicherung historischer Daten umfassende Analysen und eine lückenlose Revisionssicherheit.

Watch webinar recording

Warum brauchen wir Data Warehousing?

„Warum brauchen wir Data Warehousing für das Reporting? Wir haben doch Excel-Tabellen!“

Excel ist unbestreitbar ein hervorragendes Werkzeug, allerdings führt seine unkontrollierte Nutzung häufig dazu, dass Sie den Überblick über Ihre Daten und Berichte verlieren.

Sie können Berichte zwar direkt aus einer einzelnen Datenquelle erstellen, sind dabei jedoch in Funktionsumfang und Governance stark eingeschränkt. Zudem lassen sich Berichte so nur aus einem einzigen Quellsystem generieren, ohne dass eine delta-getriebene Historisierung der Daten stattfindet. Wenn Sie Berichte direkt im Quellsystem erstellen und lokal auf einem PC speichern, lässt sich nicht mehr nachvollziehen, welcher Benutzer zu welchem Zeitpunkt welche Daten extrahiert hat. Dadurch verlieren die Berichte ihre Verlässlichkeit. Genau hier setzt Data Warehousing an.

Stellen Sie sich vor, Ihr Ziel ist es, ein Dashboard für Umsatzerlöse auf der Grundlage von Zeitverläufen, Kundengruppen, Produkten und Regionen zu erstellen. Ohne ein DWH müssen Sie sämtliche Daten manuell aus allen erforderlichen Quellsystemen zusammentragen. Bei diesen Daten handelt es sich meist um eine Mischung aus strukturierten, unstrukturierten und semistrukturierten Formaten. Die Herausforderung besteht anschließend darin, die Daten aufzubereiten, zu visualisieren und einen dauerhaft reproduzierbaren Prozess zu etablieren. Das ist äußerst zeitintensiv und kostspielig.
Bis alle Daten gesammelt und aufbereitet sind, können sie bereits veraltet sein – und der Prozess beginnt von vorn.

Ein DWH führt sämtliche Daten an einem zentralen Ort zusammen. Die Daten werden fachlich ausgerichtet (integriert und themenorientiert) und mit standardisierten Definitionen versehen (z. B. für KPIs), sodass jeder Bericht die Informationen auf dieselbe Weise interpretiert. Der Zugriff auf das DWH erfolgt rein lesend (nicht-volatil): Einmal geladene Daten können nicht mehr manuell verändert werden, was die Revisionssicherheit garantiert. Dies ermöglicht eine vollständige Historisierung (zeitvariant). Da alle Daten geordnet bereitstehen, lassen sich die Anforderungen der Anwender gezielt erfüllen (strukturierte, nach Fachbegriffen integrierte Daten). Für Fachanwender eröffnet dies zudem die Möglichkeit, Self-Service-BI effektiv zu nutzen.

Was ist mit einem Data Lake?

Als der Begriff „Data Lake“ vor einigen Jahren aufkam, wurde vielfach angenommen, er würde das Data Warehouse vollständig ersetzen.
Ein Data Lake ist eine hervorragende Umgebung, wenn er als erste Landing-Zone für Daten in der IT-Infrastruktur dient. Allerdings integriert er Daten nicht in der Weise, wie es ein Data Warehouse tut.
Ein Data Lake kann genutzt werden, um Daten downstream in ein Data Warehouse sowie in einen Informationsbereitstellungsbereich (Information Delivery Area) weiterzuverarbeiten. An dieser Stelle ist eine klare Struktur essenziell, damit sich Ihr Data Lake nicht in einen unstrukturierten Data Dump verwandelt und benötigte Daten jederzeit mühelos abgefragt werden können.

Dafür ist ein durchdachtes Architekturdesign erforderlich, das genau festlegt, wie Daten aus dem Data Lake in das Data Warehouse überführt werden. Je nach Datenmenge und erforderlicher Performance für die Endnutzer kann dieser Prozess auch vollständig virtualisiert ablaufen.

Für Data Scientists ist ein Data Lake ebenfalls ein idealer Ort, um schnellstmöglich Zugriff auf Rohdaten in ihrem nativen Format zu erhalten. Für Endnutzer hingegen, die strukturierte Daten für Reporting-, Dashboarding- und Analysezwecke benötigen, ist ein strukturiertes, integriertes, leistungsstarkes und leicht zugängliches Data Warehouse unverzichtbar. Sie erwarten aufbereitete Daten in einem Information Mart, etwa in Form eines Star-Schemas oder einer breiten Denormalisierungstabelle.

Fazit: Wenn Sie einen Data Lake nutzen möchten, definieren Sie im Vorfeld, in welcher Form die Daten für die Weiterverarbeitung benötigt werden, um die passende Struktur zu schaffen. Wenn Sie keine integrierten, themenorientierten und zeitvarianten Daten benötigen, kann ein Data Lake allein ausreichen. Benötigen Sie jedoch genau diese Eigenschaften, führt an einem Data Warehouse kein Weg vorbei.

Wie funktioniert Data Warehousing?

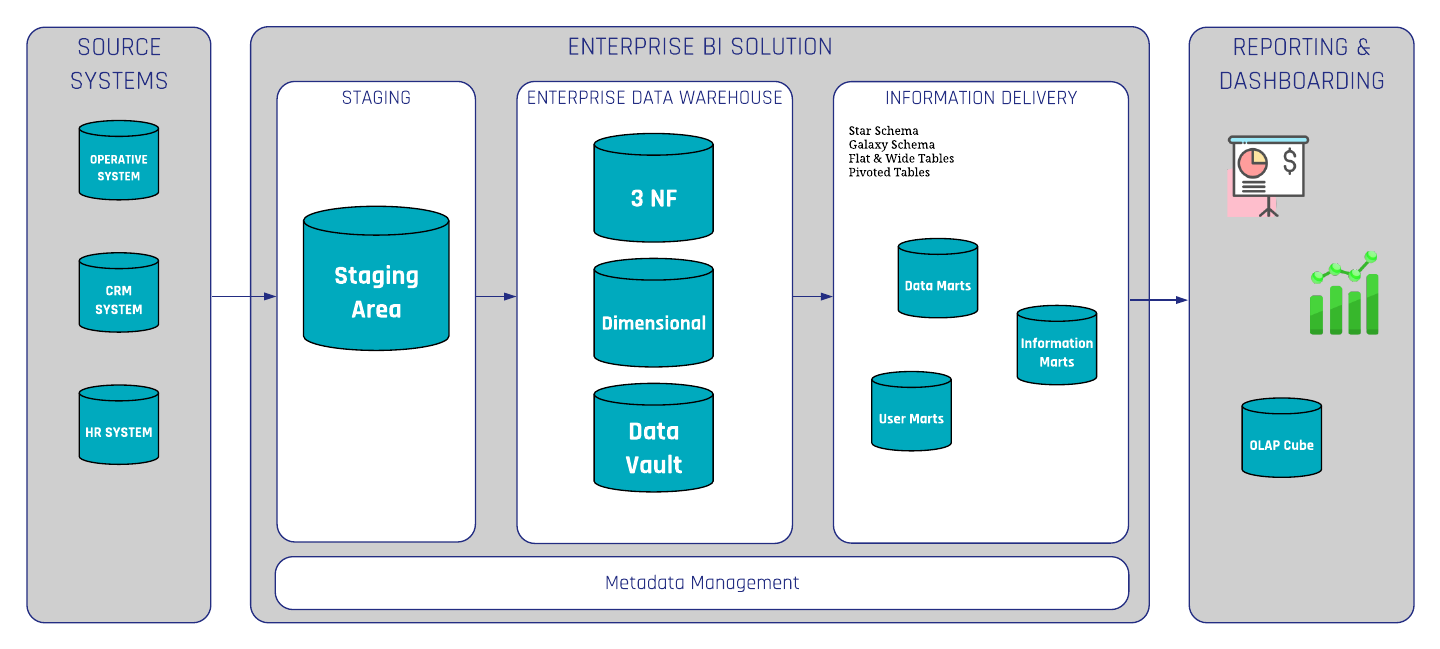
Der Prozess beginnt mit dem ETL-Verfahren (Extract, Transform, Load). Dabei werden die Daten aus den Quellsystemen extrahiert und in eine technische Zwischenumgebung der DWH-Infrastruktur geladen, die sogenannte Staging Area. Nach dem Extrahieren werden die Daten in eine themenorientierte Struktur integriert. Das Ergebnis ist ein Enterprise Data Warehouse (EDW), das Daten und Informationen exakt so bereitstellt, wie sie für die Endnutzung benötigt werden.

Für den Aufbau eines Data Warehouse stehen verschiedene Modellierungsansätze zur Verfügung. Die 3NF (dritte Normalform) wurde von Bill Inmon entwickelt und folgt einem Top-down-Ansatz. Das Dimensional Modeling nach Kimball orientiert sich hingegen stärker an den konkreten Geschäftsprozessen (Bottom-up-Ansatz). Data Vault 2.0 ist ein von Dan Linstedt entwickeltes Hybridmodell aus 3NF und dimensionaler Modellierung. Bei Scalefree haben wir uns auf die Data-Vault-2.0-Modellierung spezialisiert.

Data-Warehousing-Referenzarchitektur

Fazit

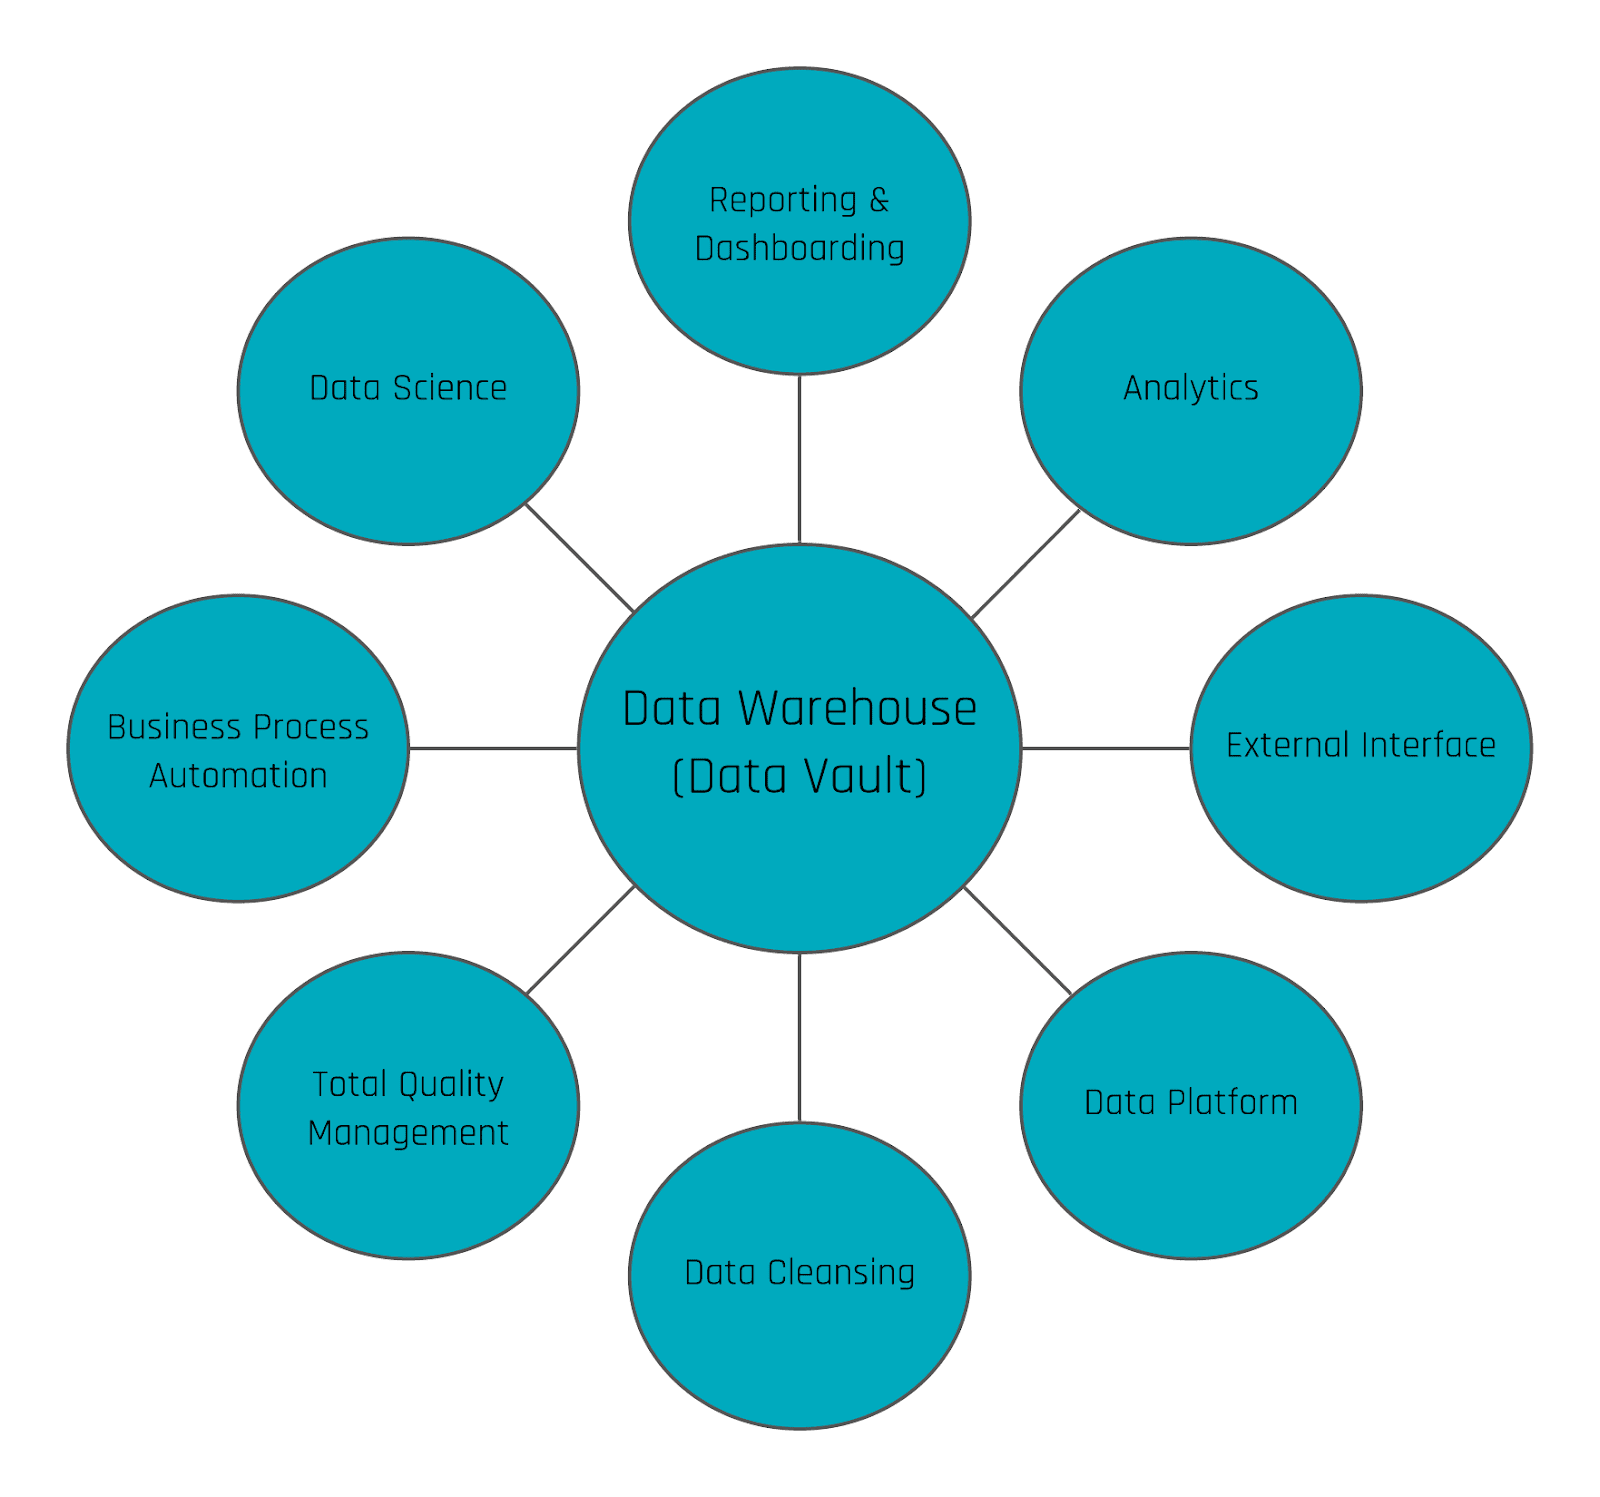
Wenn Unternehmen ein EDW lediglich für grundlegende Standardberichte nutzen, schöpfen sie das volle Potenzial ihrer Daten nicht aus. Mit einem modernen Data Warehouse lässt sich eine Vielzahl erweiterter Anwendungsfälle realisieren – beispielsweise die Optimierung und Automatisierung operativer Prozesse, prädikative Analysen, das Rückspielen von Daten in operative Systeme oder das Auslösen automatisierter Ereignisse außerhalb des Data Warehouse.

Data Warehousing Use cases

Data-Vault-2.0-Anwendungsfälle

Data Warehousing ist die ideale Lösung, um alle internen und externen Datenquellen zentral zusammenzuführen. Die Standardisierung strukturierter, unstrukturierten und semistrukturierten Daten ermöglicht ein schnelleres und verlässlicheres Reporting. Die Historisierung erlaubt tiefergehende Analysen sowie die exakte Rekonstruktion historischer Berichte. Dank der Flexibilität von Data Vault 2.0 können Unternehmen innovative Funktionen nutzen, die weit über klassisches Reporting und Dashboarding hinausgehen.

Möchten Sie mehr über die Anwendungsfälle von Data Vault 2.0 und moderne Datentechnologien erfahren? In unserem Blog, unserem Newsletter und unseren Webinaren bieten wir Ihnen ein breites Spektrum an kostenfreiem Fachwissen. Melden Sie sich gerne für unsere regelmäßigen Updates an.

Umgang mit der Validierung von Beziehungen in Data Vault 2.0

Validation of relationships in Data Vault 2.0

Validierung von Beziehungen in Data Vault 2.0

Es gibt verschiedene Möglichkeiten, die Validierung von Beziehungen aus Quellsystemen zu handhaben. Dies hängt davon ab, wie die Daten geliefert werden (Full-Extract oder CDC) und wie ein Löschvorgang vom Quellsystem übermittelt wird – beispielsweise als Soft Delete oder Hard Delete. In Data Vault 2.0 unterscheiden wir Daten nach Schlüsseln (Keys), Beziehungen und Beschreibungen.

Dennoch ist die Handhabung und Validierung von Beziehungen in Data Vault 2.0 ein oft unterschätzter Aspekt.
Im folgenden Blogartikel erklären wir, was Sie beachten müssen und wie Sie am besten damit umgehen.


Löschungen in Data Vault 2.0

Zuerst betrachten wir die verschiedenen Arten von Löschungen (Deletes) in Quellsystemen:

  1. Hard Delete – Ein Datensatz wird im Quellsystem physisch gelöscht und existiert dort nicht mehr.
  2. Soft Delete – Der gelöschte Datensatz bleibt in der Datenbank des Quellsystems bestehen, wird jedoch als gelöscht gekennzeichnet.

Als Nächstes untersuchen wir, wie wir diese Daten in der Staging Area identifizieren:

  1. Full-Extract – Dies kann der aktuelle Zustand des Quellsystems oder ein Delta- bzw. inkrementeller Extrakt sein.
  2. CDC (Change Data Capture) – Es werden nur neue, aktualisierte oder gelöschte Datensätze geliefert, um Daten inkrementell oder als Delta zu laden.

Um die folgende Erklärung so einfach wie möglich zu halten, gehen wir davon aus, dass wir Beziehungen als gelöscht markieren wollen, sobald wir die Löschinformationen erhalten – selbst wenn kein Audit-Trail aus dem Quellsystem vorliegt (Data Aging ist hierbei ein anderes Thema).

Erkennung von Löschungen und Validierung von Beziehungen in Data Vault 2.0

Die Erkennung von Löschungen für Business Keys oder Hubs ist unkompliziert. Soft Deletes werden direkt als beschreibende Attribute im Satelliten behandelt – unabhängig davon, ob die Daten aus einem Full-Extract oder über CDC eingehen. Bei Hard Deletes im Quellsystem müssen wir hingegen zwischen Full-Extract und CDC unterscheiden.
Hier führen wir den Effectivity-Satelliten ein. Dabei gilt:

  1. Full-Extract – Führen Sie einen Abgleich (Lookup) mit der Staging Area durch, um zu prüfen, ob der Business Key noch existiert. Wenn nicht, fügen Sie einen Datensatz mit den Löschinformationen (d. h. ein Flag und ein Datum) in den Effectivity-Satelliten ein.
  2. CDC – Sie erhalten eine „Delete“-Information, was direkt zu einem neuen Eintrag im Effectivity-Satelliten führt.

Die Erkennung gelöschter Beziehungen erfordert etwas mehr Aufmerksamkeit und wird oft übersehen. Bei einem Full-Extract können Sie denselben Ansatz wie bei Business Keys verfolgen: Prüfen Sie einfach, ob der Link-Hash-Key im aktuellen Staging-Ladevorgang vorhanden ist, und fügen Sie bei Bedarf einen neuen Eintrag in den Effectivity-Satelliten ein.

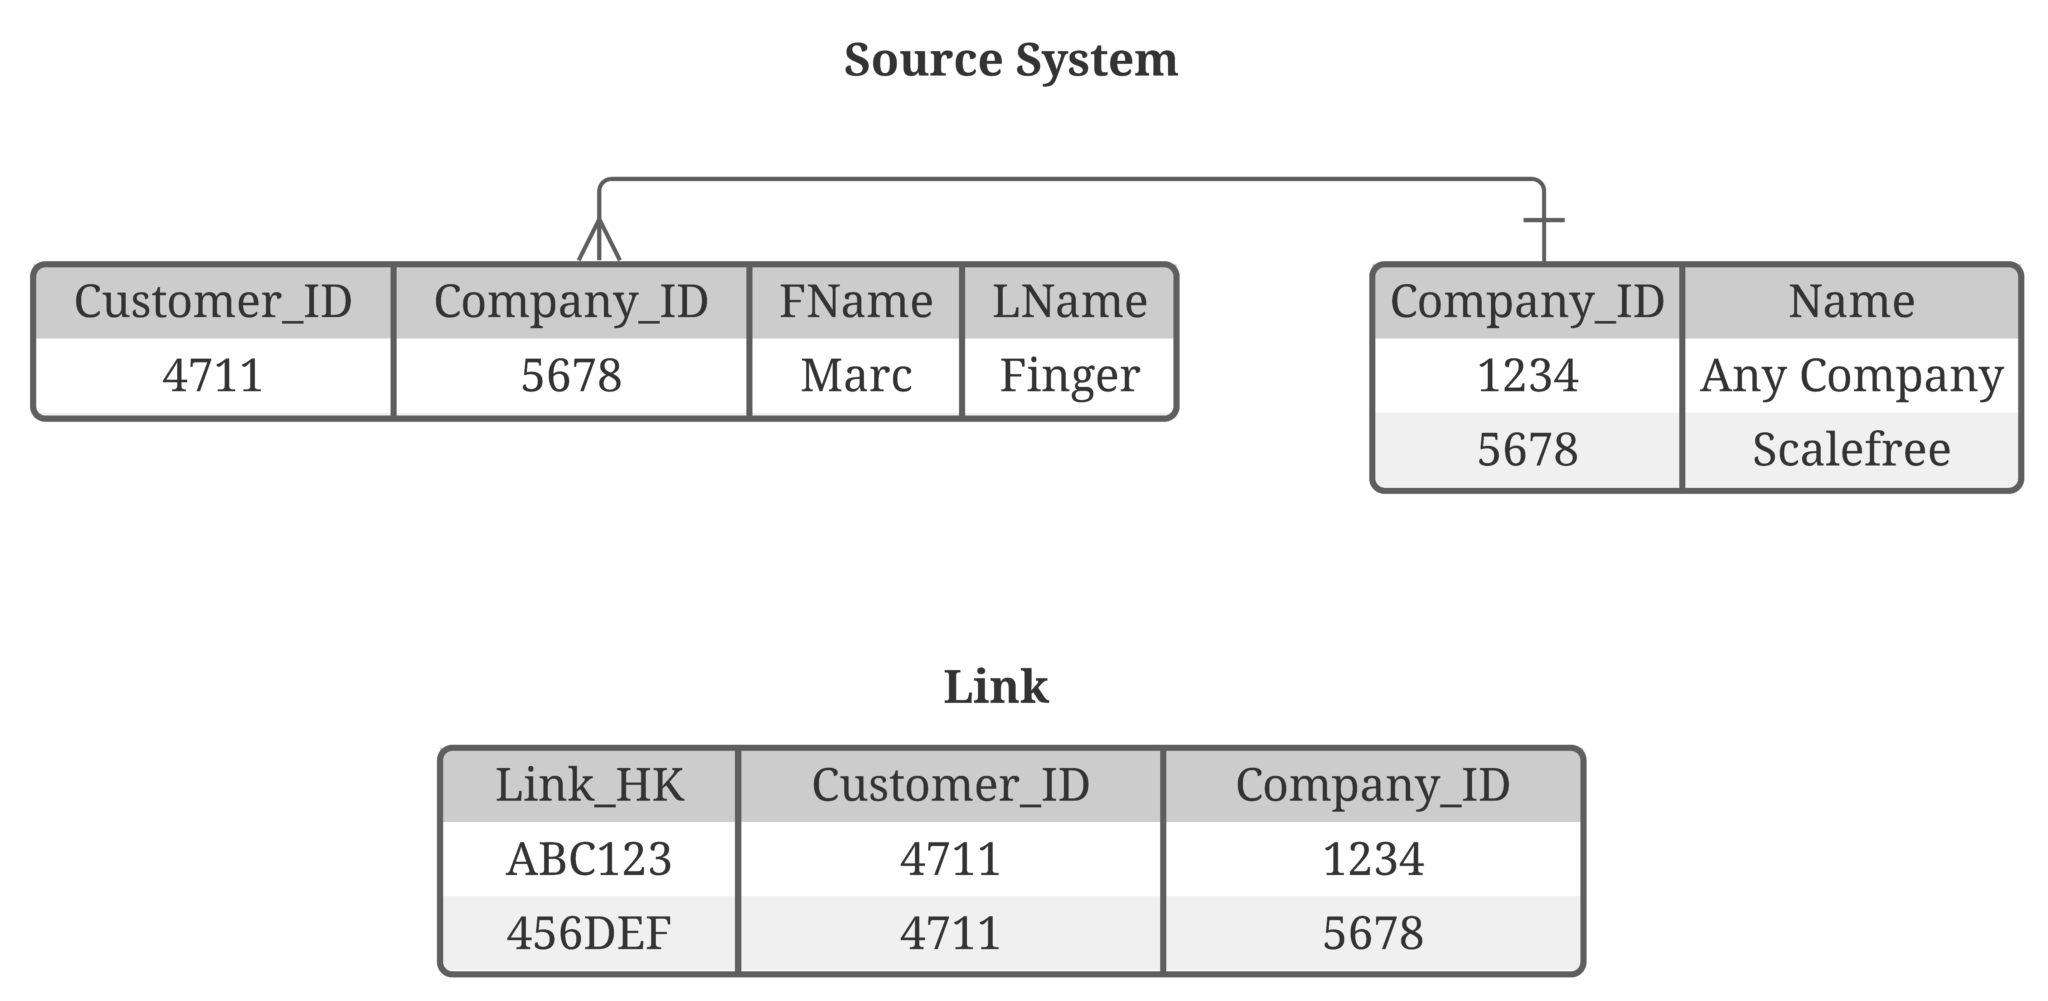
Heutzutage setzt sich CDC immer mehr durch. Da diese Methode jedoch nur Deltas liefert, besteht die Herausforderung darin, nicht mehr existierende Beziehungen zu identifizieren. Das folgende Beispiel zeigt eine Beziehung zwischen den Business-Objekten Customer und Company. Dies ist eine 1:n-Beziehung:

Validation of relationships in Data Vault 2.0

Abbildung 1: Tabellen Customer und Company

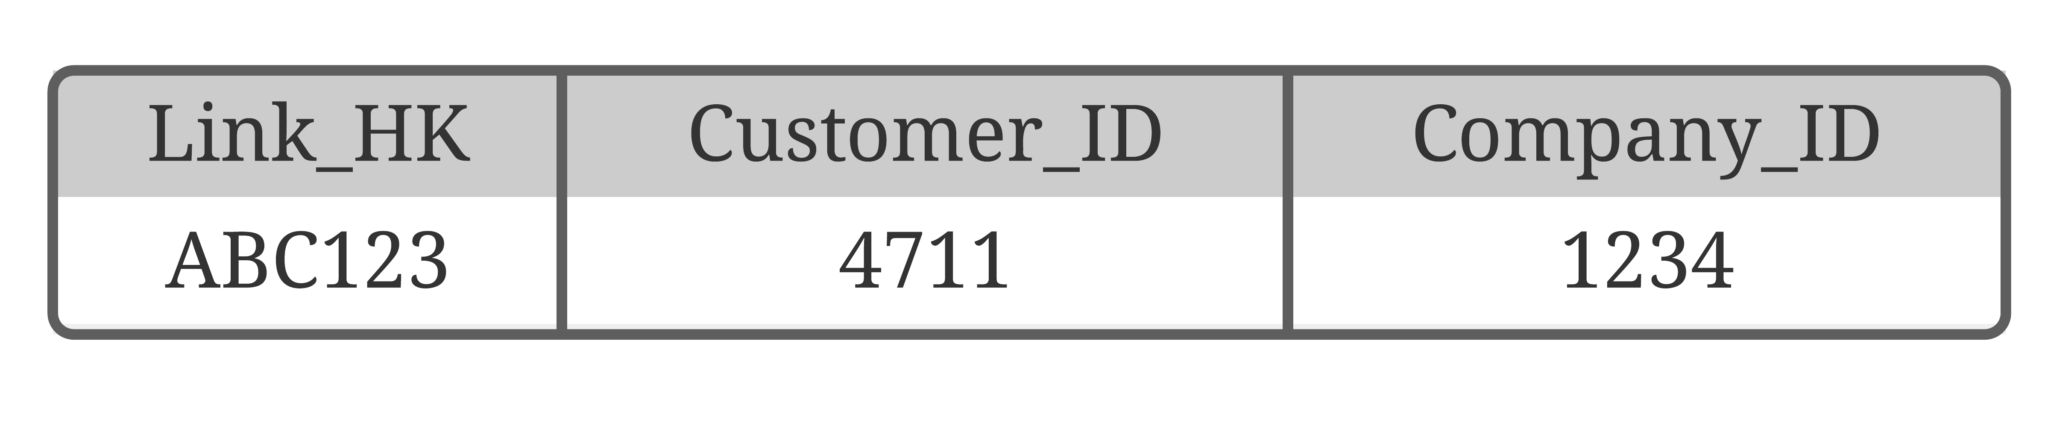
Die Link-Tabelle in Data Vault sieht wie folgt aus:

Validation of relationships in Data Vault 2.0

Tabelle 1: Customer-Link

Zur besseren Lesbarkeit und Vereinfachung stellen wir die Business Keys anstelle von Hash-Keys dar und verzichten auf die Darstellung von Systemfeldern wie dem Load-Date-Timestamp und der Record-Source.

So weit, so gut. Was passiert jedoch, wenn ein Kunde für ein anderes Unternehmen tätig wird? Dies führt zu einem neuen Datensatz in der Link-Tabelle. Der CDC-Mechanismus liefert die Daten als Update der Customer-Tabelle.

Validation of relationships in Data Vault 2.0

Abbildung 2: Quelltabellen und Link nach Unternehmenswechsel

Woher stammt die Information, dass Customer 4711 nicht mehr für Company 1234 arbeitet, und wo wird diese gespeichert? Es muss ein Soft Delete für den alten Link-Eintrag im Data Warehouse durchgeführt werden, um die Datenkonsistenz zu wahren. Aktuell sieht es so aus, als ob der Kunde für beide Unternehmen tätig wäre, da beide Links aktiv sind.

Hierfür gibt es zwei mögliche Lösungswege:

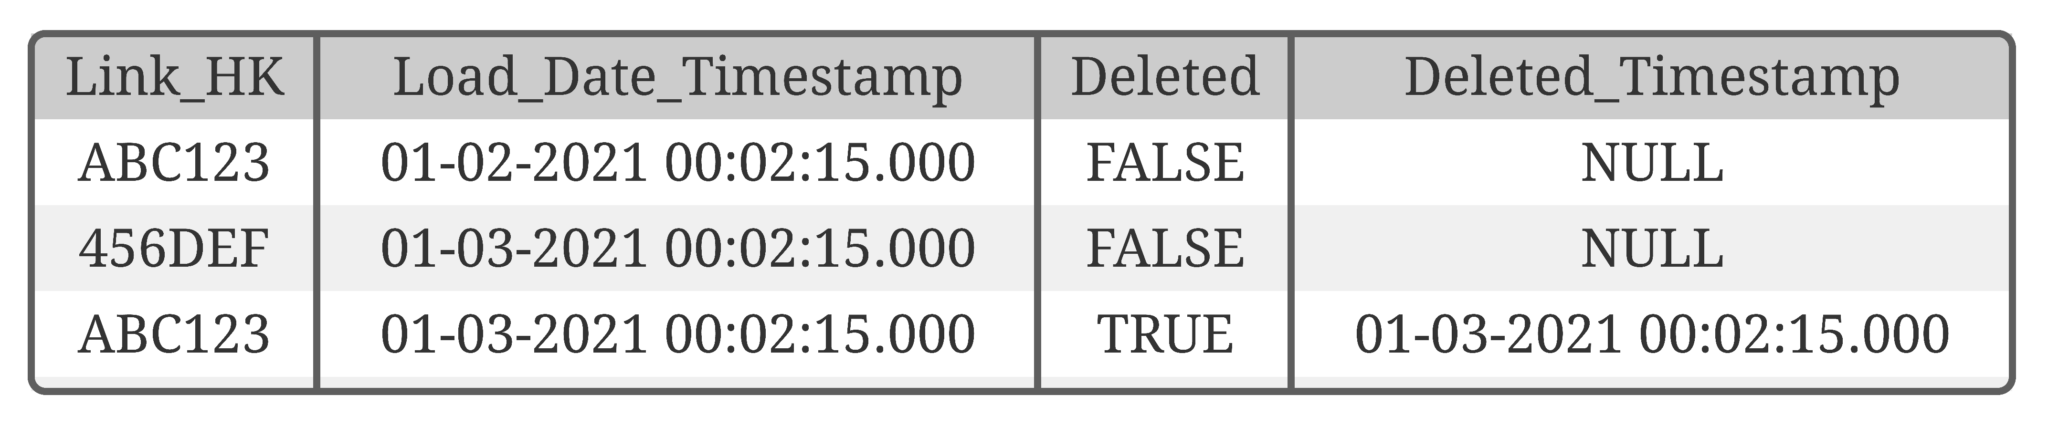
  1. Sie erhalten die „Gültig von“- und „Gültig bis“-Angaben in Ihrem Audit-Trail und identifizieren eine Differenz bei der company_id. In diesem Fall erstellen Sie zwei neue Einträge im Effectivity-Satelliten: Der erste markiert die alte Beziehung (von) als gelöscht, der zweite die neue Beziehung (bis) als aktiv (nicht gelöscht). Es ist notwendig, neue Beziehungen als „nicht gelöscht“ einzufügen, damit Sie Hash-Keys flexibel aktivieren und deaktivieren können.
    Bedenken Sie dabei auch das Szenario, dass Customer 4711 später wieder für Company 1234 tätig wird.
  2. Falls diese Angaben fehlen, müssen Sie die CDC-Daten entweder in eine Persistent Staging Area (PSA) laden, um die gesamte Historie der gelieferten Daten aufzubewahren, oder in ein Source Replica überführen. Im Source Replica erstellen Sie ein Spiegelbild des Quellsystems, indem Sie es mit den CDC-Daten speisen. Dabei führen Sie bei einem „Update“-Signal ein Hard Update und bei einem „Delete“-Signal ein Hard Delete durch. Bei der Verwendung eines Source Replica können Sie denselben Ansatz wie bei Vollabzügen (Full-Loads) verfolgen: Sie führen einen Join auf das Replica aus, um zu prüfen, ob der Hash-Key noch existiert.
    Der größte Nachteil dieser Methode ist der höhere Scan-Aufwand, was zu einer höheren I/O-Last führt. Bei der Verwendung einer Persistent Staging Area können Sie Änderungen in einer Beziehung mithilfe der Window-Funktion lead() ermitteln. Dabei partitionieren Sie nach der technischen ID (in diesem Fall Customer_ID) und sortieren nach dem Load Date Timestamp.
    Sobald sich der Link-Hash-Key unterscheidet, hat sich die Beziehung geändert und die vorherige existiert nicht mehr..

Das Ergebnis ist der folgende (logische) Effectivity-Satellit:

Validation of relationships in Data Vault 2.0

Tabelle 2: Effectivity-Satellit auf dem Link

Fazit

In diesem Artikel haben wir zwei wesentliche Aspekte behandelt. Erstens extrahieren wir in Data Vault 2.0 Beziehungsinformationen direkt aus den Quelltabellen, weshalb die Validierung dieser Informationen besondere Aufmerksamkeit erfordert.
Zweitens bietet Ihnen die Art der Datenbereitstellung (Delta via CDC oder Full-Extract) unterschiedliche Optionen für den Ladevorgang. Bei großen Datenmengen ist CDC definitiv die bevorzugte Methode. Zudem erfasst der CDC-Mechanismus alle Änderungen direkt aus der Quelle, was das Laden von Daten in (nahezu) Echtzeit erheblich erleichtert.

Write-Backs in der Enterprise-Data-Warehouse-Architektur

Managed Self Service BI and write backs

Die Data-Vault-2.0-Schichten

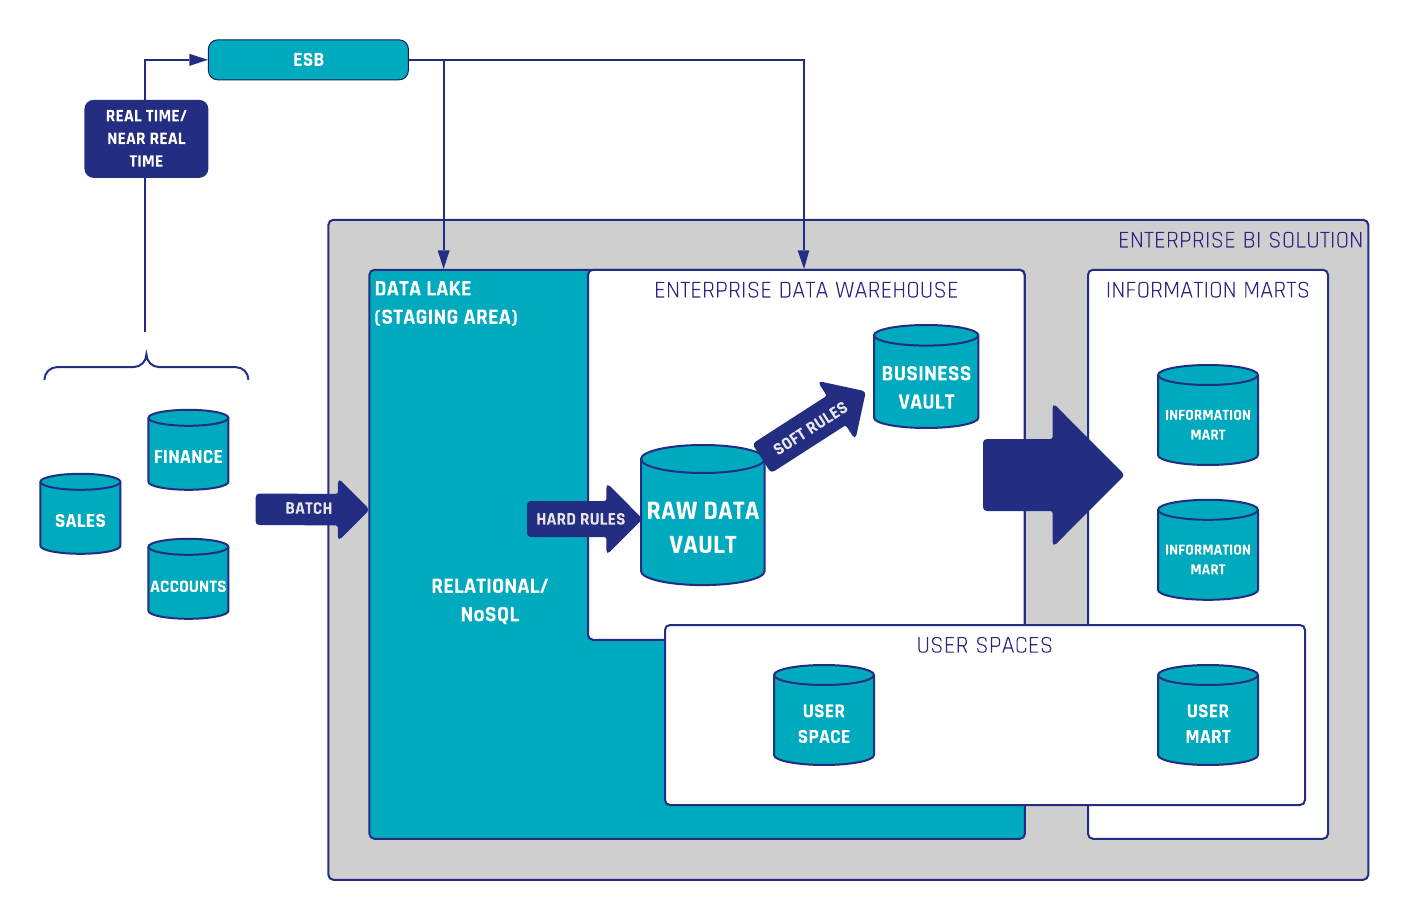
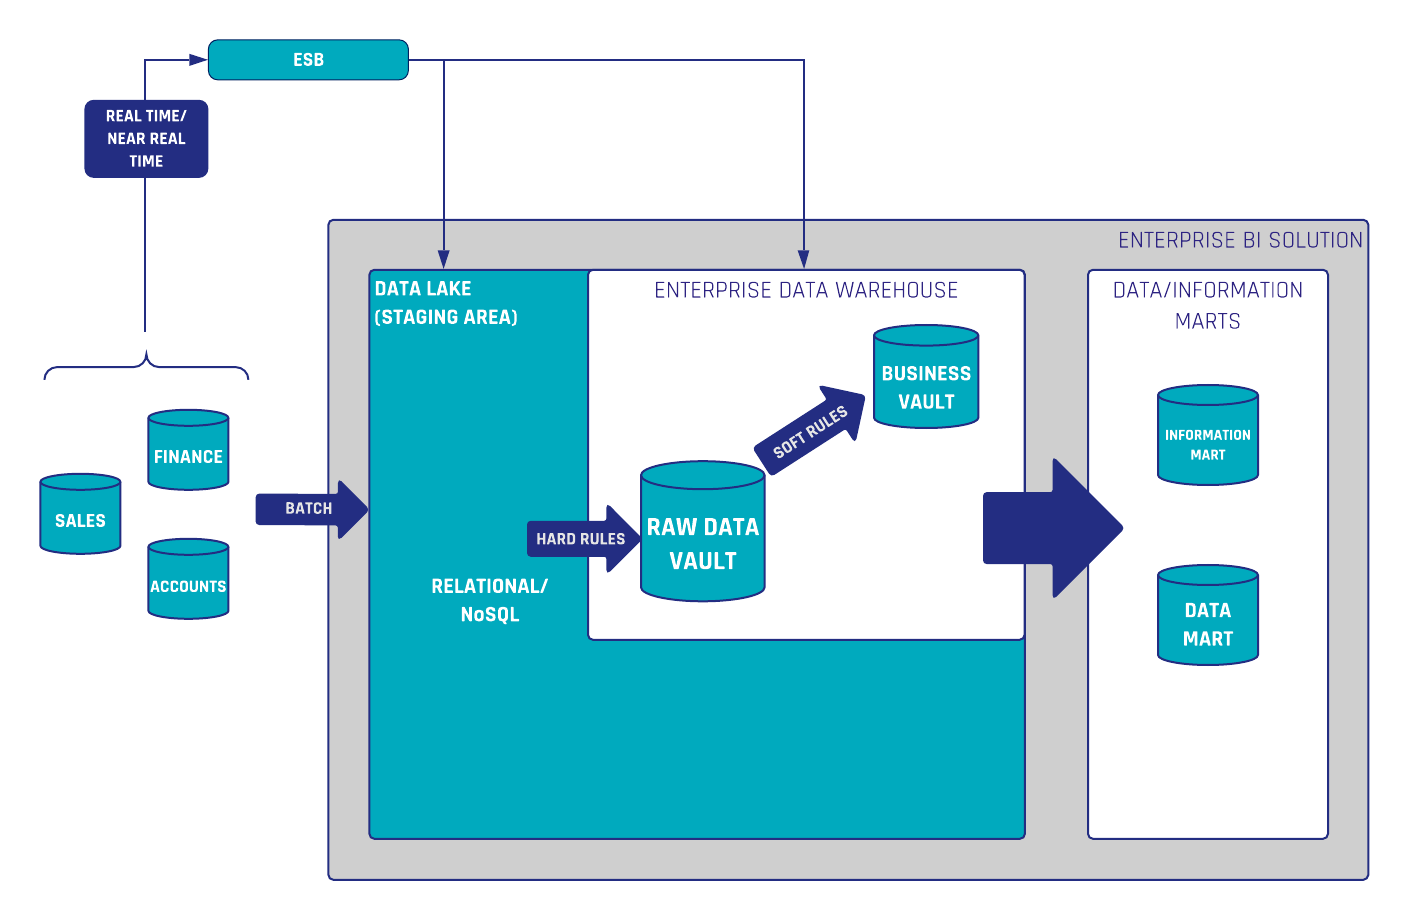
Diese Ausgabe behandelt Write-Backs in das Enterprise-Data-Warehouse und zeigt, wie die Data-Vault-2.0-Architektur diese ermöglicht. Viele kennen bereits die klassische Drei-Schichten-Architektur von Data Warehouses, die auch in Data Vault 2.0 verwendet wird. Die erste Schicht bildet die Staging Area, welche die Rohdaten (Raw Data) aus den Quellsystemen aufnimmt. Die zweite Schicht ist die Enterprise-Data-Warehouse-Schicht mit dem Data-Vault-2.0-Modell. Die dritte Schicht umfasst die Information Marts, welche die Daten in verschiedenen Strukturen wie Star- oder Snowflake-Schemata bereitstellen.

DV2.0 Architecture and write backs

Abbildung 1: Data-Vault-2.0-Architektur

Diese Architektur bietet optimale Voraussetzungen für Write-Backs von Daten. Grundsätzlich gibt es zwei Wege: das Zurückschreiben von Daten in das Enterprise-Data-Warehouse sowie direkt in die Quellsysteme. Dieser Artikel befasst sich mit dem Write-Back in das Enterprise-Data-Warehouse, während ein nachfolgender Beitrag das Write-Back in die Quellsysteme beleuchtet.

Continue Reading

Data Vault Use Cases jenseits des klassischen Reportings – Teil 3

Data Vault use cases for reporting

Neue Möglichkeiten mit Data Vault 2.0

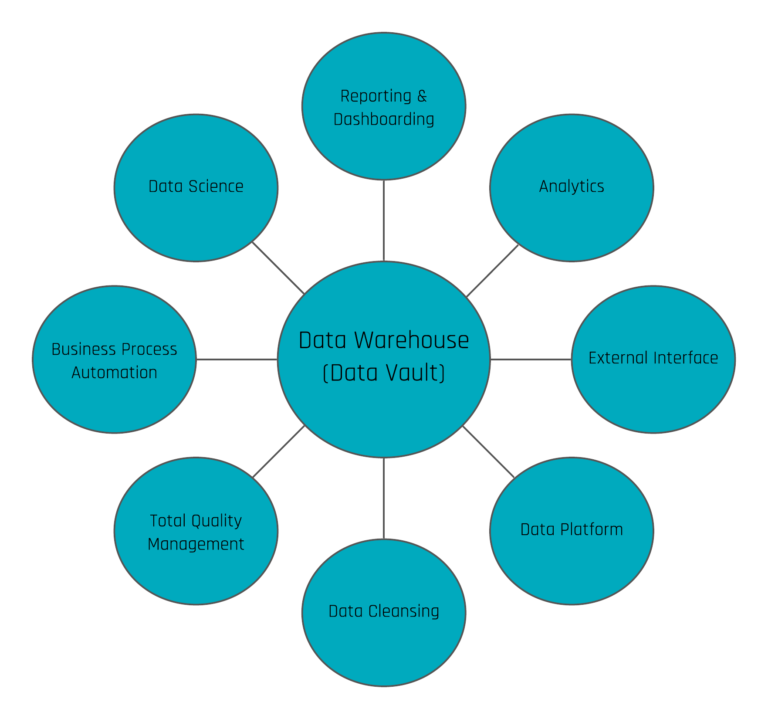
Data Vault 2.0 ermöglicht es Unternehmen, weit über das traditionelle Reporting hinauszugehen, indem neue Wege für Skalierbarkeit, Automatisierung und datenbasierte Entscheidungsfindung erschlossen werden. Von der Datenbereinigung und der Automatisierung von Geschäftsprozessen bis hin zum Einsatz fortschrittlicher Data-Science-Verfahren wie Machine Learning und Predictive Analytics bietet Data Vault 2.0 ein flexibles Framework für moderne Herausforderungen im Datenbereich. In diesem Artikel untersuchen wir, wie Data Vault 2.0 Data Science integriert, um operative Prozesse zu optimieren, fundierte Zukunftsprognosen zu erstellen und Enterprise Data Warehouses zielgerichtet zu erweitern und so einen nachhaltigen Wettbewerbsvorteil in der heutigen datengetriebenen Geschäftswelt zu sichern.

Über das Standard-Reporting hinausgehen

Reporting und Dashboarding sind in der Unternehmenspraxis zum Standard geworden, wenn es darum geht, KPIs und weitere Leistungskennzahlen zu überwachen. Dementsprechend haben sich Enterprise Data Warehouses als zentrales Fundament zur Unterstützung dieser Reporting-Prozesse etabliert. Angesichts des rasanten Wachstums an Datenmengen und Datenvielfalt reicht reines Standard-Reporting jedoch oft nicht mehr aus: Es bedarf moderner Methoden, um aus den vorhandenen Daten einen zusätzlichen, messbaren geschäftlichen Mehrwert zu generieren. Data Vault 2.0 bietet hierfür vielfältige Ansätze zur fundierten Entscheidungsunterstützung und liefert geschäftskritische Erkenntnisse für strategische Zukunftsentscheidungen. Begleiten Sie uns bei der Betrachtung praxiserprobter Lösungen, mit denen Sie das volle Potenzial Ihrer Unternehmensdaten ausschöpfen.

Watch webinar recording

Über das Standard-Reporting hinausgehen

Wie bereits in den vorangegangenen Beiträgen dargelegt, ermöglicht Data Vault 2.0 moderne Implementierungen weit über klassische Reporting-Muster hinaus.
Im ersten Teil haben wir aufgezeigt, wie eine effiziente Datenbereinigung in Data Vault 2.0 erfolgt.
Der zweite Use Case verdeutlichte, wie sich eine automatisierte Geschäftsprozesssteuerung über Interface Marts realisieren lässt.

Dank der hohen Skalierbarkeit und Flexibilität von Data Vault 2.0 lässt sich eine breite Palette anspruchsvoller Use Cases umsetzen darunter die Optimierung und Automatisierung operativer Abläufe, Predictive Forecasting, das strukturierte Zurückspielen von Daten in operative Quellsysteme als neuer Daten-Input sowie das gezielte Auslösen externer Systemereignisse außerhalb des Data Warehouse. Continue Reading

Modellierung bei strukturellen Änderungen im Quellsystem

Modellierung eines Satelliten bei strukturellen Änderungen im Quellsystem

Im Laufe der Zeit kann sich ein Quellsystem verändern. Es stellt sich die Frage, wie diese Änderungen in ein Data Vault 2.0 Data Warehouse integriert werden können – insbesondere im Hinblick auf die Satelliten.

Bei Änderungen der Quelltabellenstruktur gilt es, eine Balance zwischen Reengineering-Aufwand und Performance zu finden. Um allen zu helfen, die mit strukturellen Änderungen im Quellsystem konfrontiert sind, stellt dieser Artikel auf Basis unserer Knowledge Base Empfehlungen für verschiedene Arten von Quelländerungen vor.

Dieser Artikel beschreibt Eigenschaften des Data Vault 2.0-Modells: Das Fundament aus Hub-, Link- und Satelliten-Entitäten kann sich problemlos an Änderungen der Quelldaten anpassen, wodurch die Kosten für das Reengineering des Enterprise Data Warehouse reduziert werden.

Neue Spalten im Quellsystem: Vorgehen beim Hinzufügen von Attributen

Es gibt zwei Optionen, um neue Attribute aus der Quelle in das Data Warehouse zu übernehmen. Erstens kann der bestehende Satellit angepasst werden.
Dies ist ein pragmatischer Ansatz, erfordert jedoch die Änderung bestehenden Codes.
Zweitens ist es möglich, einen neuen Satelliten für das neue Attribut bzw. die neuen Attribute zu erstellen, ohne die bestehenden Satelliten zu verändern. Dies hat den Vorteil, dass kein bestehender Code angepasst werden muss (Zero Code Impact), erfordert jedoch mehr Joins im Bereich der Informationsbereitstellung (Information Delivery) des Data Vaults.

Die erste Option erfordert diesen Join nicht, da das neue Attribut dem bestehenden Satelliten hinzugefügt wird. Der beste Ansatz besteht darin, die Vor- und Nachteile beider Optionen im Kontext Ihrer spezifischen Situation abzuwägen. Automatisierungstools können beispielsweise die ALTER-TABLE-Anweisung in der Regel automatisch ohne manuellen Programmieraufwand verarbeiten, erfordern jedoch Änderungen an der Datenbank.

Löschen von Spalten im Quellsystem

Eine Option besteht darin, den „alten“ Satelliten zu schließen, d. h. nicht weiter zu beladen (indem der ETL-Code deaktiviert wird), und einen neuen Satelliten zu erstellen, der fortan beladen wird. Der gleiche Ansatz wird gewählt, wenn die zugrunde liegenden Datenstrukturen der Quelle in größerem Umfang geändert werden.
Alte Satelliten werden abgeschaltet, neue Satelliten mit der neuen Struktur werden anschließend beladen.
Eine andere Option ist sinnvoller, wenn nur geringfügige Änderungen erforderlich sind, wie etwa das Entfernen einer einzelnen Spalte. In diesem Fall kann diese Spalte mit einem NULL-Wert oder einem fachlich korrekten Ersatzwert „simuliert“ werden, was für Revisionszwecke hilfreicher ist.

Wenn ein neuer Satellit erstellt wird, führt dies zu zwei neuen Spalten in der zugehörigen PIT-Tabelle (Hash-Key + LDTS).

Das Schließen eines Satelliten und das Erstellen eines neuen ist auch bei größeren Änderungen im Quellsystem anwendbar, beispielsweise bei einer neuen Release-Version des Quellsystems, bei der Spalten gelöscht, umbenannt und neu erstellt werden. Bei kleineren Änderungen, insbesondere wenn Spalten entfallen, empfehlen wir die Anpassung des bestehenden Satelliten.

Erstellung einer virtuellen Dimensionstabelle aus einer PIT-Tabelle mit mehreren Satelliten

Wenn ein neuer Satellit für das neue Attribut (oder die neuen Attribute) erstellt wird, anstatt den bestehenden Satelliten zu verändern, ist eine neue virtuelle Dimension erforderlich, um Informationen aus PIT-Tabellen unter Verwendung beider Satelliten basierend auf dem erforderlichen Zeitstempel abzufragen.
Es gibt zwei Ansätze, wie Informationen aus beiden Satelliten abgerufen werden können:

  • Der erste Ansatz nutzt einen Computed Satellite, in dem Sie alle Satelliten mit dem aktuellsten Datensatz pro Hash-Key und derselben Struktur kombinieren. Dies kann jedoch eine komplexe Abfrage sein, da sie von der Datenmenge und der Anzahl der zu joinenden Satelliten abhängt.
  • Der zweite Ansatz besteht darin, eine PIT-Tabelle für alle Satelliten zu verwenden. Beim Abfragen der Daten beispielsweise für eine Dimensionstabelle, wählen Sie den Datensatz aus dem führenden Satelliten aus, zum Beispiel mithilfe einer IIF-Anweisung oder der COALESCE-Funktion.

Fazit

Obwohl jede Situation einen Ansatz erfordert, der den individuellen Charakter der Aufgabenstellung berücksichtigt, haben sich die oben genannten Lösungen bei der Umsetzung in unseren eigenen Projekten als essenziell erwiesen.

Wir teilen diese Empfehlungen, damit auch andere von unseren Erkenntnissen aus Testen, Anwendung und Implementierung profitieren können.