All Posts By

Marc Winkelmann

As Senior Managing Consultant and official CDVP2.1 Instructor since 2020, Marc brings more than ten years of dedicated Data Vault experience to complete end-to-end data platform implementations. His core strength lies in empowering entire data teams to build highly scalable data and AI solutions.

Aufteilung einer Satellite-Entität basierend auf den Quelldaten

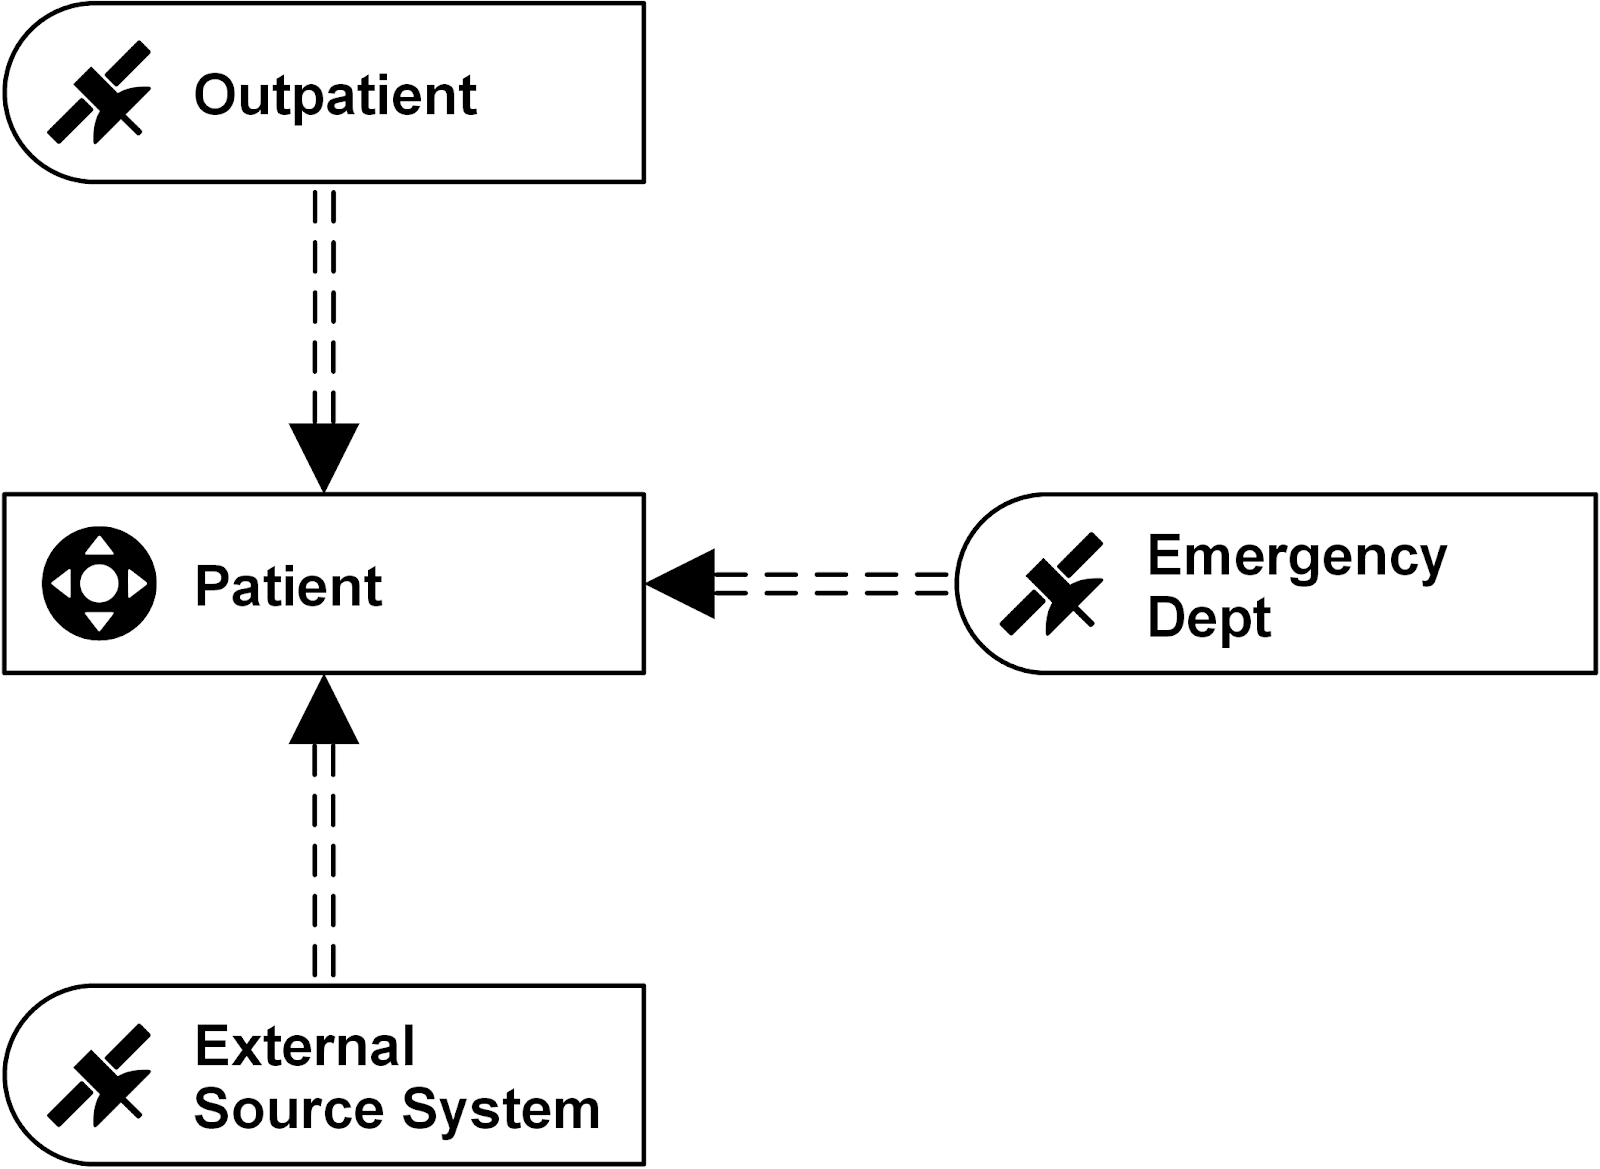
Satellite split by source system

Aufteilung einer Satellite-Entität

Kriterien für das Satellite-Splitting spielen eine entscheidende Rolle für die Struktur eines Satelliten. Daher wird davon abgeraten, sämtliche beschreibenden Daten zu einem Business Key in einer einzigen Satellite-Struktur zu speichern. Stattdessen sollten Rohdaten vorzugsweise nach bestimmten Kriterien aufgeteilt werden.


Kriterien für das Aufteilen eines Satelliten

Im Allgemeinen haben wir die folgenden Arten von Satellite-Splits definiert:

  1. Aufteilung nach Quellsystem
  2. Aufteilung nach Änderungsrate

Darüber hinaus haben wir zwei weitere Arten von Splits definiert:

  1. Aufteilung nach Sicherheits- und Datenschutzstufe
  2. Fachlich getriebene Aufteilung (Business-driven Split)

Eine Aufteilung des Satelliten nach Quellsystem wird dringend empfohlen, um zwei wesentliche Probleme beim Laden der Daten in das Enterprise Data Warehouse zu vermeiden: Wenn erstens zwei verschiedene Quellsysteme mit unterschiedlichen relationalen Strukturen in dieselbe Satellite-Entität geladen werden sollen, ist möglicherweise eine Transformation der Struktur erforderlich. Eine solche strukturelle Transformation erfordert jedoch früher oder später Geschäftslogik (Business Logic). Diese sollte auf die Information-Delivery-Schicht verschoben werden, um vollständig revisionssichere Umgebungen sowie die Anwendung mehrerer Geschäftsperspektiven zu unterstützen. Continue Reading

Ansätze zur Handhabung von Löschungen und Änderungen in Data Vault 2.0

Data Vault 2.0 - Insert logic

Ansätze zur Handhabung von Löschungen und Änderungen in Data Vault 2.0

In diesem Artikel zeigen wir Ihnen, wie Sie Counter Records für den Umgang mit Änderungen und Löschungen in Data Vault 2.0 nutzen können. Im Januar dieses Jahres haben wir einen Beitrag veröffentlicht, der einen Ansatz zur Handhabung von Löschungen und Business-Key-Änderungen in Data-Vault-Beziehungen ohne vorhandenen Audit-Trail beschreibt.
Dieser Ansatz ist eine Alternative zur Driving-Key-Struktur, die Teil der Data-Vault-Standards und eine valide Lösung darstellt.
Manchmal kann es jedoch schwierig sein, diejenigen Business Keys in einer Beziehung zu identifizieren, die sich niemals ändern und daher bei Abfragen als Anchor Keys (Link Driving Keys) verwendet werden. Die vorgestellte Methode fügt Counter Records für geänderte oder gelöschte Datensätze ein, speziell bei Transaktionsdaten und stellt einen einfachen sowie pragmatischen Ansatz dar. Der Artikel warf jedoch viele Fragen auf, sorgte für Verwirrung und regte Diskussionen an.
Ziel dieses Blogbeitrags ist es daher, tiefer in die technische Implementierung einzutauchen, deren Praxistauglichkeit wir im Einsatz bestätigen konnten.


Technische Implementierung in Data Vault 2.0

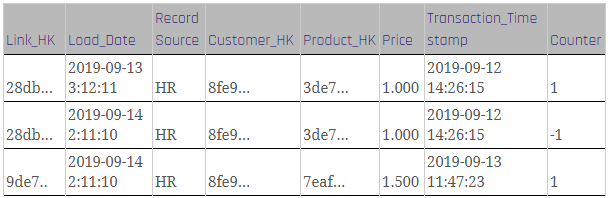
Die folgende Tabelle zeigt eine leicht modifizierte Zielstruktur des Links aus dem vorherigen Blogbeitrag bei der Verwendung von Counter Records in Data Vault 2.0.

In diesem Fall konzentrieren wir uns auf Transaktionen, die vom Quellsystem geändert wurden, ohne dass Audit-Daten über die Änderungen oder Gegenbuchungen durch die Quelle selbst geliefert werden.

Es ist wichtig zu beachten, dass der Link Verkaufspositionen speichert, indem er auf den Kunden und das Produkt verweist. Daher bilden der Link-Hash-Key sowie das Load Date die Primärschlüssel (Primary Keys), da wir in diesem Fall keine konsistente, einzelne Record-ID erfassen können. Aus diesem Grund wird der Link-Hash-Key aus dem Customer-Business-Key, dem Product-Business-Key, dem Verkaufspreis und dem Transaktions-Zeitstempel berechnet.

Data Vault 2.0 link with counter record

Abbildung 1: Link mit Counter Records

Um den Link zu laden, sind die folgenden Schritte erforderlich:

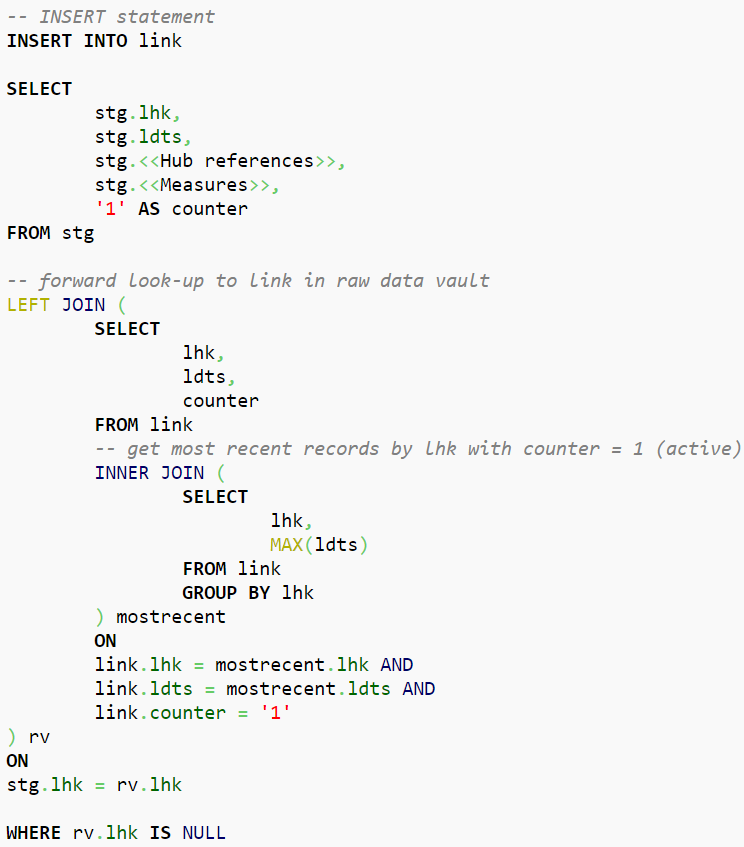
Zunächst wird geprüft, ob eine Gegenbuchung überhaupt notwendig ist, und diese gegebenenfalls eingefügt, da der vorherige Schritt neue Daten aus der Staging Area in den Link lädt. Bitte beachten Sie, dass die Ladelogik in diesem Schritt der des Standard-Link-Ladeprozesses ähnelt, jedoch einige Unterschiede aufweist:

Data Vault 2.0 - Insert logic

Abbildung 2: Insert-Logik

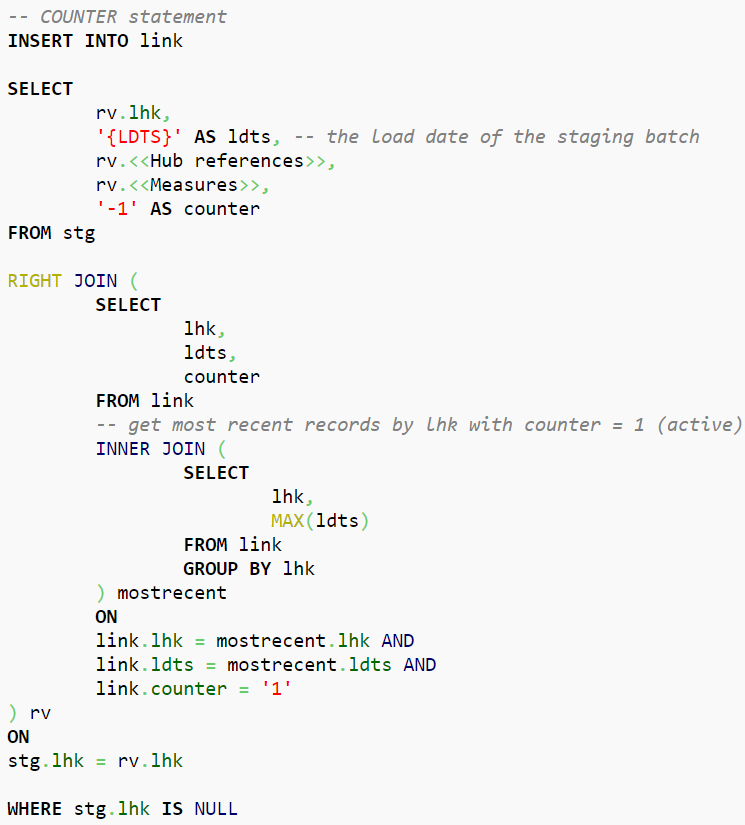
In Data Vault 2.0 soll der Counter Record diejenigen Datensätze identifizieren, genauer gesagt die aktuellsten Datensätze nach Link-Hash-Key, die zwar im Link existieren, aber aufgrund von Löschungen oder Änderungen nicht mehr in der Staging Area vorhanden sind. Somit werden Abfrageergebnisse mit einem Wert von -1 für „counter“ ausgeglichen, was anzeigt, dass diese Datensätze in diesem Stadium nicht gefunden werden können. Beachten Sie, dass wir in dieser Abfrage den bestehenden Datensatz aus der Link-Tabelle im Raw Vault auswählen. Wichtig ist hierbei jedoch, dass die Ankunftszeit des Datensatzes dem LDTS des tatsächlichen Staging-Batches entsprechen sollte. Daher ist das LDTS innerhalb des gezeigten Statements eine Variable mit dem Load Date des Staging-Batches:

Data Vault 2.0 - Counter logic

Abbildung 3: Counter-Logik

In Fällen, in denen wieder auf den ursprünglichen Datensatz zurückgewechselt wird, gilt dasselbe Verfahren: Der aktuell fehlende Wert wird durch den neuen Wert ausgeglichen, der erneut mit einem neuen LDTS eingefügt wird.

Fazit

Wir können daher festhalten, dass dieser Data-Vault-Ansatz gut für Tabellen funktioniert, die reine Hotspots für Messwerte bilden. Er eignet sich besonders dann, wenn Änderungen möglich sind, obwohl die Daten Transaktionen darstellen, und kein CDC verfügbar ist.

Anstelle einer Logik wie „Hole den aktuellsten Datensatz pro Hash-Key (Driving Key)“ ist es möglich, Berechnungen sowie Aggregationen direkt auf einer Tabelle auszuführen. Das führt letztendlich zu einer besseren Performance in der Endstufe.

Wenn Sie noch Fragen haben, hinterlassen Sie gerne einen Kommentar. Wir freuen uns auf den Austausch und Ihre Gedanken zu diesem Thema.

Herausforderungen im Data Warehousing mit Data Vault 2.0 meistern

Webinar ansehen

Unternehmen und DWH-Teams stehen im Data Warehousing vor vielfältigen Herausforderungen. In diesem kompakten, einstündigen Webinar beleuchten wir zentrale Problemstellungen und zeigen Ihnen praxisnah, wie Sie diese mit Data Vault 2.0 erfolgreich bewältigen.

Webianr ansehen

Webinar-Agenda

1. Agilität erreichen und nachhaltig sichern
2. Legacy-DWH-Systeme weiterführen oder migrieren
3. Sicherheit und Datenschutz (DSGVO)
4. Big Data
5. Anpassung an sich verändernde Anforderungen
6. Revisionssicherheit und Data Lineage
7. Self-Service-BI

Data Vault Use Cases jenseits des klassischen Reportings – Teil 2

Die Rolle des Enterprise Data Warehouse

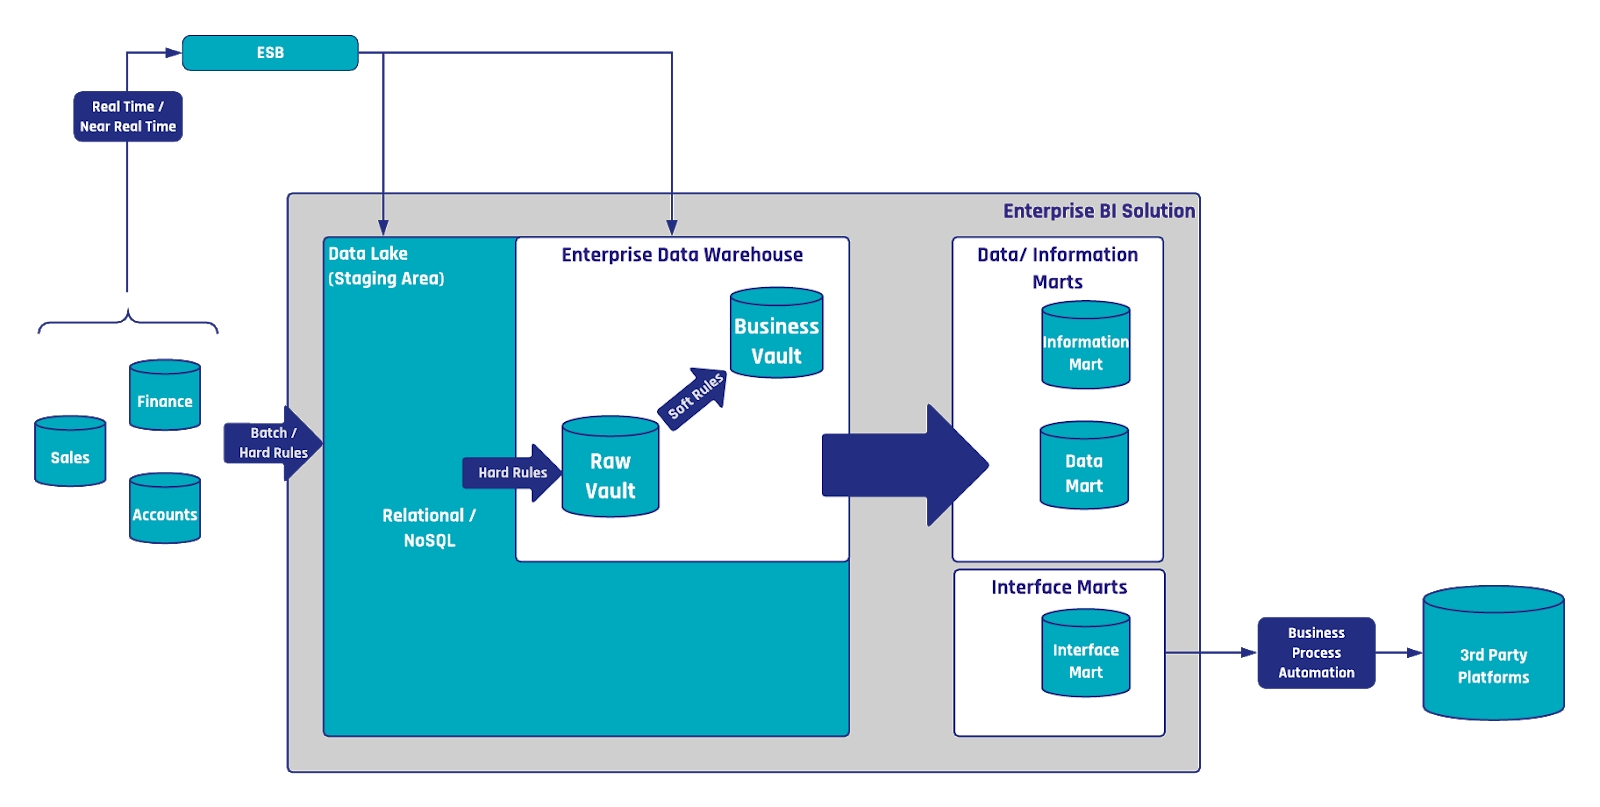
Das Enterprise Data Warehouse (EDW) beschränkt sich längst nicht mehr nur auf Reporting und Dashboarding; es ist ein leistungsfähiges Instrument zur Förderung der Geschäftsprozessautomatisierung und der operativen Effizienz. Aufbauend auf den ersten Teil unserer Artikelserie zu Data Vault Use Cases untersucht dieser Artikel, wie Data Vault 2.0 eine nahtlose Integration mit Automatisierungsframeworks und externen Schnittstellen ermöglicht, um das Wissensmanagement zu verbessern, operative Abläufe zu optimieren und den manuellen Aufwand zu reduzieren. Von der Nutzung von Interface Marts zur Auslösung automatisierter Prozesse bis hin zur Anreicherung von Dokumentationssystemen mit dynamischen Updates zeigen wir das transformative Potenzial des EDW in modernen Unternehmensumgebungen auf.

Über das Standard-Reporting hinausgehen

Reporting und Dashboarding haben sich im Unternehmensalltag als Standards etabliert, wenn es um die Ermittlung von KPIs und weiteren Kennzahlen geht. Dementsprechend wurden Enterprise Data Warehouses primär entwickelt, um diesen Reporting-Prozess zu unterstützen. Aufgrund der großen Menge und Vielfalt an Daten ist jedoch der Bedarf an einer Methode entstanden, vorhandene Daten so zu nutzen, dass sie einen zusätzlichen operativen Mehrwert schaffen. Data Vault 2.0 bietet ein breites Spektrum an Methoden, um Entscheidungshilfen über das Standard-Reporting hinaus sowie zukunftsgerichtete Informationen bereitzustellen. Überzeugen Sie sich selbst: Wir stellen Ihnen verschiedene Ansätze und Lösungen vor, mit denen Sie das volle Potenzial Ihrer Daten ausschöpfen können.

Watch webinar recording

Mehr als Reporting und Dashboarding

Wie wir bereits im ersten Teil der Artikelserie zu Data Vault Use Cases dargelegt haben, kann das Enterprise Data Warehouse (EDW) weit mehr als nur einfaches Reporting und Dashboarding leisten.

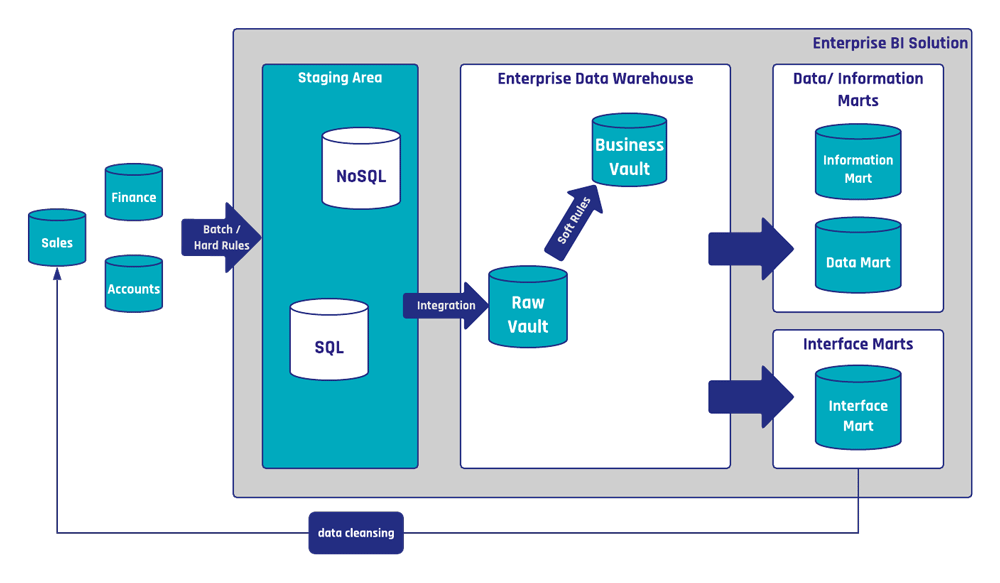
Zuvor haben wir untersucht, wie das EDW durch die Implementierung von Datenbereinigungsregeln zur nachhaltigen Verbesserung der Datenqualität beitragen kann.

Dies lässt sich durch Write-Back-Operationen umsetzen, die sich direkt auf die Quellsysteme auswirken. Dabei handelte es sich jedoch nur um ein Beispiel dafür, wie mit dem EDW zusätzlicher Mehrwert generiert werden kann. Die Skalierbarkeit und Flexibilität von Data Vault 2.0 eröffnet eine Vielzahl an möglichen Use Cases wie beispielsweise die Optimierung und Automatisierung operativer Prozesse, Zukunftsprognosen, die Rückführung von Daten in operative Systeme als neuer Input oder das Auslösen von Events außerhalb des Data Warehouse, um nur einige zu nennen.

Continue Reading

Erfassung halbstrukturierter deskriptiver Daten

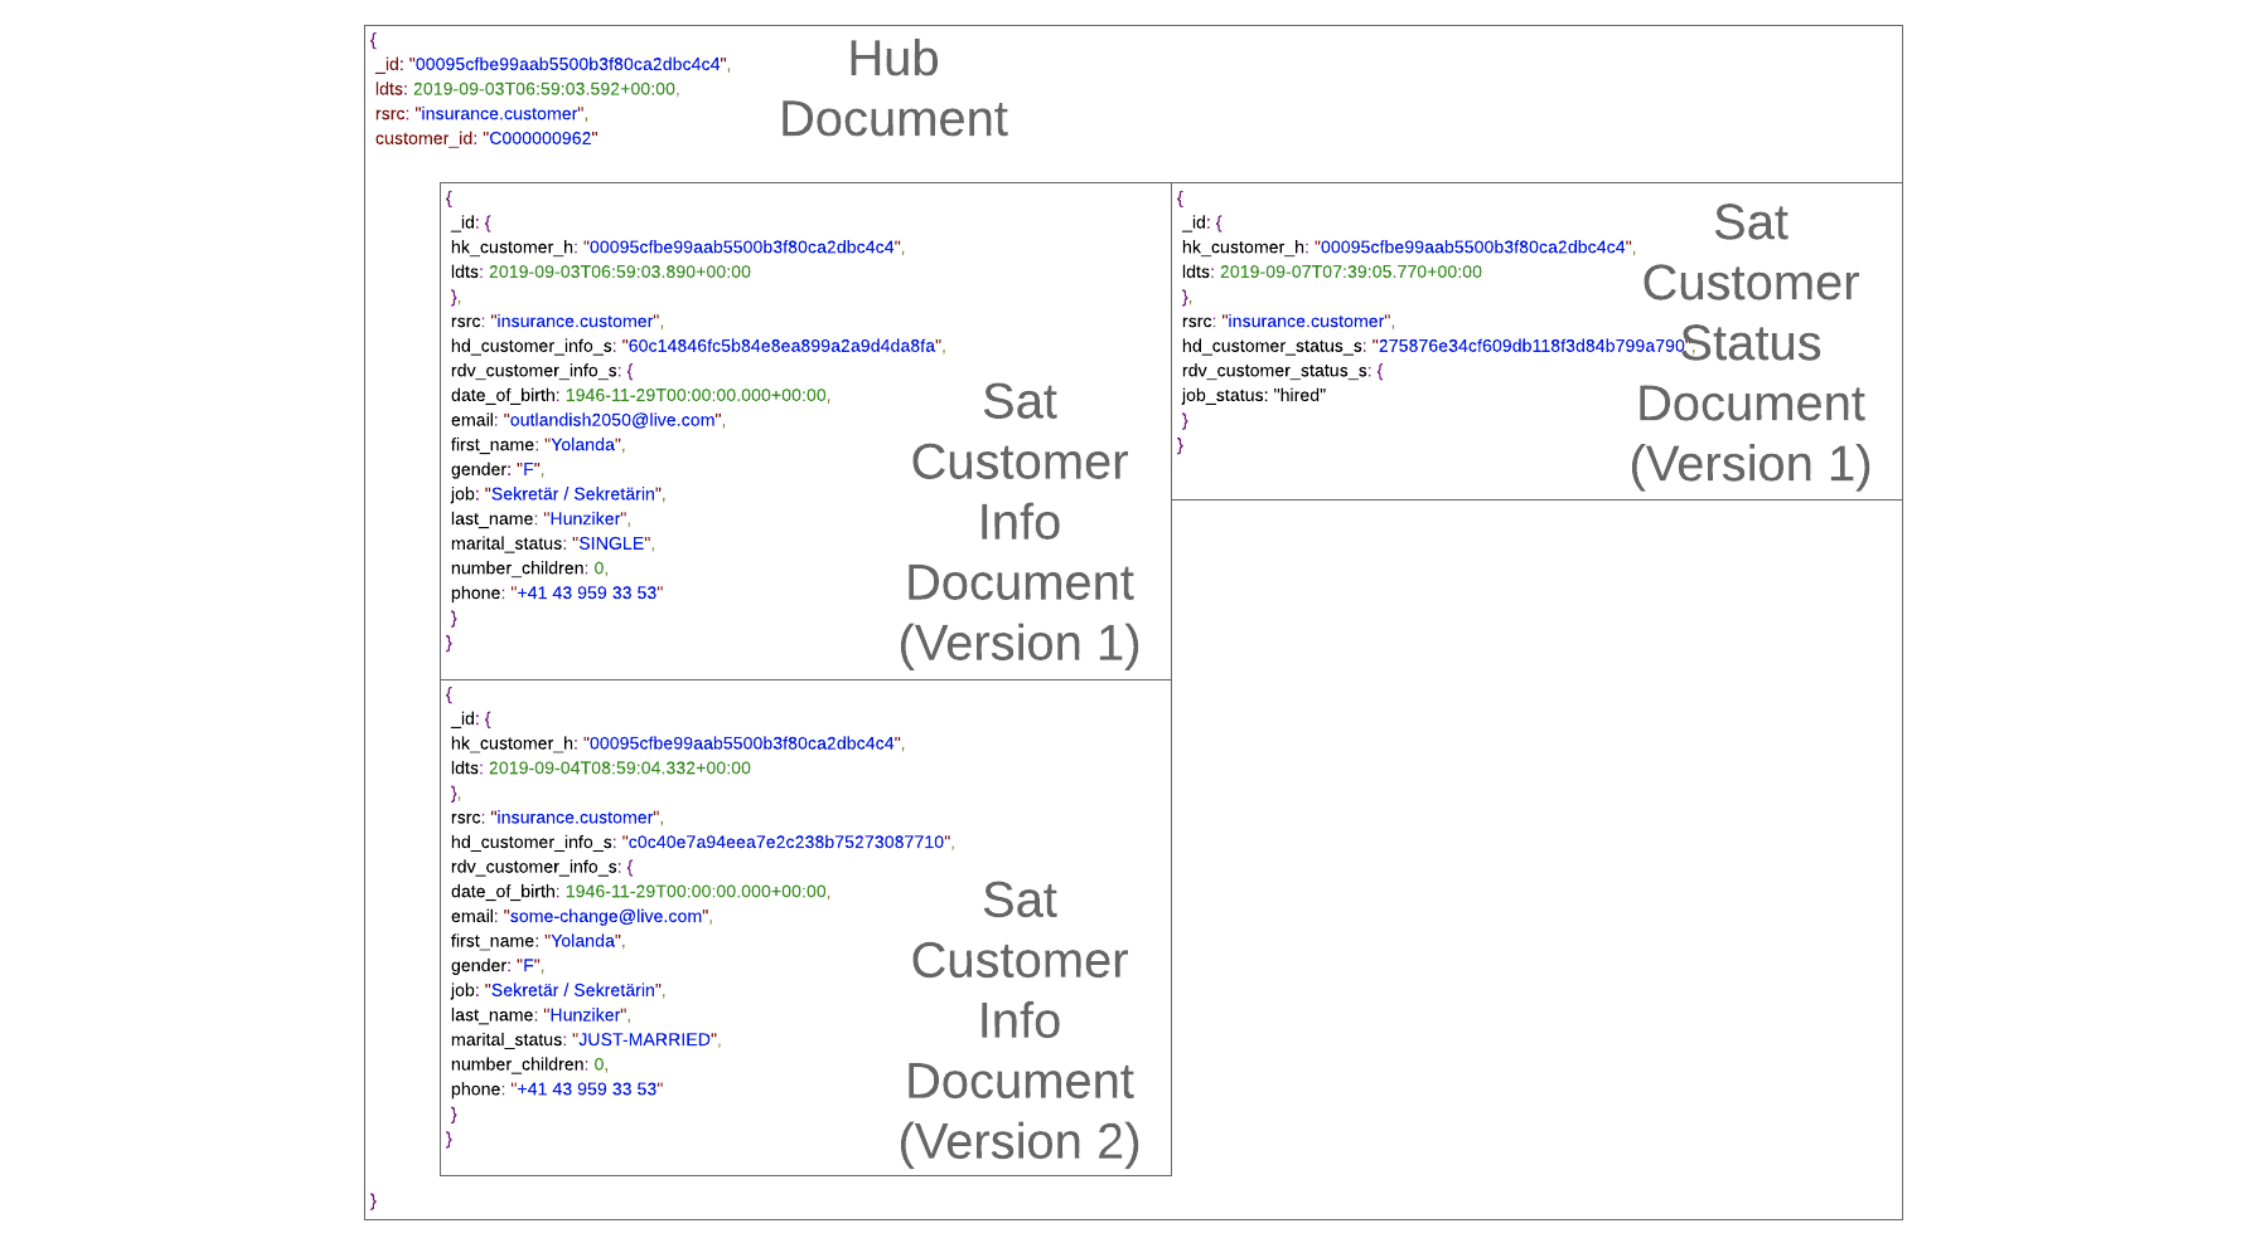
In den vorangegangenen Artikeln dieser Serie wurden Hub- und Link-Entitäten zur Erfassung von Business Keys sowie der Beziehungen zwischen Business Keys vorgestellt. Zur Veranschaulichung: Die Hub-Document-Collection in MongoDB ist eine eindeutige (distinct) Liste von Business Keys, die zur Identifizierung von Kunden verwendet werden.

Um deskriptive Daten zu erfassen, in diesem Fall die beschreibenden Merkmale der Business Keys, werden in Data Vault Satellite-Entitäten verwendet. Da sowohl Business Keys als auch Beziehungen zwischen Business Keys durch Benutzerdaten beschrieben werden können, können Satellites wie folgt sowohl an Hub- als auch an Link-Entitäten angehängt werden:

Continue Reading

Identifizierung zusätzlicher Beziehungen zwischen Dokumenten

Der vorangegangene Artikel unserer Reihe behandelte die Data-Vault-Hub-Entität, die verwendet wird, um eine eindeutige Liste von Business Keys in einem Enterprise Data Warehouse zu erfassen, da der Großteil der Integration direkt auf diesen Hub-Entitäten stattfindet. Es gibt jedoch Szenarien, in denen die Datenintegration ausschließlich auf Basis dieser Hub-Entitäten für das angestrebte Ziel nicht ausreicht.

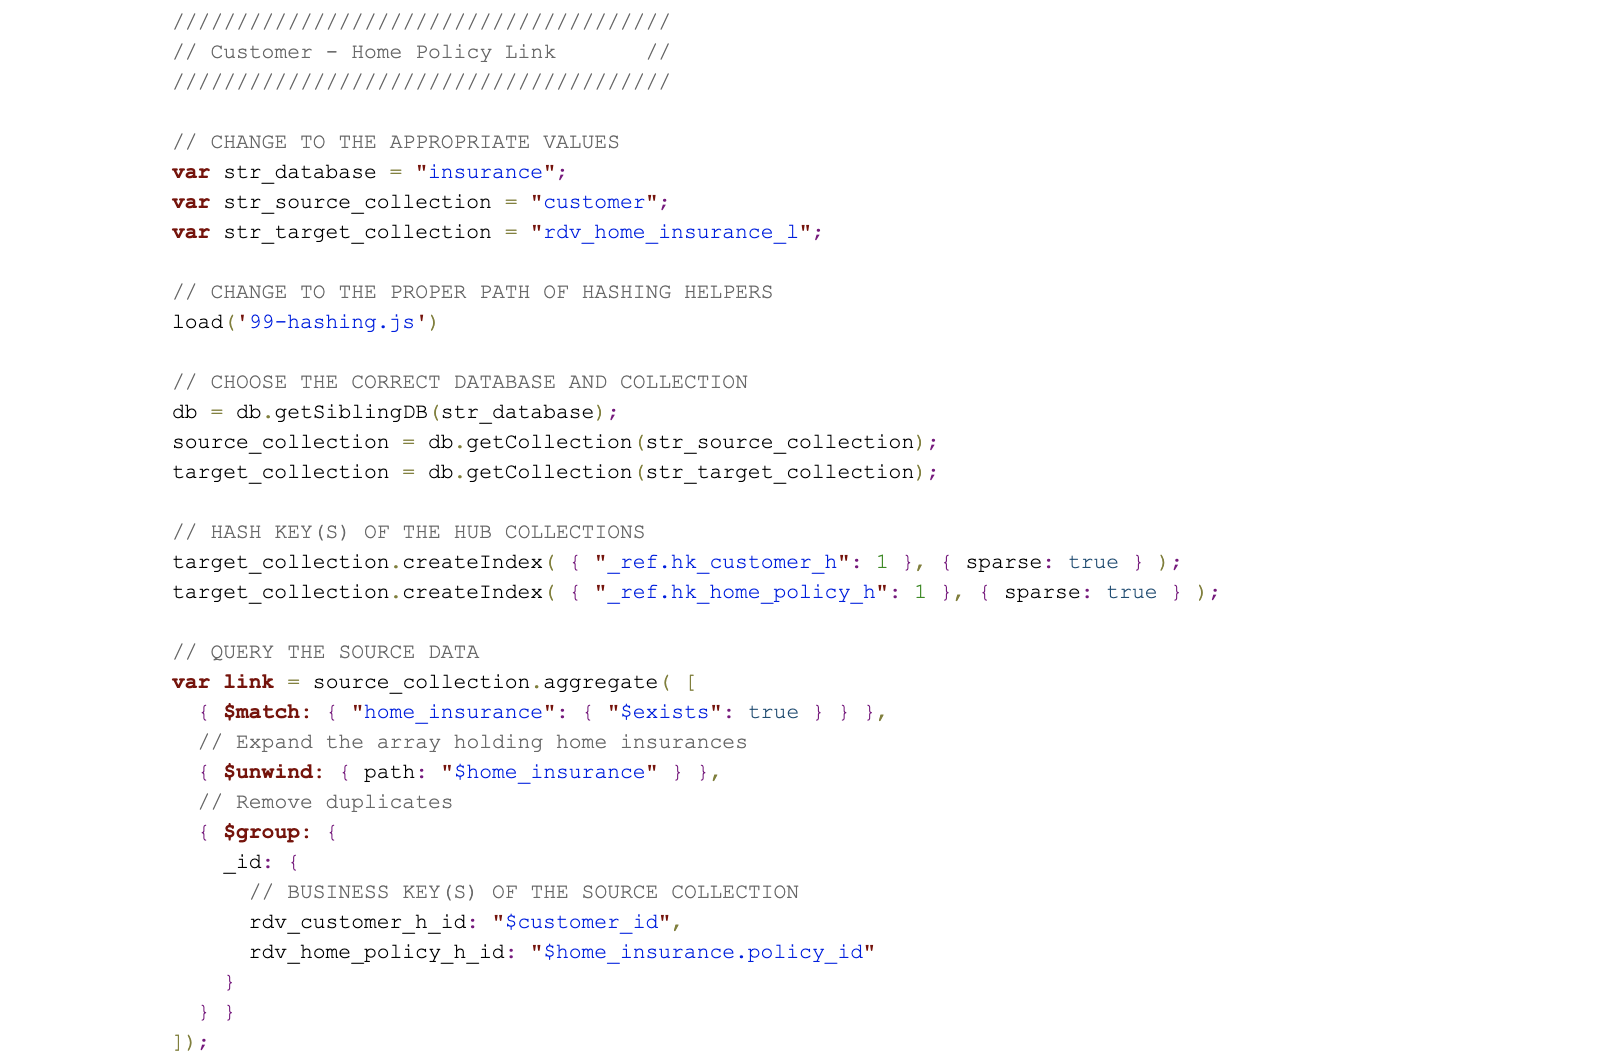
Betrachten Sie dazu das Beispiel des Datensatzes einer Versicherungsgesellschaft, bei dem Kunden jeweils Kfz- und Wohngebäudeversicherungen abschließen sowie Schadensfälle melden. Bevor wir mit dem Beispiel fortfahren, ist ein wesentlicher Aspekt zu beachten: Zwischen den beteiligten Business Keys bestehen Beziehungen, nämlich zwischen der Kundennummer, den Policen-Identifikatoren und den Schadensfällen.

Diese Beziehungen werden von Data-Vault-Link-Entitäten erfasst. Genau wie Hubs enthalten sie eine eindeutige Liste von Datensätzen und weisen somit in Bezug auf die gespeicherten Daten keine Duplikate auf. Beide bilden das Grundgerüst von Data Vault und werden später durch beschreibende Daten ergänzt, die in Satellites gespeichert sind

Continue Reading

Data-Lake-Effizienz: Strukturelle Lösungen

Data Lake architecture

Data-Lake-Struktur – Lösung

Die Organisation von Daten innerhalb eines Data Lakes beeinflusst deren nachgelagerte Verfügbarkeit maßgeblich. Während das Auslagern (Offloading) von Daten in den Data Lake meist unkompliziert ist, liegt die eigentliche Herausforderung in der effizienten Abfrage dieser Daten. Eine hohe Effizienz beim Datenabruf ist entscheidend für Aufgaben wie das inkrementelle oder initiale Laden des Enterprise Data Warehouse (EDW) sowie für Data Scientists, die eigenständige Analysen durchführen. In der Praxis steht und fällt der einfache Zugriff auf nachgelagerte Daten mit ihrer Strukturierung im Data Lake. Eine durchdachte Organisation sorgt für reibungslose Abrufprozesse und unterstützt sowohl EDW-Ladevorgänge als auch die Abfrageanforderungen der Data Scientists optimal.

ACCESS THE SOLUTION
In einer hybriden Data-Warehouse-Architektur, wie sie in der Data-Vault-2.0-Bootcamp-Schulung vermittelt wird, dient ein Data Lake als Ersatz für eine relationale Staging Area. Um das Potenzial dieser Architektur voll auszuschöpfen, sollte der Data Lake so strukturiert sein, dass er einen effizienten Zugriff im Rahmen eines Persistent-Staging-Area-Musters sowie eine verbesserte Datenvirtualisierung ermöglicht.

Continue Reading

Data Vault Use Cases jenseits des klassischen Reportings – Teil 1

Data Cleansing with Data Vault 2.0

Enterprise Data Warehouses mit Data Vault 2.0

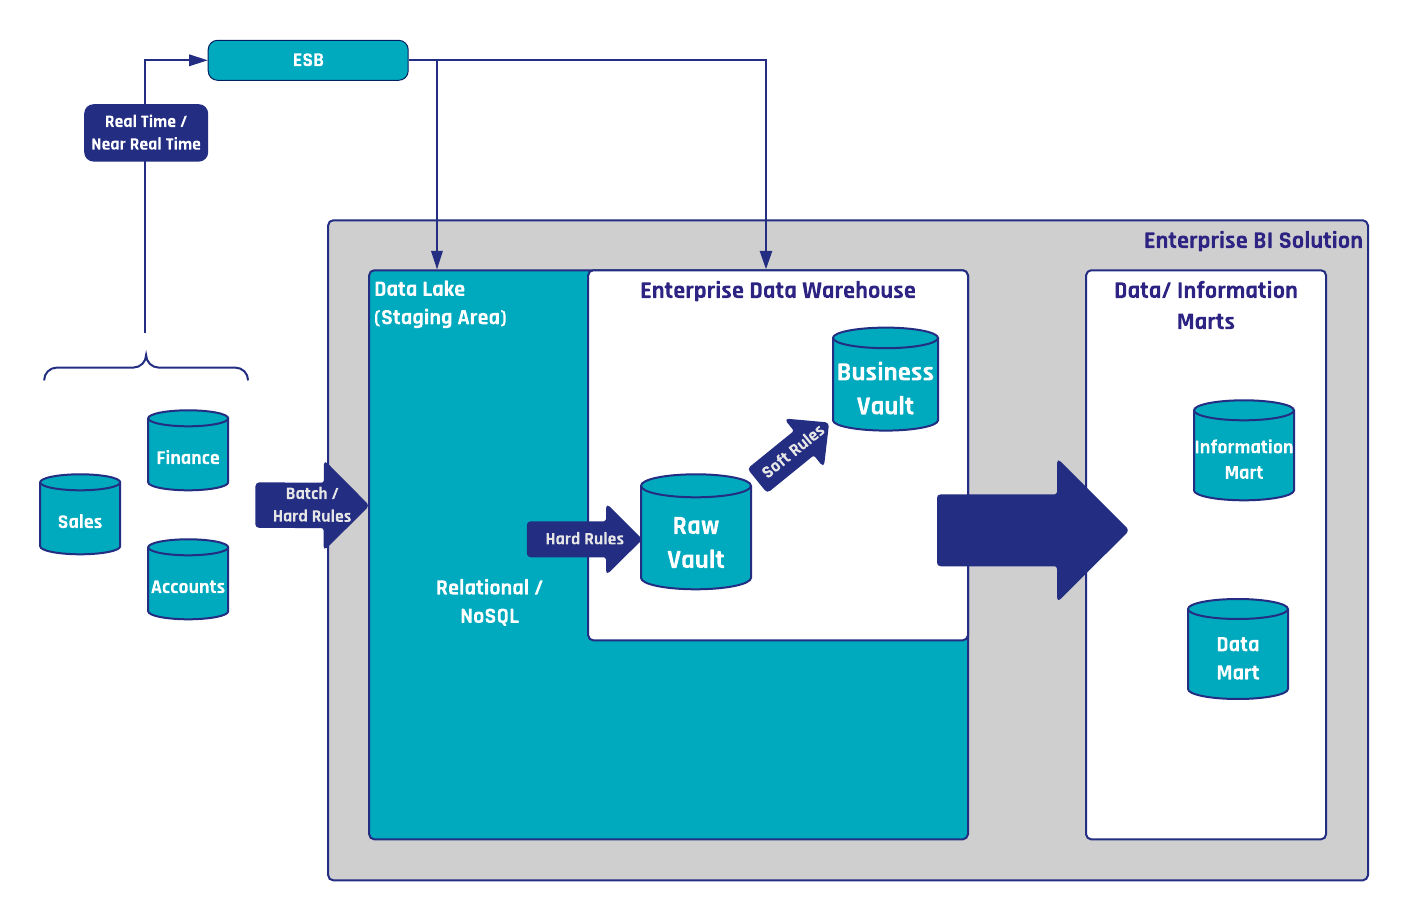
Während Enterprise Data Warehouses (EDWs) traditionell für Reporting und Dashboarding eingesetzt werden, liegt ihr wahres Potenzial in Verbindung mit Data Vault weit jenseits dieser Basisanwendungen. Data Vault 2.0 bietet eine beispiellose Flexibilität und Skalierbarkeit, die es Organisationen ermöglicht, neue Use Cases wie Data Cleansing, die Automatisierung operativer Prozesse und Predictive Analytics erfolgreich umzusetzen. Dieser Artikel untersucht, wie Data Vault 2.0 Unternehmen in die Lage versetzt, zentralisierte Data-Cleansing-Regeln anzuwenden, die Datenqualität direkt an der Quelle zu verbessern und ein Total Quality Management (TQM) zu etablieren. Durch die Nutzung des vollen Potenzials ihrer EDW-Systeme können Organisationen weit über einfache Analysen hinausgehen und nachhaltige, agile sowie wirkungsvolle Datenstrategien entwickeln.

Mit Data Vault 2.0 über das Standard-Reporting hinausgehen

Reporting und Dashboarding sind in der heutigen Geschäftswelt der Standard, um KPIs und andere wichtige Kennzahlen zu ermitteln. Entsprechend wurden Enterprise Data Warehouses primär zur Unterstützung dieser Reporting-Prozesse konzipiert. Angesichts der wachsenden Datenmenge und -vielfalt steigt jedoch der Bedarf an Methoden, die diese Daten so nutzen, dass sie einen echten geschäftlichen Mehrwert generieren. Data Vault 2.0 bietet hierfür ein breites Spektrum an Ansätzen, um fundierte Entscheidungen jenseits des Standard-Reportings zu unterstützen und zukunftsgerichtete, geschäftskritische Erkenntnisse zu liefern. Begleiten Sie uns auf diesem Weg und erfahren Sie, wie Sie das volle Potenzial Ihrer Daten ausschöpfen können.

Watch webinar recording

Flexibilität und Skalierbarkeit

Einfach ausgedrückt führt ein Enterprise Data Warehouse (EDW) Daten aus internen sowie externen Datenquellen zusammen, um sie für Reporting- und Dashboarding-Zwecke bereitzustellen. Häufig werden diese Daten analytischen Transformationen unterzogen, um Berichte und Dashboards aussagekräftiger und wertvoller zu gestalten. Dennoch übersehen viele Organisationen beim Aufbau eines Data Warehouses weitere wertvolle Use Cases. Tatsache ist, dass EDWs ein enormes ungenutztes Potenzial bieten, das weit über das bloße Reporting historischer Daten hinausgeht. Um diese Möglichkeiten agil zu erschließen, bringt Data Vault ein Höchstmaß an Flexibilität und Skalierbarkeit mit.

Data Vault Use Cases

Zu Beginn wird ein Data Warehouse oft nur dazu genutzt, Daten zu sammeln und für Reporting- und Dashboarding-Zwecke aufzubereiten. Wird das EDW jedoch auf diese grundlegenden Use Cases beschränkt, bleibt ein Großteil des eigentlichen Datenwerts ungenutzt.

Dabei lässt sich über ein Data Warehouse eine Vielzahl innovativer Use Cases realisieren. Dazu gehören die Optimierung und Automatisierung operativer Prozesse, vorausschauende Analysen, das Zurückspielen von Daten in operative Systeme oder das Auslösen von Ereignissen außerhalb des Data Warehouses – um nur einige der neuen Möglichkeiten zu nennen.

Continue Reading

Was Sie bei Namenskonventionen im Data Warehousing beachten sollten – Teil 1

Naming conventions - Letter cases

Namenskonventionen im Data Warehousing

Eine der ersten und wichtigsten Entscheidungen bei der Data-Vault-Entwicklung betrifft die Definition von Namenskonventionen für Datenbankobjekte. Als wesentlicher Bestandteil der Standardisierung sind diese Konventionen zwingend erforderlich, um ein gut strukturiertes und konsistentes Data-Vault-Modell aufrechtzuerhalten. Angemessene Namenskonventionen erhöhen die Benutzerfreundlichkeit des Data Warehouses erheblich, nicht nur für Entwickler, sondern auch für Power-User bei der Datenexploration.

In diesem Artikel stellen wir Ihnen die wichtigsten Überlegungen aus unserem Standardprozess zur Definition von Namenskonventionen vor.

Dokumentation von Namenskonventionen

Es ist eine Sache, die Namenskonventionen für die Entwicklung Ihres Data Warehouses einfach nur zu definieren. Eine ganz andere Herausforderung ist es jedoch, die nötige Konsistenz zu etablieren, damit diese Konventionen auch tatsächlich zu gelebten Standards werden. Daher gehört es zu den Best Practices, eine klare Richtlinie für die Benennung von Data-Warehouse-Objekten zu dokumentieren. In den folgenden Abschnitten erörtern wir verschiedene Aspekte, die Sie bei der Definition von Namenskonventionen für eine Data-Warehouse-Lösung berücksichtigen sollten.

Namenskonventionen: Groß- und Kleinschreibung

Wenn es um die Groß- und Kleinschreibung von Namen geht, gibt es verschiedene Optionen: durchgehende Großschreibung, durchgehende Kleinschreibung, Camel Case und Pascal Case. Auch wenn die Unterschiede gering erscheinen mögen, hat jede Option ihre eigenen Vor- und Nachteile hinsichtlich der Lesbarkeit und der Schnelligkeit beim Tippen.

Letztendlich hängt die Entscheidung für eine bestimmte Schreibweise vom verwendeten Datenbankmanagementsystem ab. Einige Systeme wie PostgreSQL unterstützen case-sensitive Objektnamen, was bei Abweichungen die Verwendung von Anführungszeichen erforderlich macht. Daher bevorzugen PostgreSQL-Nutzer standardmäßig oft die Kleinschreibung, da kleingeschriebene Objektnamen den zu schreibenden Code reduzieren und gleichzeitig die Benutzerfreundlichkeit bei Ad-hoc-Abfragen durch Power-User verbessern. Dennoch ist es zwingend erforderlich, eine einheitliche Groß- und Kleinschreibung sowohl für Entitäts- als auch für Spaltennamen beizubehalten.

Naming conventions - Letter cases
Figure 1: Naming Convention - Letter Case

Namenskonventionen: Verwendung von Unterstrichen „_“ und Bindestrichen „-“

Zur Verbesserung der Lesbarkeit sind Worttrenner wie Unterstriche „_“ oder, je nach Anwendungsfall, Bindestriche „-“ wünschenswert. Es ist jedoch wichtig zu bedenken, dass Bindestriche in vielen Systemen als Minuszeichen interpretiert werden. Dennoch werden Bindestriche häufig in XML- oder JSON-Datenformaten verwendet. Sie lassen sich jedoch leicht durch Unterstriche ersetzen, falls diese als Standard-Trennzeichen definiert sind.

Namenskonventionen: Abkürzungen und Akronyme

Einige Systeme erzwingen Zeichenbegrenzungen für Objektnamen. So erlauben beispielsweise Oracle 12.1 und ältere Versionen nur eine maximale Länge von 30 Bytes für Objektnamen. Daher bieten sich Abkürzungen und Akronyme bei der Objektbenennung an, auch wenn diese leicht zu Missverständnissen führen können. Um dem entgegenzuwirken, empfiehlt es sich, ein Dokument mit einer Liste aller verwendeten Abkürzungen und deren genauer Bedeutung zu erstellen. Um jedoch potenzielle Verwirrung zu vermeiden, sollten Sie den Einsatz von Abkürzungen und Akronymen auf ein Minimum beschränken.

In logischen Modellen sollten Objektnamen so selbsterklärend wie möglich sein. Das bedeutet, dass die meisten Wörter vollständig ausgeschrieben werden sollten – mit Ausnahme etablierter Abkürzungen wie „dept“ für „department“ oder „org“ für „organization“. In physischen Modellen hingegen werden typischerweise Abkürzungen und Akronyme genutzt, um die Objektnamen kurz zu halten.

Namenskonventionen: Singular- vs. Plural-Objektnamen

Es ist gängige Praxis, Substantive oder Nominalphrasen in ihrer Singularform als Objektnamen zu verwenden. So lässt sich vermeiden, dass man sich mit unregelmäßigen englischen Pluralformen (z. B. man/men, person/people) auseinandersetzen muss, was das Datenmodell unnötig verkomplizieren würde.

Namenskonventionen: Präfix vs. Suffix

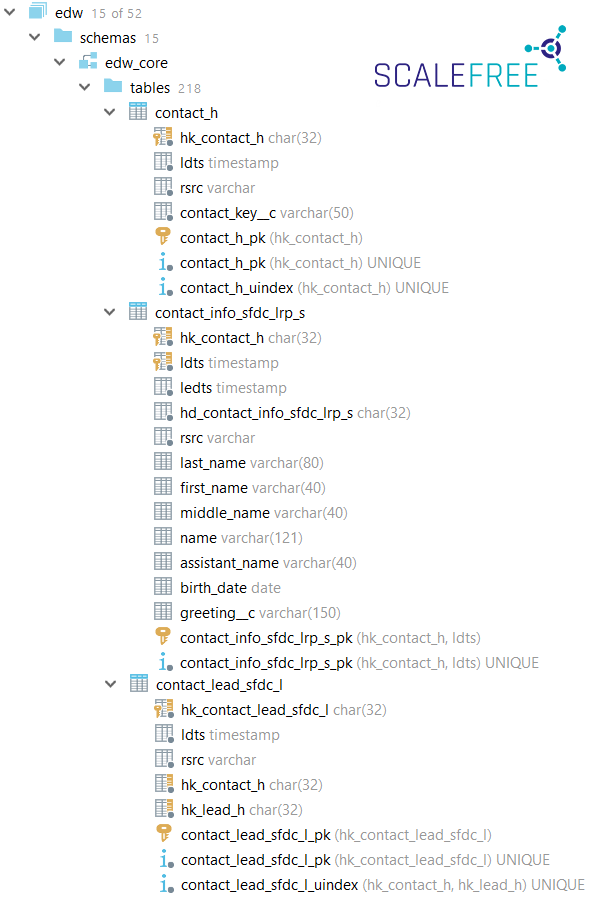
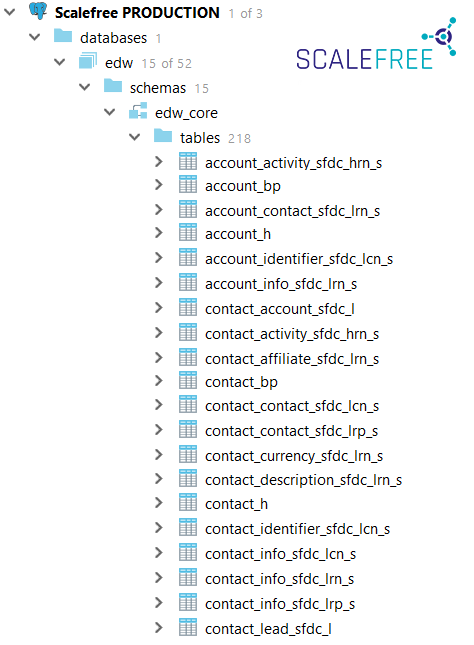
Ob Objekte mit Präfixen oder Suffixen benannt werden, ist für die Entwicklung von untergeordneter Bedeutung. Dennoch bevorzugen wir intern bei Scalefree Tabellennamen mit Suffixen wie „customer_h“ und „transaction_l“ anstelle von Präfixen. Der Vorteil dieser Methode: Da die meisten Datenbank-Tools Tabellen alphabetisch sortieren, werden alle Tabellen, die sich auf dasselbe Geschäftsobjekt beziehen, automatisch gruppiert. Beispielsweise werden alle Hubs, Satelliten und Links für Kontakte, deren Namen mit „contact_…“ beginnen, im Datenbank-Browser direkt untereinander angezeigt. Dies erleichtert die Datenexploration für Power-User und Entwickler erheblich.

Naming conventions - prefix
Figure 2: Naming Convention - Prefix

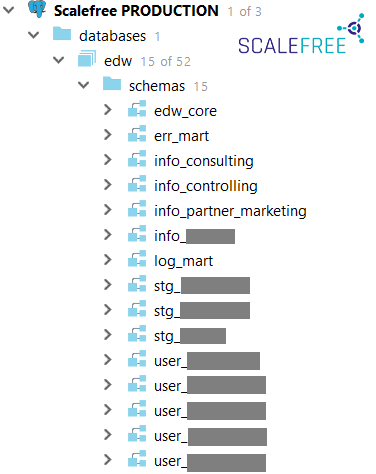
Dennoch können Präfixe in bestimmten Fällen sinnvoll sein. Beispielsweise hilft die Verwendung von Präfixen bei den Schema-Namen der verschiedenen Layer dabei, diese im Datenbank-Browser übersichtlich zu gruppieren.

Naming conventions - Schema
Figure 3: Naming Convention - Schemas

Fazit

Namenskonventionen sind zu einem gewissen Grad eine Frage der persönlichen Vorliebe und der internen Richtlinien. Unabhängig davon gilt: Je systematischer und konsistenter die Namenskonventionen definiert sind, desto größer ist der Nutzen bei der Entwicklung und Implementierung Ihrer Data-Vault-Lösung. Um dies sicherzustellen, empfehlen wir Data-Vault-Entwicklungsteams, eine einfache SQL-Funktion zu implementieren, die die gesamte Datenbank automatisch auf Abweichungen von den Namenskonventionen überprüft. So wird die Einhaltung der Standards kontinuierlich gewährleistet.

Sind Sie daran interessiert, wie wir bei Scalefree Namenskonventionen standardisieren? In einem der nächsten Artikel werden wir konkrete Vorschläge für Namenskonventionen vorstellen, die sich sowohl bei unseren Kunden als auch in unserem eigenen Team in der Praxis bewährt haben.

Lassen Sie uns in den Kommentaren diskutieren: Wie setzen Sie Namenskonventionen in Ihrer Data-Vault-Entwicklung um? Welchen Standards folgen Sie?

Alternative zur Driving-Key-Implementierung in Data Vault

Driving Key Source Table

Alternative zum Driving-Key

Es gibt einen Spezialfall, in dem sich ein Teil der in einem Link gespeicherten Hub-Referenzen ändern kann, ohne eine andere Beziehung zu beschreiben. Dies hat erhebliche Auswirkungen auf die Link-Satelliten. Darüber hinaus haben wir bereits im Jahr 2017 die Link-Struktur anhand eines Beispiels für ein Data-Vault-Modell in der Bankenbranche vorgestellt. Wir haben gezeigt, wie das Modell aussieht, wenn ein Link entweder eine Beziehung oder eine Transaktion zwischen zwei Business-Objekten darstellt. Ein Link kann auch mehr als zwei Hubs miteinander verbinden. Was ist die Alternative zur Driving-Key-Implementierung in Data Vault 2.0?

In this article:

Der Driving-Key

Eine Beziehung oder Transaktion wird in einem Quellsystem häufig durch eine Kombination von Business-Keys identifiziert. In Data Vault 2.0 wird dies als normaler Link modelliert, der mehrere Hubs verbindet, die jeweils einen Business-Key enthalten. Ein Link enthält auch seinen eigenen Hash-Key, der über die Kombination aller Business-Keys der Parent-Hubs berechnet wird. Wenn der Link also vier Hubs verbindet und sich ein Business-Key ändert, weist der neue Datensatz einen neuen Link-Hash-Key auf. Ein Problem entsteht, wenn zwar vier Business-Keys die Beziehung beschreiben, aber nur drei davon diese eindeutig identifizieren. Wir können das Business-Objekt nicht allein anhand des Hash-Keys des Links identifizieren. Dies ist zwar kein Modellierungsfehler, allerdings müssen wir bei der Datenabfrage den korrekten Datensatz im zugehörigen Satelliten identifizieren. In Data Vault 2.0 wird dies als Driving-Key bezeichnet. Es handelt sich dabei um einen konsistenten Schlüssel innerhalb der Beziehung, der im Quellsystem oft dem Primärschlüssel entspricht.

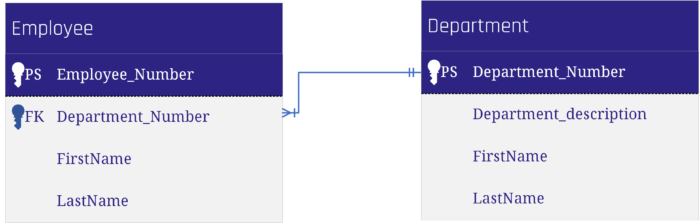
Die folgenden Tabellen veranschaulichen die Beziehung zwischen einem Mitarbeiter und einer Abteilung aus einem Quellsystem.

Driving Key Source Table
Table 1: employee-department relationship

Das folgende Data-Vault-Modell lässt sich aus dieser Quellstruktur ableiten.

Driving Key in a Data Vault Model
Figure 1: Data Vault model

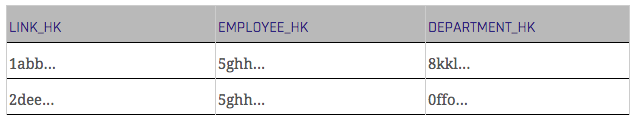
Die Link-Tabelle „Empl_Dep“ wird aus der Tabelle „Employee“ im Quellsystem abgeleitet. Der Driving-Key in diesem Beispiel ist die Employee_Number, da sie der Primärschlüssel in der Quelltabelle ist und ein Mitarbeiter zur gleichen Zeit nur in einer Abteilung arbeiten kann. Das bedeutet, dass der tatsächliche Driving-Key im Satelliten des Mitarbeiters „lebt“. Wechselt die Abteilung eines Mitarbeiters, entsteht kein zusätzlicher Datensatz in der Satellitentabelle des Mitarbeiters, sondern ein neuer in der Link-Tabelle, was völlig legitim ist.

Driving Key in a Data Vault Model
Table 2: link data

Um das aktuellste Delta zu ermitteln, müssen Sie dieses aus der Link-Tabelle abfragen und nach dem Driving-Key gruppieren.

Zusammenfassend lässt sich sagen, dass Sie immer einen neuen Link-Hash-Key erhalten, wenn sich ein Business-Key in einer Beziehung ändert. Die Herausforderung besteht darin, den Driving-Key zu identifizieren. Hierbei handelt es sich um einen eindeutigen Business-Key (oder eine Kombination von Business-Keys) für die Beziehung zwischen den verbundenen Hubs. Manchmal müssen Sie ein zusätzliches Attribut hinzufügen, um einen eindeutigen Identifikator zu erhalten.

Beides stellt ein Problem für Power-User mit Zugriff auf das Data-Vault-Modell dar. Ohne klare Namenskonventionen besteht das Risiko, dass eine GROUP-BY-Anweisung auf mehr Attribute als nur den Driving-Key angewendet wird. Dies würde zu unerwarteten und fehlerhaften Aggregatwerten führen, obwohl die Daten selbst korrekt modelliert sind

Beim Umgang mit Beziehungsdaten gibt es eine bessere Lösung als den Driving-Key: Wir bevorzugen es in der Regel, solche Daten als Non-Historized-Link zu modellieren und technische Gegenbuchungen (Counter-Transactions) in die Daten einzufügen, sobald sich eine Hub-Referenz ändert.

Im Falle eines geänderten Datensatzes in der Quelle fügen wir zwei Datensätze in den Non-Historized-Link ein: einen für die neue Version des geänderten Quell-Datensatzes und einen für die alte Version, die noch im Target existiert, aber nun ausgeglichen werden muss – den technischen Counter-Datensatz. Um die Datensätze aus der Quelle von den Counter-Transactions zu unterscheiden, wird eine neue Spalte eingeführt, die oft als „Counter“ bezeichnet wird.

Der Standardwert für dieses Counter-Attribut ist 1 für Datensätze aus der Quelle und -1 für die technischen Counter-Transactions. Wichtig: Wir führen keine UPDATE-Anweisungen aus, sondern fügen stattdessen nur neue Datensätze hinzu. Wenn Sie die Measures aus dem Link abfragen, multiplizieren Sie diese einfach mit dem Counter-Wert.

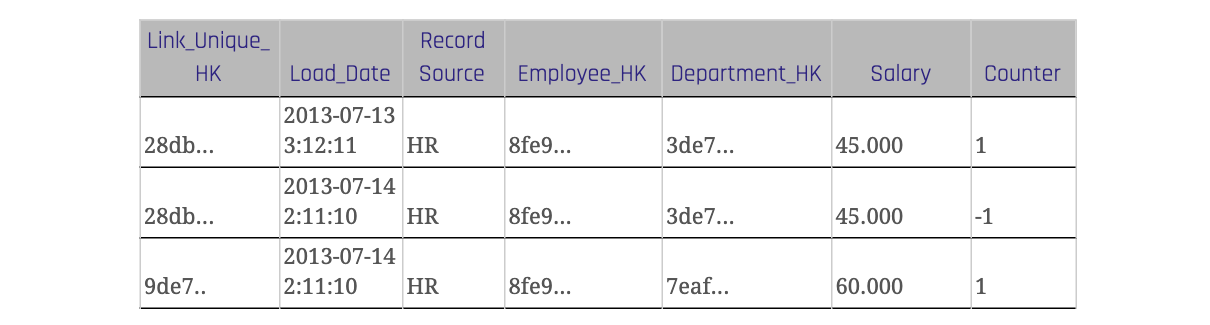
Driving Key in a Data Vault Model
Table 3: LinkConnection with counter attribute

Tabelle 3 zeigt einen Link mit einem Counter-Attribut. Wenn sich ein Datensatz im Quellsystem ändert, wird er mit dem ursprünglichen Wert und einem Counter-Wert von -1 in die Link-Tabelle des Data-Warehouses eingefügt. Für den geänderten Wert gibt es einen neuen Link-Hash-Key, der ebenfalls über das beschreibende Attribut „Salary“ berechnet wird. Der Counter-Wert des neuen Datensatzes ist 1.

Fazit

Da die Identifizierung des Driving-Keys einer Beziehung in manchen Situationen ein Problem darstellen kann, können Sie eine alternative Lösung nutzen, um den Driving-Key zu vermeiden. Alle Änderungen und Löschungen werden mithilfe eines Counter-Attributs in der Non-Historized-Link-Tabelle nachverfolgt. Diese speichert auch die beschreibenden Attribute, und der Link-Hash-Key wird über alle Attribute berechnet.

Wie Sie Insert-Only in Data Vault 2.0 implementieren

End dating satellites in Data Vault 2.0 for insert only architecture

Insert-Only in Data Vault 2.0

Eine kompetente Modellierung ist wichtig, um das volle Potenzial von Data Vault 2.0 auszuschöpfen. Um im Hinblick auf Skalierbarkeit und Performance das Beste aus dem System herauszuholen, muss es zudem auf einer Architektur aufbauen, die vollständig auf Insert-Only ausgelegt ist. Beim Laden in das Data Vault können sämtliche Update-Operationen eliminiert und die Ladeprozesse erheblich vereinfacht werden.

Die gängige Implementierung in Data Vault 2.0

In den gängigen Lademustern gibt es in Data Vault 2.0 zwei wichtige technische Zeitstempel. Der erste ist der Load Date Timestamp (LDTS). Dieser Zeitstempel stellt kein Business-Datum (Business Date) dar, das aus dem Quellsystem stammt. Stattdessen gibt er Auskunft darüber, wann die Daten zum ersten Mal in das Data Warehouse geladen wurden, in der Regel in die Staging Area.

Daher unterscheidet er sich grundlegend von den verschiedenen Business-Daten, die aus den Quellsystemen stammen und eine geschäftliche Bedeutung haben. Aus diesem Grund muss er für einen gesamten Batch-Ladeprozess generiert werden. Business-Daten, wie beispielsweise Gültigkeitsdaten, werden in Effectivity-Satelliten gespeichert, die meist mit Link-Entities verbunden sind. Sie liefern Informationen über die Beziehungen zwischen Geschäftsobjekten sowie das jeweilige Anfangs- und Enddatum.

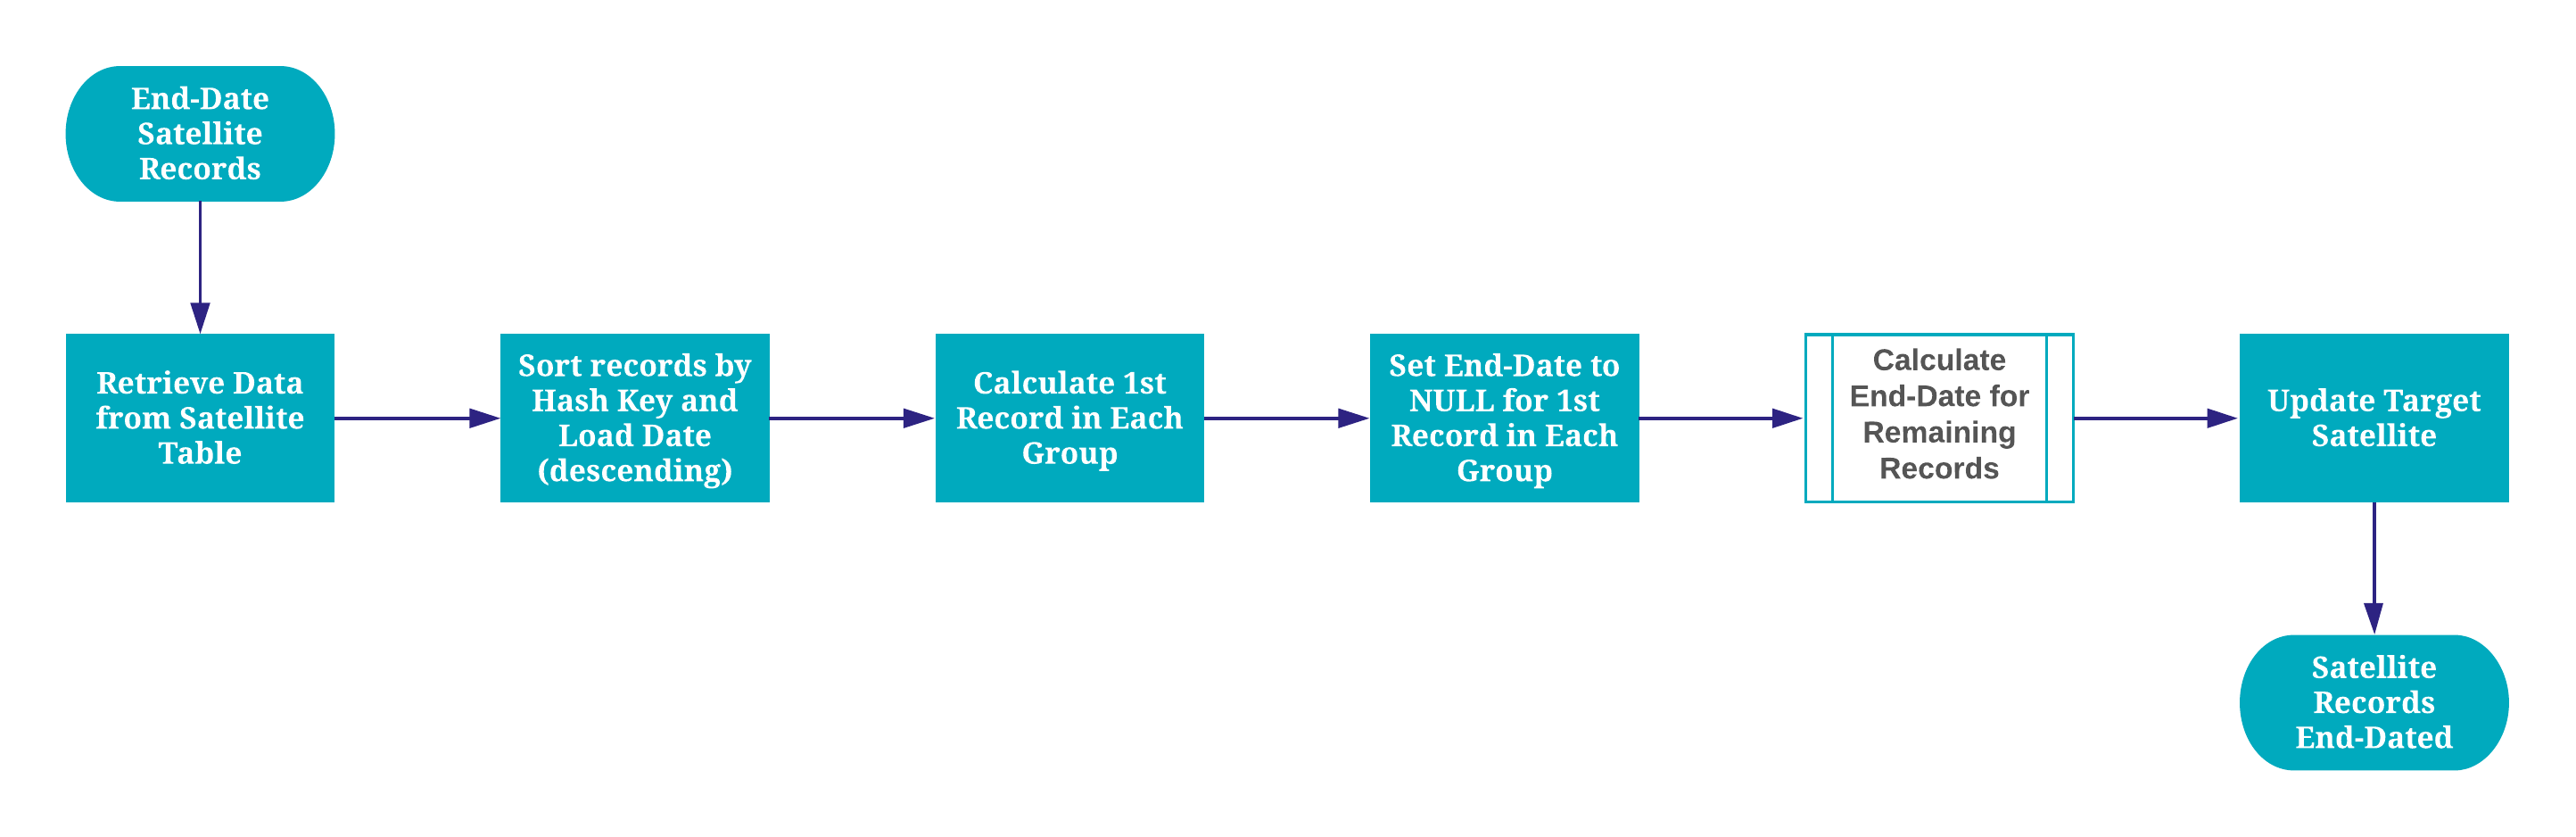
Der zweite technische Zeitstempel ist der Load End Date Timestamp (LEDTS). Wie der LDTS ist auch der LEDTS systemgeneriert und tritt nur in Satellite-Entities auf. Da diese Satelliten delta-basiert sind, gibt es immer einen Datensatz, der das aktuellste Delta darstellt. Der Wert des LEDTS bei diesen Datensätzen ist üblicherweise „9999-12-31“ (End of Time) oder NULL. Die folgende Abbildung zeigt den gesamten End-Dating-Prozess, der mit der Verwendung des LEDTS-Attributs einhergeht. Dieser wird nach dem Laden des Satelliten ausgeführt (nicht währenddessen):

End dating satellites in Data Vault 2.0 for insert only architecture
Figure 1: End dating process for satellites

Die Abbildung verdeutlicht, dass wir den Satelliten mit dem neuen LEDTS-Wert aktualisieren müssen, was zulasten der Performance geht. Wie anfangs erwähnt, möchten wir die LEDTS-Updates eliminieren, um mit einer 100-prozentigen Insert-Only-Architektur in Data Vault 2.0 eine höhere Performance zu erzielen.

An dieser Stelle stellt sich die typische Frage, wie das aktuellste Delta in einem Satelliten abgefragt werden kann, wenn wir keinen LEDTS mehr haben. Mittels max(LDTS)? Sicherlich nicht.

Der Vorteil von PIT-Tabellen in Data Vault 2.0

Die Antwort liegt in der Verwendung von Fensterfunktionen (Window Functions) zum Laden Ihrer Point-in-Time-Tabellen (PIT-Tabellen). Wir haben das Thema PIT-Tabellen bereits mit einem Beispiel aus der Versicherungsbranche in unserem Newsletter vom Oktober 2018 behandelt. 2018. Der Zweck von PIT-Tabellen besteht darin, die Abfrageperformance zu verbessern, indem Outer Joins eliminiert und aus Performancegründen Inner Joins mit Equi-Join-Bedingungen ermöglicht werden. Wir empfehlen dringend, eine PIT-Tabelle als performantere Alternative zum LEDTS aufzubauen. Die PIT-Tabelle wird mithilfe von Fensterfunktionen erstellt, um das aktuellste Delta im Satelliten zu finden. Sobald sie mit Snapshots der aktuellen Daten erstellt wurde, müssen wir den LDTS nicht mehr mit BETWEEN-Bedingungen abfragen. Die zeitliche Historie wird in Form von Snapshots gespeichert und kann mit Equi-Join-Bedingungen auf dem Hash-Key und dem LDTS zu den zugehörigen Satelliten abgefragt werden. Da PIT-Tabellen kontinuierlich wachsen, wird empfohlen, Partitionen auf dem Snapshot-Datum zu erstellen. Schließlich können die (visualisierten) Information-Mart-Dimensionen ganz einfach direkt aus der PIT-Tabelle und den zugehörigen Satelliten abgefragt werden.

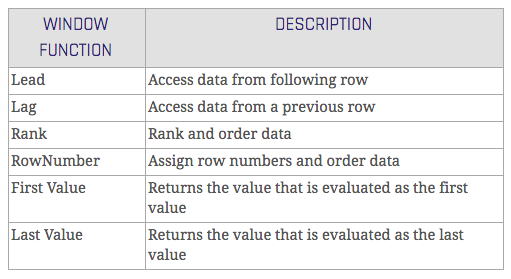
Durch die Verwendung von Fensterfunktionen auf dem Hash-Key (Partition) und dem LDTS (Order) können Sie das aktuellste Delta identifizieren, das dynamisch berechnet wird. Es gibt verschiedene Fensterfunktionen, die zur Ermittlung des aktuellsten Deltas verwendet werden können. Die folgende Tabelle zeigt einige Beispiele für diese Fensterfunktionen.

Window function in Data Vault 2.0 for insert only architecture
Table 1: Examples of window functions

Ein Grund für die Existenz des LEDTS in Data Vault ist, dass viele Datenbanken im frühen 21. Jahrhundert noch keine Fensterfunktionen unterstützten oder dafür nicht schnell genug waren.

Wie bereits im Newsletter vom Oktober 2018 erwähnt, besteht der Zweck von PIT-Tabellen darin, Inner Joins mit Equi-Join-Bedingungen zu ermöglichen. Sie sind jedoch auch der Schlüssel zu einer reinen Insert-Only-Implementierung von Data Vault 2.0, wodurch weitaus effizientere Ladeprozesse ermöglicht werden.

Fazit

Die Implementierung einer Insert-Only-Architektur in Data Vault 2.0 verbessert die Skalierbarkeit und Performance, indem Update-Operationen während des Datenladens eliminiert werden. Dieser Ansatz vereinfacht den Ladeprozess und stellt sicher, dass alle Datenänderungen als neue Datensätze erfasst werden, wodurch die historische Genauigkeit gewahrt bleibt. Durch die Nutzung von Point-in-Time-Tabellen (PIT-Tabellen) können Unternehmen die aktuellsten Daten effizient abfragen, ohne auf End-Dating-Techniken angewiesen zu sein, wodurch der Datenabruf und die Datenanalyse weiter optimiert werden.

Wie Sie Point-in-Time-Tabellen in der Versicherungsbranche nutzen

Introduction to point in time tables

Point-in-Time-Tabellen

Point-in-Time-Tabellen (PIT-Tabellen) sind nützlich, wenn Sie Daten aus dem Raw Vault abfragen, bei denen mehrere Satellites an einen Hub oder Link angebunden sind:

Introduction to point in time tables
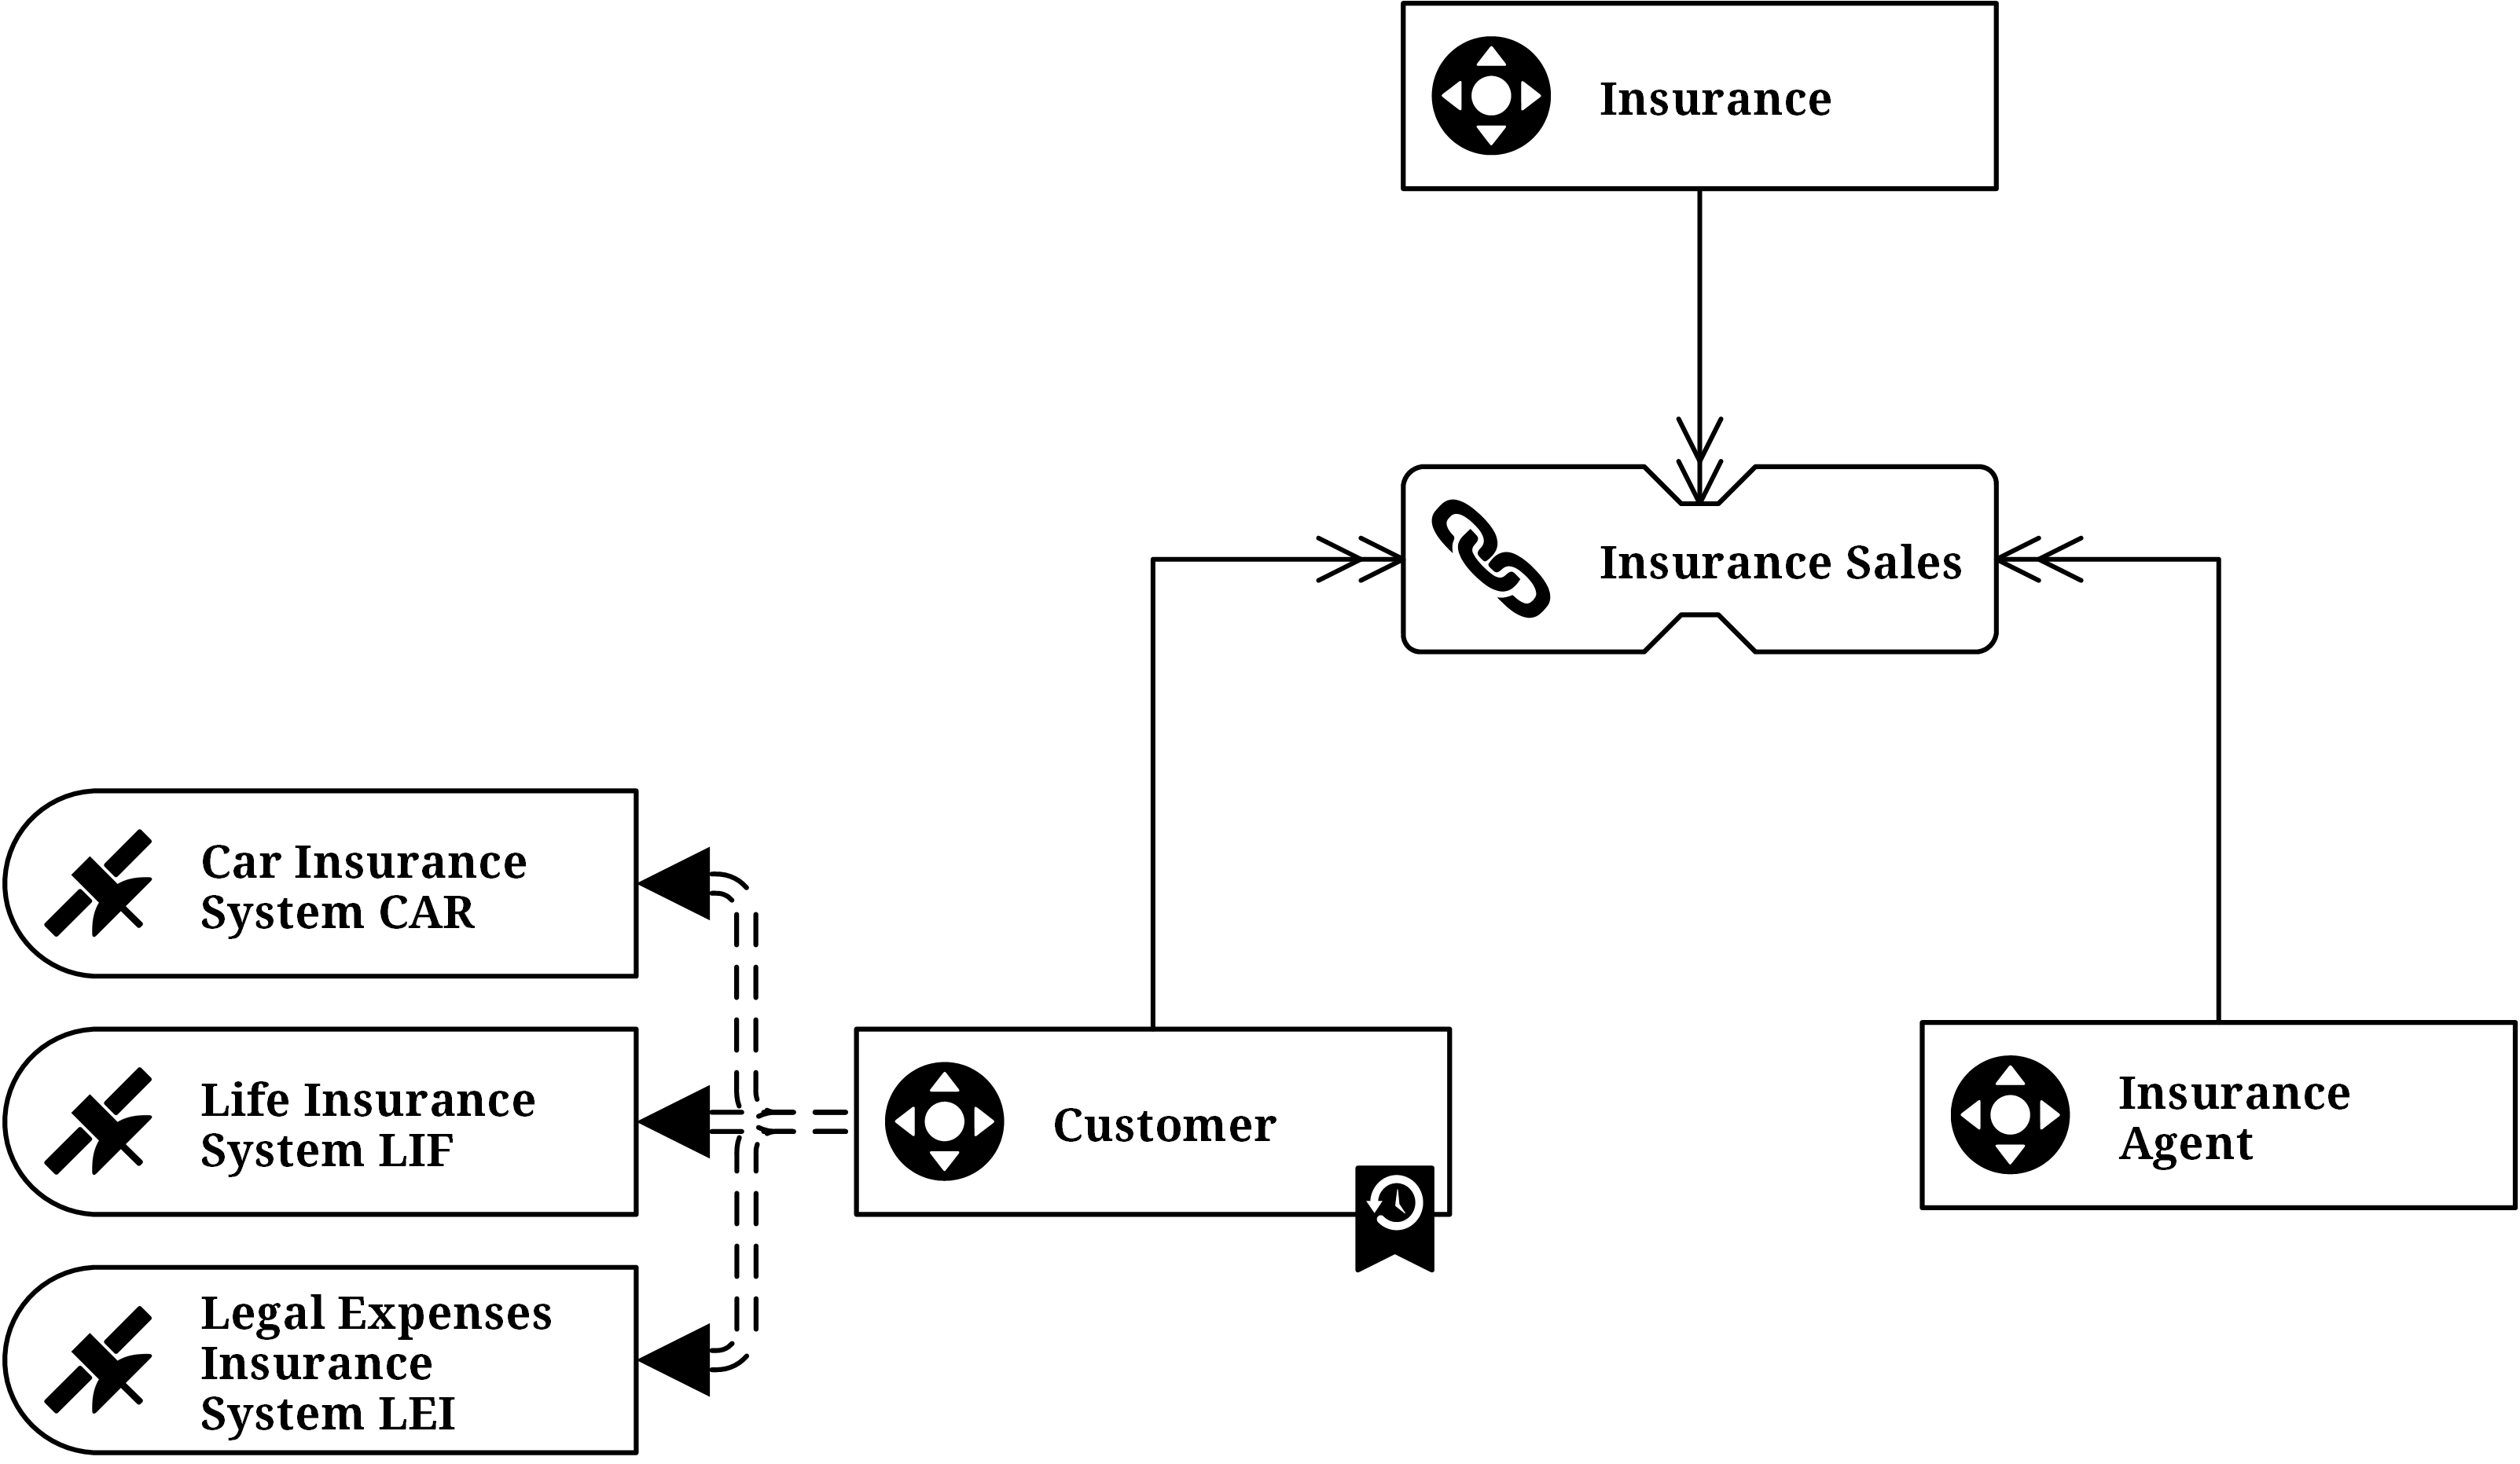
Figure 1: Data Vault model including PIT (logical)

Über Point-in-Time-Tabellen

Im obigen Beispiel sind mehrere Satellites für den Hub „Customer“ und den Link im Diagramm dargestellt. Dies ist eine sehr häufige Situation bei Data-Warehouse-Lösungen, da sie Daten aus mehreren Quellsystemen integrieren. Diese Situation erhöht jedoch die Komplexität bei der Abfrage von Daten aus dem Raw Data Vault. Das Problem entsteht, weil Änderungen an den in den Quellsystemen gespeicherten Business-Objekten nicht gleichzeitig erfolgen. Stattdessen wird ein Business-Objekt, wie z. B. ein Kunde (eine versicherte Person), zu einem bestimmten Zeitpunkt in einem der vielen Quellsysteme aktualisiert, zu einem anderen Zeitpunkt in einem anderen System usw. Beachten Sie, dass die Point-in-Time-Tabelle (PIT) bereits an den Hub angehängt ist, wie durch das Band dargestellt.

Änderungen gingen zu unterschiedlichen Zeiten ein, die nicht miteinander in Beziehung standen. Die meisten Aktualisierungen wurden beim Abschluss einer Versicherung vorgenommen, betrafen jedoch nicht alle operativen Systeme gleichzeitig. Folglich wirkte sich eine Änderung nicht auf alle Satellites aus. Stattdessen betraf sie nur denjenigen Satellite, der die Änderung abbilden sollte (was ein Vorteil ist).

Beim Erstellen eines Data Marts aus diesen Rohdaten wird die Abfrage von Kundendaten zu einem bestimmten Stichtag kompliziert: Die Abfrage muss die Kundendaten so zurückgeben, wie sie gemäß dem Delta-Prozess des Data Warehouses am ausgewählten Datum aktiv waren. Um dieses Ziel zu erreichen, sind Outer-Join-Abfragen mit komplexer Zeitbereichslogik erforderlich. Bei mehr als drei Satellites an einem Hub oder Link wird dies kompliziert und langsam. Der bessere Ansatz ist die Verwendung von Equi-Join-Abfragen, um die Daten aus dem Raw Data Vault abzurufen. Um dies zu erreichen, wird in der Data-Vault-2.0-Modellierung ein spezieller Entitätstyp verwendet: Point-in-Time-Tabellen (PIT). Diese Entität wird immer dann in ein Data-Vault-2.0-Modell integriert, wenn die Abfrageperformance für einen bestimmten Hub oder Link und die zugehörigen Satellites zu gering ist.

Point in time tables
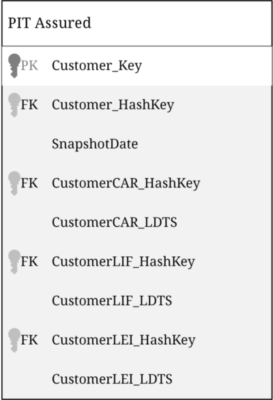
Figure 2: PIT table structure

] Da die Daten in einer PIT-Tabelle systemgeneriert sind und nicht aus einem Quellsystem stammen, müssen sie nicht auditiert werden und befinden sich nicht im Raw Vault. Daher kann ihre Struktur so angepasst werden, dass sie berechnete Spalten (Computed Columns) enthält.

Point-in-Time-Tabellen dienen zwei Zwecken:

Vereinfachung der Kombination mehrerer Deltas zu verschiedenen „Points in Time“

Eine PIT-Tabelle erstellt Snapshots von Daten für Stichtage, die von den nachgelagerten Datenkonsumenten definiert wurden. Beispielsweise ist es üblich, täglich den aktuellen Zustand der Daten bereitzustellen. Um diesen Anforderungen gerecht zu werden, enthält die PIT-Tabelle das Datum und die Uhrzeit des Snapshots in Kombination mit dem Business-Key als eindeutigen Schlüssel der Entität (ein Hash-Key, der diese beiden Attribute enthält und in Abbildung 2 als „CustomerKey“ bezeichnet wird). Für jede dieser Kombinationen enthält die PIT-Tabelle die Load-Dates und die entsprechenden Hash-Keys aus jedem Satellite, die am besten mit dem Snapshot-Datum übereinstimmen.

Reduzierung der Join-Komplexität aus Performancegründen mit Point-in-Time-Tabellen

Die Point-in-Time-Tabelle fungiert wie ein von der Abfrage verwendeter Index und liefert Informationen über die aktiven Satellite-Einträge pro Snapshot-Datum. Das Ziel besteht darin, so viel Join-Logik wie möglich zu materialisieren, um am Ende einen Inner Join mit ausschließlichen Equi-Join-Bedingungen zu erhalten. Dieser Join-Typ ist auf den meisten (wenn nicht allen) relationalen Datenbankservern die performanteste Join-Variante. Um die Performance der PIT-Tabelle zu maximieren und gleichzeitig den Speicherbedarf gering zu halten, ist in jedem von der Point-in-Time-Tabelle referenzierten Satellite nur ein einziger Ghost-Record erforderlich. Dieser Ghost-Record wird verwendet, wenn im referenzierten Satellite kein Datensatz aktiv ist, und dient als Fallback für unbekannte oder NULL-Werte. Durch die Verwendung des Ghost-Records können NULL-Prüfungen im Allgemeinen vermieden werden, da die Join-Bedingung immer auf einen aktiven Datensatz in der Satellite-Tabelle verweist: entweder auf einen tatsächlichen Datensatz, der zum angegebenen Snapshot-Datum aktiv ist, oder auf den Ghost-Record.

Example of Point in time tables
Table 1: Example of PIT table

Die obige Tabelle (Tabelle 1) zeigt eine versicherte Person mit historischen Datenständen vom 8. und 9. Oktober 2018. Am 8. Oktober gab es für diesen Kunden keinen Datensatz im Rechtsschutzversicherungs-Satellite. Aus diesem Grund sind sowohl der Hash-Key als auch der Load-Date-Zeitstempel NULL. Für eine bessere Abfrageperformance verweisen diese NULL-Werte auf den Ghost-Record in der zugehörigen Satellite-Tabelle, um die Suche nach einem nicht existierenden Datensatz zu vermeiden.

Wenn Kundendaten nur für einen bestimmten Geschäftsbereich gelöscht werden müssen und personenbezogene Daten (PII) als Business-Key dienen, müssen lediglich der Link-Eintrag und die beschreibenden Attribute im spezifischen Satellite gelöscht werden. Der Aktivitätsverlauf bleibt weiterhin verfügbar, kann für analytische Zwecke genutzt werden und lässt sich nicht mehr auf den konkreten Kunden zurückführen. Der zusätzliche Vorteil dieses „Business Splits“ zeigt sich, wenn beim Löschen von Kundendaten nur ein einzelner Geschäftsbereich betroffen ist – beispielsweise wenn die Geschäftsbereiche zu verschiedenen Tochtergesellschaften gehören und nur die Kfz-Versicherungsdaten gelöscht werden müssen. Denken Sie außerdem daran, dass das Löschen des reinen Business-Keys (unter Beibehaltung des Hash-Keys) nicht zur DSGVO-Konformität führt (und ohnehin nicht dem Data-Vault-2.0-Standard entspricht, da der Business-Key in Link-Tabellen verwendet wird). Der Hash-Key in Data Vault 2.0 wird nicht zur Verschlüsselung von Daten verwendet, sondern dient reinen Performancegründen. Der Schlüssel in den Links und den geschäftsorientierten Hubs, von denen hier die Rede ist, kann nicht zurückgerechnet werden, da es sich um einen reinen Surrogatschlüssel handelt. Sobald ein Kunde die vollständige Löschung seiner Daten wünscht, da er oder sie kein Kunde mehr in einem Ihrer Geschäftsbereiche ist, löschen Sie den Datensatz auch aus dem Haupt-Hub.

Andernfalls können Sie Ihre Daten nach dem Löschen der personenbezogenen Daten (PII) sofern kein zusätzlicher künstlicher Schlüssel für den Kunden existiert nicht mehr mit einem Objekt (einem Ankerpunkt) verknüpfen, was sie in vielen Fällen unbrauchbar macht.

Fazit

Der Zweck von Point-in-Time-Tabellen besteht darin, die Abfrageperformance zu verbessern, indem Outer Joins eliminiert und Inner Joins mit Equi-Join-Bedingungen (für die beste Performance) ermöglicht werden. Darüber hinaus verbessern Point-in-Time-Tabellen die Partitionierung und ermöglichen eine vollständige Skalierbarkeit von Star-Schemas (die vollständig virtualisiert sein sollten) auf dem Data Vault. Zudem müssen Endanwender nicht alle Satellite-Tabellen miteinander verknüpfen, sondern verbinden nur eine einzige Tabelle mit einem Business-Objekt, was die Komplexität von Ad-hoc-Abfragen erheblich reduziert.