All Posts By

Marc Winkelmann

As Senior Managing Consultant and official CDVP2.1 Instructor since 2020, Marc brings more than ten years of dedicated Data Vault experience to complete end-to-end data platform implementations. His core strength lies in empowering entire data teams to build highly scalable data and AI solutions.

Die neuesten Innovationen von Data Vault 2.0

Data Vault 2.0 Training FAQ - Customized Class

Fokus auf Trends: Data Lake und NoSQL, DWH-Architektur, Self-Service-BI, Modellierung und DSGVO

In der Vergangenheit haben wir regelmäßig über Themen berichtet, mit denen wir bei der Beratung unserer Kunden konfrontiert wurden oder die in Fachdiskussionen im Web besondere Aufmerksamkeit erregt haben.

Alle diese Themen sind in Data Vault 2.0 bereits fest verankert und rückten in den vergangenen Monaten noch stärker in den Fokus. Begleitend zu den Entwicklungen in der Privatwirtschaft spielen NoSQL-Datenbanken mittlerweile eine tragende Rolle, wenn es darum geht, Daten aus unterschiedlichsten Quellsystemen performant zu speichern. Dies eröffnet neue Möglichkeiten der Datenanalyse, bringt jedoch auch neue Herausforderungen mit sich – beispielsweise bei der Frage, wie sich Abfragen über solche semistrukturierten und unstrukturierten Datenmengen effizient durchführen lassen, etwa durch den Einsatz von Massive Parallel Processing (MPP). Darüber hinaus existiert eine Vielzahl von Werkzeugen für Speicherung, Transfer, Transformation und Analyse, was nicht selten zu zeit- und kostenintensiven Evaluierungen führt. Ein fundiertes Verständnis von „Schema on Write“ und „Schema on Read“ sowie deren Unterschieden ist für die Konzeption eines modernen Data Warehouse unverzichtbar geworden. Ein fest definiertes Schema war und bleibt für Business Analysts essenziell, sobald Daten zu Analysezwecken mit fachlichen Business Objects verknüpft werden müssen. Die ausschließliche Ablage sämtlicher Daten auf NoSQL-Plattformen (im Sinne eines reinen Data Lake) eignet sich zwar hervorragend zur zentralen Datenerfassung; für Fachanwender gestaltet sich der strukturierte Abruf jedoch oft deutlich komplexer. Ein praxiserprobter und empfohlener Ansatz besteht daher darin, einen Data Lake und ein Data Warehouseinnerhalb einerhybriden Architekturwirkungsvoll zu kombinieren.

Continue Reading

Wie Sie mit Disciplined Agile skalieren

Über Scrum hinausblicken und den Mehrwert in Data Vault 2.0-Projekten steigern

Zu Beginn dieses Jahres haben wir über Managed Self-Service BI gesprochen, um aufzuzeigen, wie Geschäftsanwender von diesem Ansatz in Data Vault 2.0 profitieren können. Nun möchten wir Ihnen aus der Perspektive des Projektmanagements aufzeigen, wie Sie dieses Ziel erreichen können – insbesondere in großen Unternehmen, in denen der Standard-Scrum-Ansatz oft nicht mit den geltenden Deployment- und Release-Vorgaben vereinbar ist und alternative Ansätze wie das Disciplined Agile Framework besser geeignet sind.

Eine agile Transformation ist anspruchsvoll, da jeder Kulturwandel mit Herausforderungen verbunden ist. Es handelt sich hierbei nicht um ein einzelnes isoliertes Problem, sondern um Hunderte von Entscheidungen über einen langen Zeitraum hinweg. Diese betreffen viele Mitarbeiter und beeinflussen bestehende Beziehungen, Prozesse sowie das Mindset aller Beteiligten, die innerhalb dieses Wandels agieren.

Es gibt zwei grundlegende Ansätze dazu, was es bedeutet, Agilität zu skalieren: Einerseits die Anpassung agiler Strategien an die Skalierungsherausforderungen einzelner Entwicklungsteams – wie etwa geografische Verteilung, regulatorische Compliance und wachsende Teamgrößen –, andererseits die unternehmensweite Verankerung von Agilität. Beide Aspekte sind essenziell. Wenn Sie jedoch Ersteren nicht erfolgreich umsetzen, besteht wenig Aussicht darauf, bei Letzterem erfolgreich zu sein.

Continue Reading

Haben Sie immer noch Probleme mit der DSGVO?

Hubs & GDPR

DSGVO

Die Datenschutz-Grundverordnung (DSGVO / GDPR) ist ein Gesetz der Europäischen Union (EU) und trat am 25. Mai 2018 in Kraft. Diese Verordnung soll ein hohes Schutzniveau für personenbezogene Daten der Bürgerinnen und Bürger in der EU gewährleisten. Das bedeutet, dass Unternehmen weltweit Transparenz schaffen, den Einzelnen die Kontrolle über ihre Daten einräumen und eine eindeutige Einwilligungserklärung einholen müssen, um personenbezogene Daten zu speichern und zu verarbeiten. Während die Gesetzgebung außerhalb der EU (insbesondere in den USA) oft eher unternehmens- als verbraucherfreundlich ist, betrifft die DSGVO alle Unternehmen weltweit, die personenbezogene Daten von EU-Bürgern verarbeiten.

Was ist neu an der DSGVO?

Ein sorgfältiger Umgang mit personenbezogenen Daten ist nichts Neues – insbesondere nicht in der EU. Die wesentliche Änderung bei der Erhebung und Verarbeitung besteht darin, dass personenbezogene Daten nun vollständig unter der Kontrolle der betroffenen Person stehen. Diese kann Unternehmen dazu verpflichten, ihre Daten zu löschen oder zu anonymisieren sowie Kopien aller im System gespeicherten personenbezogenen Daten anzufordern. Personenbezogene Daten oder Personally Identifiable Information (PII) sind alle Informationen, mit denen eine Einzelperson identifiziert werden kann, wie z. B. Name, Telefonnummer oder E-Mail-Adresse. Continue Reading

Brauchen wir noch ein Data Warehouse?

Managed Self Service BI

„Big Data“, „Data Lake“, „Data Swamp“, „Hybrid Architecture“, „NoSQL“, „Hadoop“ … Mit diesen Begriffen werden Sie heutzutage sehr häufig konfrontiert, wenn Sie mit Daten arbeiten. Vor diesem Hintergrund stellt sich die Frage, ob Sie angesichts einer enormen Datenvielfalt und eines stetig wachsenden Datenvolumens tatsächlich noch ein Data Warehouse benötigen. In diesem Beitrag erläutern wir, was ein Data Lake ist, ob beim Einsatz von NoSQL-Plattformen wie Hadoop weiterhin ein Data Warehouse erforderlich ist und wie sich dieses optimal mit Data Vault kombinieren lässt.

Was ist ein Data Lake?

Tamara Dull (SAS) liefert hierzu eine treffende Definition: „Ein Data Lake ist ein Repository, das eine riesige Menge an Rohdaten in ihrem nativen Format vorhält – einschließlich strukturierter,, halbstrukturierterund unstrukturierter Daten. Die Datenstruktur und die Anforderungen werden erst dann definiert, wenn die Daten tatsächlich benötigt werden.“ 1 Continue Reading

Wie lässt sich Managed Self-Service BI mit Data Vault 2.0 kombinieren?

Managed Self-Service BI and Data Vault 2.0

Kombination von Managed Self-Service BI mit Data Vault 2.0

Dieser Artikel untersucht, wie die Kombination von Managed Self-Service BI mit Data Vault 2.0 es Unternehmen ermöglicht, Data Governance und Agilität auszubalancieren und sowohl Kontrolle als auch Flexibilität in ihren Analyseprozessen zu gewährleisten. Im vergangenen Monat haben wir über eine hybride Architektur in Data Vault 2.0 gesprochen und erklärt, wie strukturierte und unstrukturierte Daten darin kombiniert werden. Anknüpfend an dieses Thema möchten wir nun erläutern, wie Ihre Fachanwender (insbesondere Power User) vom Ansatz der Managed Self-Service Business Intelligence (mSSBI) in Data Vault 2.0 profitieren können.

Über Self-Service BI

Self-Service BI ermöglicht es Endanwendern, die IT aufgrund fehlender Reaktionsgeschwindigkeit der Fachabteilungen vollständig zu umgehen. Bei diesem Ansatz sind die Fachanwender beim gesamten Prozess der Datenbeschaffung aus operativen Systemen sowie bei der Integration und Konsolidierung der Rohdaten auf sich allein gestellt. Es gibt viele Probleme bei diesem Self-Service-Ansatz ohne Einbindung der IT:

  • Direkter Zugriff auf Quellsysteme
  • Nicht integrierte Rohdaten
  • Geringe Datenqualität
  • Unkonsolidierte Rohdaten
  • Nicht standardisierte Business Rules

In vielen Fällen stehen Endanwendern – selbst wenn es sich um Power User mit Kenntnissen in SQL, MDX und anderen Technologien handelt – nicht die richtigen Werkzeuge zur Verfügung, um die Aufgaben effizient zu lösen. Stattdessen wird viel Arbeit manuell und fehleranfällig erledigt. Aus unserer Erfahrung ist es jedoch nicht möglich, solche Power User vollständig daran zu hindern, Daten aus Quellsystemen zu beschaffen, aufzubereiten und schließlich an das Top-Management zu berichten. Was Unternehmen brauchen, ist eine Balance zwischen IT-Agilität und Datenmanagement, die es Power Usern ermöglicht, die benötigten Daten schnell und in verlässlicher Qualität zu erhalten. Um diese Probleme zu lösen, erlaubt der Data-Vault-2.0-Standard erfahrenen oder fortgeschrittenen Fachanwendern, eigene Datenanalysen direkt auf den Rohdaten des Data Warehouse durchzuführen.

Über den Managed-Self-Service-BI-Ansatz

Eine auf Data Vault 2.0 gestützte IT begrüßt es, wenn Fachanwender die im Enterprise Data Warehouse verfügbaren Daten (entweder im Raw Data Vault oder im Business Vault) nutzen, um mithilfe spezialisierter Tools lokale Information Marts zu erstellen. Diese Tools rufen die Daten aus dem Enterprise Data Warehouse ab, wenden eine Reihe benutzerdefinierter Business Rules an und präsentieren das Ergebnis dem Endanwender. Die IT kann auch Strukturen erstellen, in denen unternehmensweite Business Rules angewendet werden, um eine konsolidierte Sicht auf Teile des Modells zu bieten oder KPIs im Voraus zu berechnen, um die Konsistenz solcher Berechnungen zu gewährleisten. Da beide Arten von Daten (Rohdaten und Daten mit angewendeten Business Rules) bereits integriert sind, kann der Fachanwender auch konsolidierte Daten mit Rohdaten aus spezifischen Quellsystemen zusammenführen. Dieser Ansatz wird als Managed Self-Service BI bezeichnet, bei dem sich die IT zu einer Serviceorganisation entwickelt, die den Power Usern die gewünschten Daten im benötigten Zeitrahmen zur Verfügung stellt. Die Daten werden über ihren Business Key integriert und können sowohl konsolidiert als auch auf ihre Qualität geprüft werden.

Implementierung von mSSBI in der Data-Vault-2.0-Architektur

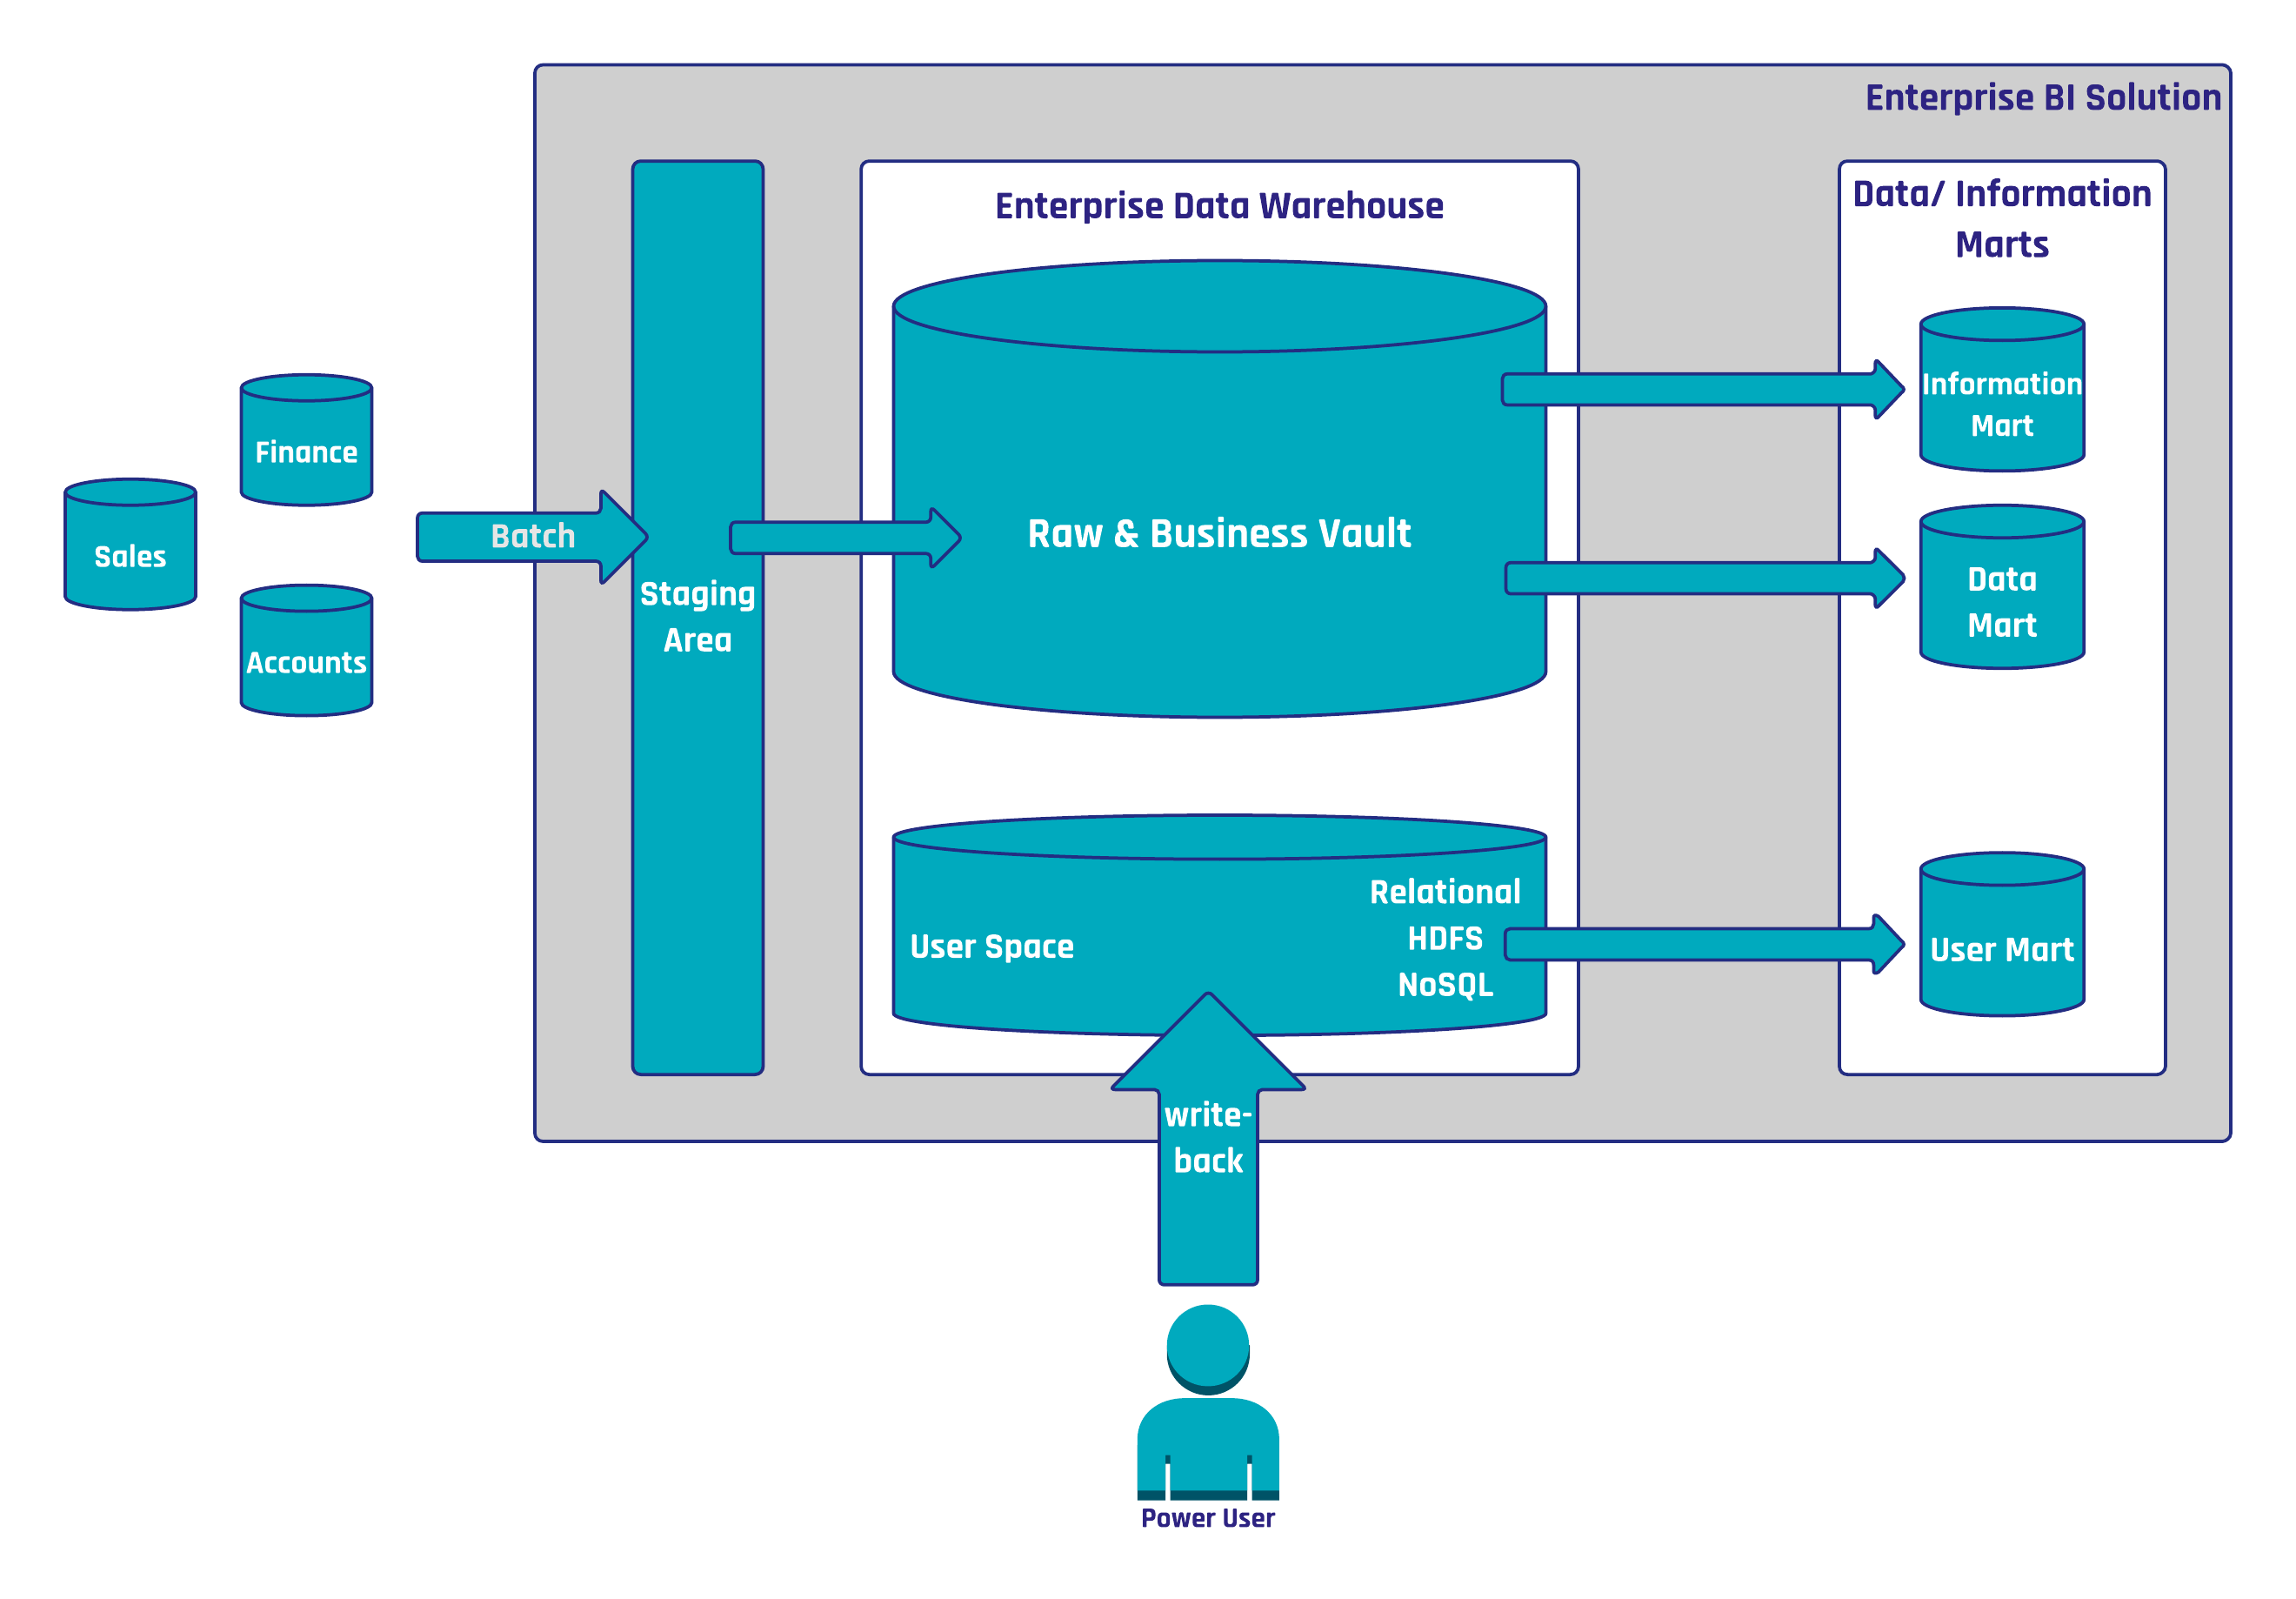
Die Data-Vault-2.0-Architektur bietet Self-Service-Funktionen für Power User im Unternehmen:

Managed Self-Service BI and Data Vault 2.0
Figure1 : mSSBI Architecture

In diesem Szenario können Power User, die eigene, individuelle Lösungen entwickeln, Daten und Informationen in das Enterprise Data Warehouse zurückschreiben (Write-Back), indem sie einen dafür vorgesehenen User Space nutzen. Das Write-Back kann später in der Lösung für die Informationsbereitstellung wiederverwendet werden. Darüber hinaus können Fachanwender ihre eigenen Stammdaten über eine MDM-Anwendung verwalten. Dies ermöglicht es autorisierten Fachanwendern, Parameterwerte zu ändern und somit die Ergebnisse der Business Rules zu beeinflussen.

Der Unterschied zwischen Managed Self-Service BI und dem branchenüblichen Self-Service-BI-Ansatz besteht darin, dass Data Vault 2.0 eine verwaltete Umgebung bietet, in der Daten und Informationen kontrolliert und sicher bereitgestellt werden. Power User können aus Sicht der Datensicherheit nur die Daten abfragen, für die sie eine entsprechende Berechtigung besitzen.
Ein weiterer Vorteil besteht darin, dass dieser Ansatz es Unternehmen in der Finanz- und Sicherheitsbranche ermöglicht, eine vollständig prüfbare und nachvollziehbare Umgebung bereitzustellen, die den höchsten Compliance-Anforderungen entspricht.

Managed Self-Service BI erfordert eine Write-Back-Möglichkeit in der Enterprise-Data-Warehouse-Architektur, andernfalls handelt es sich lediglich um eine herkömmliche BI-Lösung. Ohne Write-Back fehlen wesentliche Alleinstellungsmerkmale. Darüber hinaus ist ein Write-Back notwendig, um die bereitgestellten Daten anzureichern oder deren Qualität zu verbessern. Data Scientists beispielsweise nutzen dies kontinuierlich: Bei der Verwendung von Hadoop erstellen sie als Ergebnis ihrer Verarbeitung eine neue Zieldatei. Dies entspricht einem direkten Write-Back im Hadoop-Umfeld. Wir fordern Write-Back für Self-Service BI bereits seit Jahren, da andernfalls Stammdaten- und Hierarchiemanagement nicht ordnungsgemäß funktionieren.

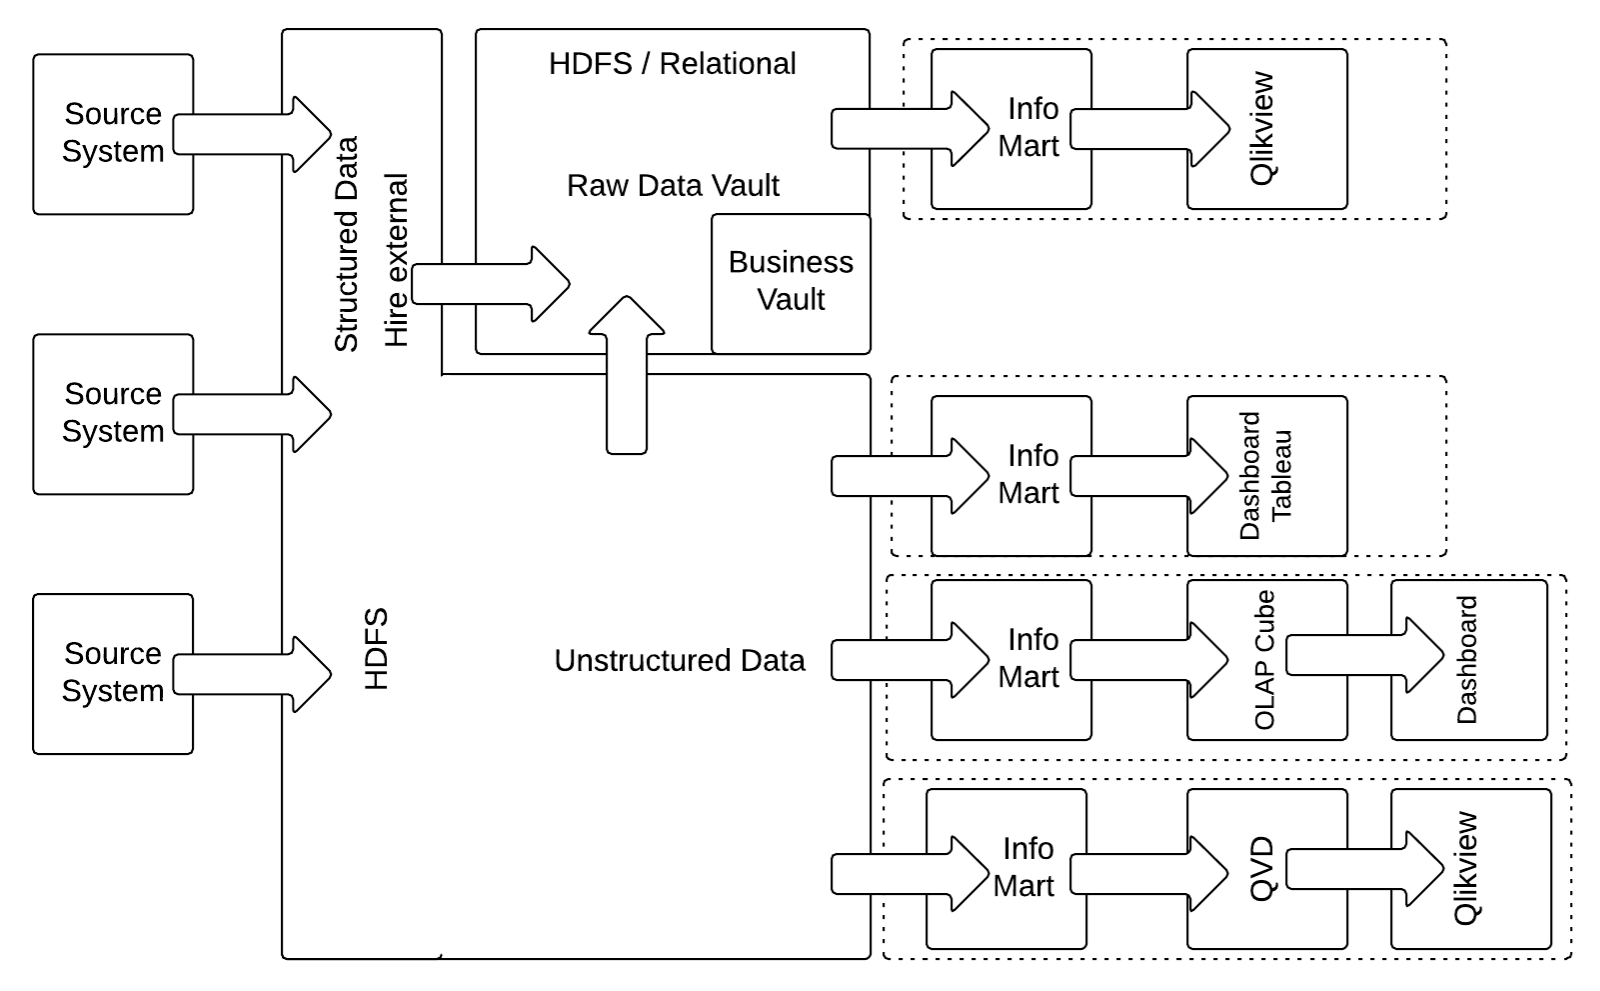
In dieser Modifikation der Architektur aus dem vorherigen Abschnitt wird die relationale Staging Area durch eine HDFS-basierte Staging Area ersetzt, die alle unstrukturierten und strukturierten Daten erfasst. Während das Erfassen strukturierter Daten auf HDFS auf den ersten Blick wie ein Zusatzaufwand (Overhead) erscheint, reduziert diese Strategie die Belastung der Quellsysteme, indem sichergestellt wird, dass die Quelldaten unabhängig von strukturellen Änderungen zuverlässig extrahiert werden. Die Daten werden anschließend mit Apache Drill, Hive External oder ähnlichen Technologien abgefragt. Es ist ebenso möglich, den Raw Data Vault und den Business Vault (die strukturierten Daten im Data-Vault-Modell) auf Hive Internal zu speichern.

Fazit

Die Kombination von Managed Self-Service BI mit Data Vault 2.0 ermöglicht es Unternehmen, die optimale Balance zwischen Data Governance und Agilität in ihren Datenökosystemen zu erreichen. Durch die Nutzung der strukturierten, auditierbaren Architektur von Data Vault in Verbindung mit der Flexibilität von Self-Service BI stellen Unternehmen Datengenauigkeit, Sicherheit und Skalierbarkeit sicher und unterstützen Anwender gleichzeitig dabei, schneller wertvolle Erkenntnisse zu gewinnen. Dieser Ansatz fördert die effektive Zusammenarbeit zwischen IT und Fachabteilungen, was zu fundierteren Entscheidungen führt und datengestützte Innovationen beschleunigt.

Hybride Architektur in Data Vault 2.0

Data Vault 2.0 Hybrid Architecture

Hybride Architektur in Data Vault 2.0

Business-Anwender erwarten von ihren Data-Warehouse-Systemen, dass sie immer mehr Daten hinsichtlich Vielfalt, Volumen und Geschwindigkeit laden und aufbereiten. Auch die Arbeitslast typischer Data-Warehouse-Umgebungen steigt immer weiter an, insbesondere wenn die erste Version des Warehouses bei den ersten Anwendern ein Erfolg war. Skalierbarkeit hat daher mehrere Dimensionen. Letzten Monat haben wir über Satellites gesprochen, die eine wichtige Rolle bei der Skalierbarkeit spielen. Nun erklären wir, wie Sie strukturierte und unstrukturierte Daten mit einer hybriden Architektur kombinieren.

Logische Data-Vault-2.0-Architektur

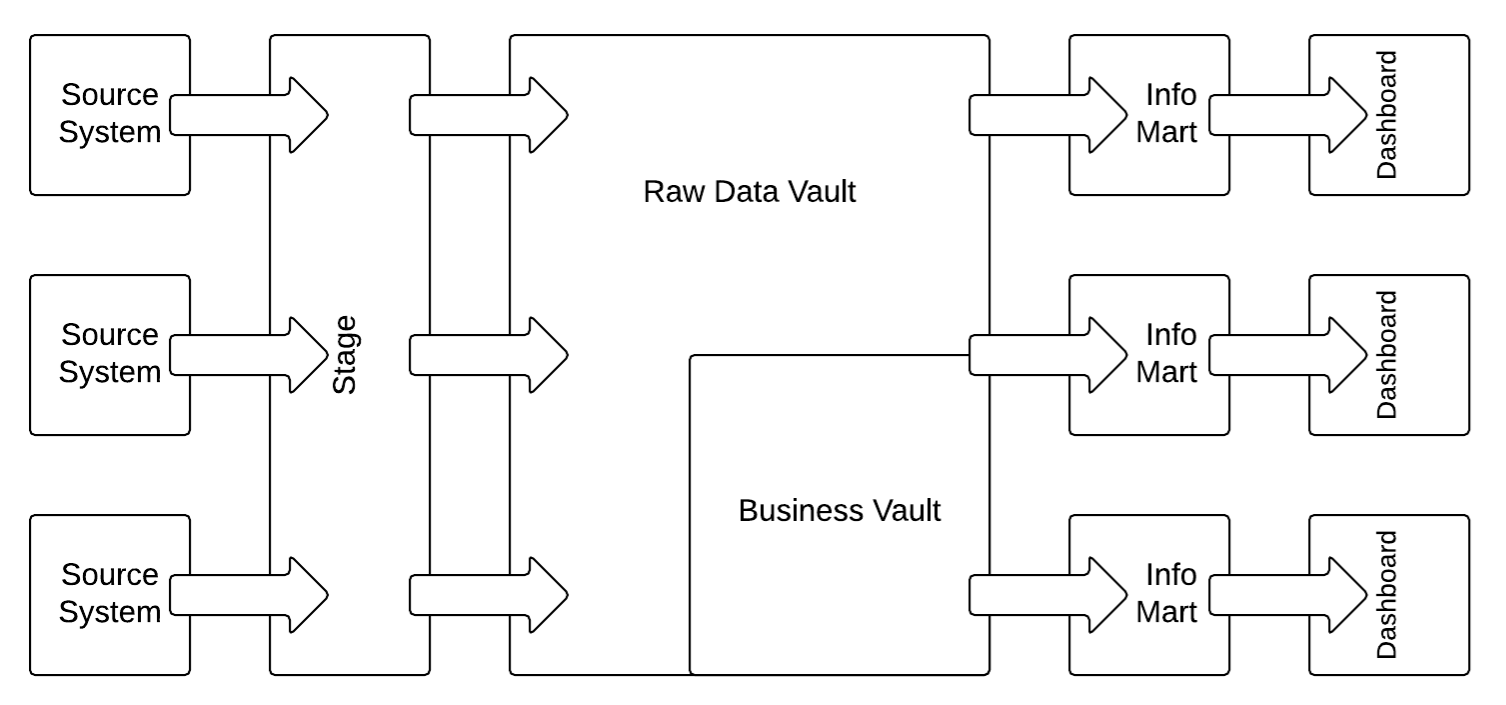
Die Data-Vault-2.0-Architektur basiert auf drei Schichten: der Staging Area, die die Rohdaten aus den Quellsystemen sammelt, der Enterprise-Data-Warehouse-Schicht, die als Data-Vault-2.0-Modell aufgebaut ist, und der Information-Delivery-Schicht mit Information Marts als Star-Schemata und anderen Strukturen. Die Architektur unterstützt sowohl das Batch-Laden aus Quellsystemen als auch das Laden in Echtzeit über den Enterprise Service Bus (ESB) oder jede andere serviceorientierte Architektur (SOA).

Das folgende Diagramm zeigt die grundlegende logische Data-Vault-2.0-Architektur:

Data Vault 2.0 Architecture
Figure 1: Logical Data Vault 2.0 Architecture

In diesem Fall werden strukturierte Daten aus Quellsystemen zuerst in die Staging Area geladen, um die Systembelastung der operativen Quellsysteme zu minimieren. Anschließend werden sie unverändert in den Raw Data Vault geladen, der die Enterprise-Data-Warehouse-Schicht darstellt. Nachdem die Daten in dieses Data-Vault-Modell (bestehend aus Hubs, Links und Satellites) geladen wurden, werden im Business Vault Business-Regeln auf die Daten des Raw Data Vaults angewendet. Sobald die Business-Logik angewendet wurde, werden die Daten aus dem Raw Data Vault und dem Business Vault zusammengeführt und für die Information Delivery in den Information Marts in das Business-Modell umstrukturiert. Der Business-Anwender nutzt Dashboard- oder Reporting-Anwendungen, um auf die Informationen in den Information Marts zuzugreifen

Die Architektur ermöglicht die Implementierung der Business-Regeln im Business Vault durch eine Kombination verschiedener Technologien, wie beispielsweise SQL-basierte Virtualisierung (typischerweise über SQL-Views) und externe Tools wie Business-Rule-Management-Systeme (BRMS).

Es ist jedoch auch möglich, unstrukturierte NoSQL-Datenbanksysteme über eine hybride Architektur zu integrieren. Aufgrund der Plattformunabhängigkeit von Data Vault 2.0 kann NoSQL für jede Data-Warehouse-Schicht verwendet werden – einschließlich der Staging Area, der Enterprise-Data-Warehouse-Schicht und der Information-Delivery-Schicht. Daher kann die NoSQL-Datenbank als Staging Area genutzt werden, um Daten in die relationale Data-Vault-Schicht zu laden. Sie kann jedoch auch in beide Richtungen über einen gehashten Business Key in die Data-Vault-Schicht integriert werden. In diesem Fall handelt es sich um eine hybride Architekturlösung, bei der die Information Marts Daten aus beiden Umgebungen beziehen.

Hybride Architektur

Die Standard-Data-Vault-2.0-Architektur in Abbildung 1 konzentriert sich auf strukturierte Daten. Da immer mehr Unternehmensdaten semistrukturiert oder unstrukturiert vorliegen, ist es Best Practice für ein neues Enterprise Data Warehouse, eine hybride Architektur auf Basis eines Hadoop-Clusters zu verwenden, wie in der folgenden Abbildung dargestellt:

Data Vault 2.0 Hybrid Architecture
Figure 2: Hybrid Data Vault 2.0 Architecture

In dieser modifizierten hybriden Architektur wird die relationale Staging Area durch eine HDFS-basierte Staging Area ersetzt, die sowohl unstrukturierte als auch strukturierte Daten erfasst. Auch wenn die Erfassung strukturierter Daten im HDFS auf den ersten Blick wie ein zusätzlicher Overhead erscheint, verringert diese Strategie die Belastung der Quellsysteme, da sie sicherstellt, dass die Quelldaten unabhängig von strukturellen Änderungen stets extrahiert werden können. Die Daten werden dann mit Apache Drill, Hive External oder ähnlichen Technologien extrahiert.

Zudem ist es möglich, den Raw Data Vault und den Business Vault (die strukturierten Daten im Data-Vault-Modell) in Hive Internal zu speichern.

Fazit

Die Integration einer hybriden Architektur in Data Vault 2.0 ermöglicht es Unternehmen, sowohl strukturierte als auch unstrukturierte Daten durch die Nutzung von Plattformen wie Hadoop effektiv zu verwalten. Dieser Ansatz verbessert die Skalierbarkeit sowie Flexibilität und ermöglicht eine effiziente Datenverarbeitung und -speicherung. Indem traditionelle relationale Staging Areas durch HDFS-basierte Systeme ersetzt werden, können Unternehmen die Belastung der Quellsysteme reduzieren und eine nahtlose Datenextraktion gewährleisten.

Visual Data Vault: Modellierung von Satellites im Gesundheitswesen

Data Vault 2.0 ist ein von Dan Linstedt entwickeltes Konzept für das Data Warehousing. Es bringt viele neue Features mit sich, die allen Fachkräften im Bereich Business Intelligence den Einstieg in ein neues Zeitalter des Data Warehousing ermöglichen. Data Vault 2.0 ist ein Big-Data-Konzept, das relationales Data Warehousing mit unstrukturiertem Data Warehousing in Echtzeit vereint. Es handelt sich um ein erweiterbares Datenmodell, dem sich neue Datenquellen mühelos hinzufügen lassen. Als unsere Gründer ihr Fachbuch verfassten, benötigten sie einen visuellen Ansatz, um die Konzepte von Data Vault anschaulich zu modellieren. Zu diesem Zweck entwickelten sie eine grafische Modellierungssprache, die sich auf die logischen Aspekte von Data Vault konzentriert. Die Microsoft-Visio-Stencils und ein detailliertes Whitepaper stehen auf www.visualdatavault.com als kostenloser Download zur Verfügung.

In diesem Jahr haben wir bereits über die Modellierung von Hubs und Links in Data Vault 2.0 berichtet. Nun möchten wir Ihnen die dritte Standard-Entität vorstellen: den Satellite.

SATELLITES IN VISUAL DATA VAULT

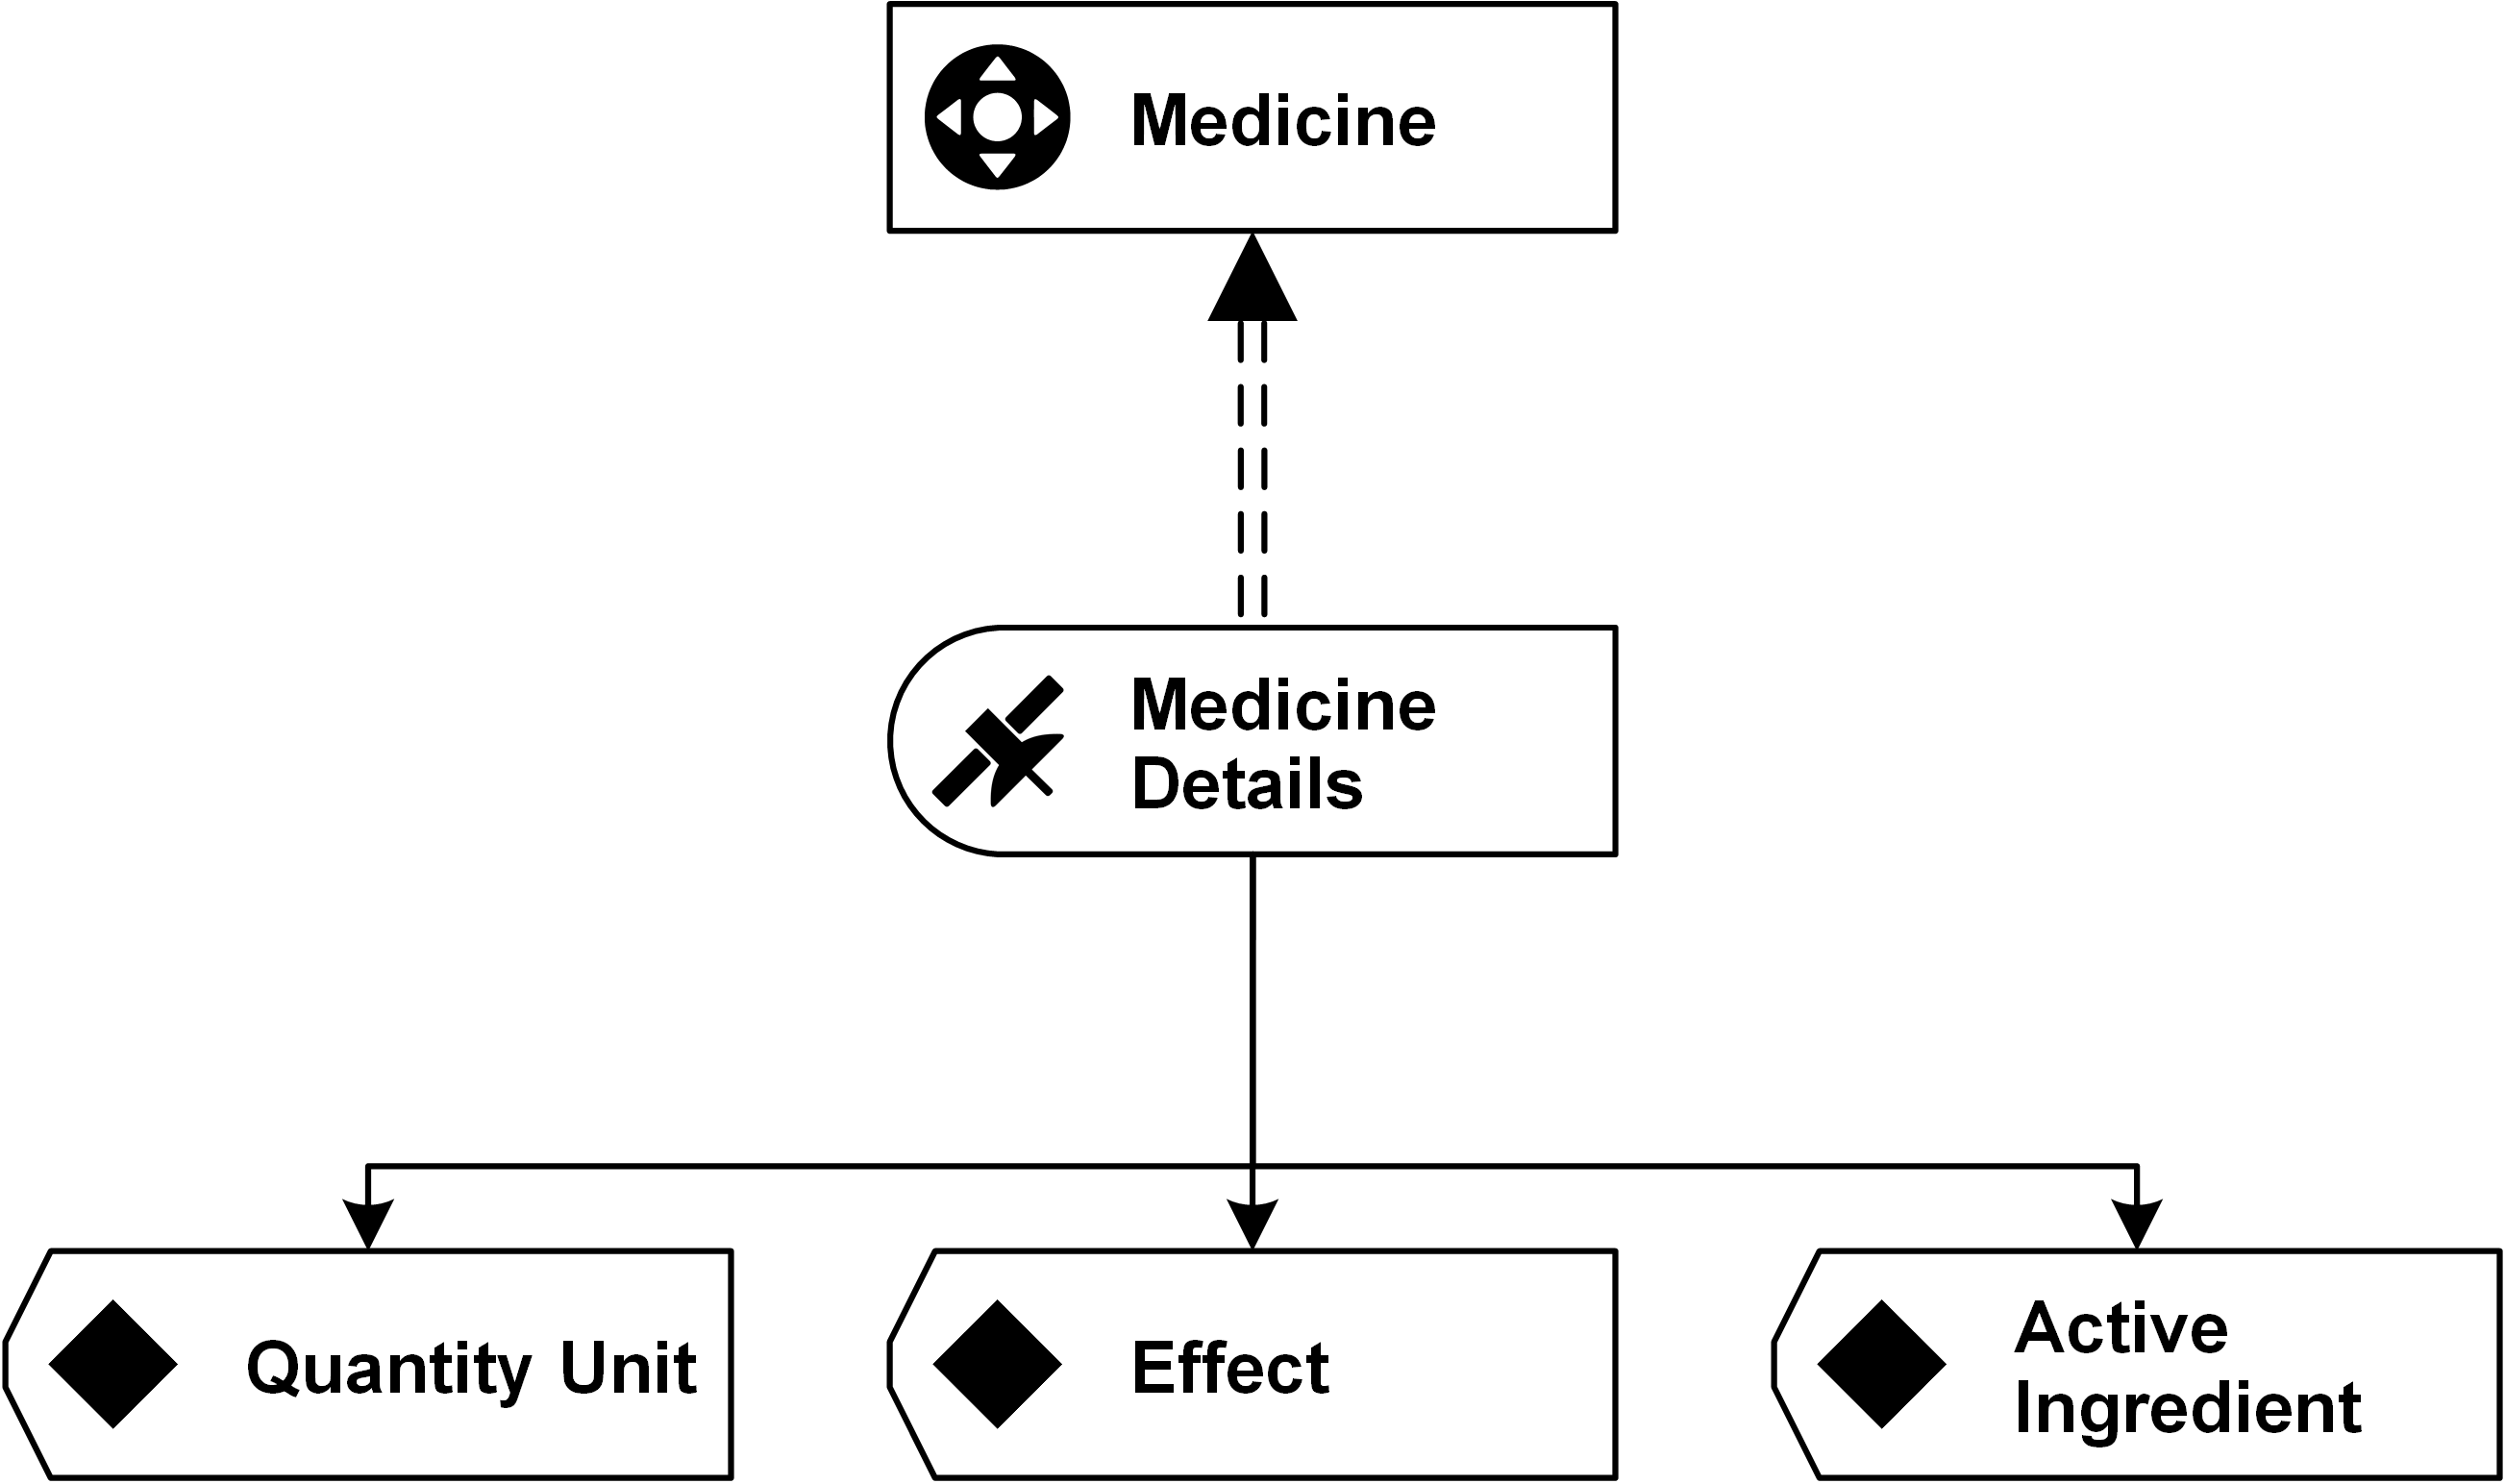
Satellites reichern Hubs und Links mit beschreibenden Daten an. Diese beschreibenden Daten werden in Attributen gespeichert, die dem Satellite zugeordnet sind. Die einzelnen Attribute werden dem Satellite schrittweise hinzugefügt. Ein Satellite kann an jeden beliebigen Hub oder Link angehängt werden, allerdings immer nur an genau ein übergeordnetes Parent-Element. Continue Reading

Visual Data Vault: Link-Modellierung in der Bankenbranche

Visual Data Vault example for links

Visual Data Vault

Der folgende Artikel beschreibt die Darstellung von Links anhand eines praxisnahen Beispiels aus Visual Data Vault. Mit dem Aufkommen von Data Vault 2.0, das den Data Vault 1.0-Standard um Architektur– und Prozessdefinitionen erweitert, hat Dan Linstedt die in der Modellierung genutzten Symbole standardisiert. Auf Basis dieser standardisierten Symbole wurde die Modellierungssprache Visual Data Vault (VDV) entwickelt, die EDW-Architekten beim Aufbau von Data-Vault-Modellen unterstützt.

Als unsere Gründer ihr Buch schrieben, benötigten sie einen visuellen Ansatz, um die Konzepte von Data Vault verständlich zu modellieren. Zu diesem Zweck entwickelten sie eine grafische Modellierungssprache, die sich auf die logischen Aspekte von Data Vault konzentriert. Die passenden Microsoft-Visio-Schablonen und ein detailliertes Whitepaper stehen auf www.visualdatavault.com zum kostenlosen Download bereit.

Links in Visual Data Vault

In einem früheren Beitrag haben wir bereits gezeigt, wie Hubs im Finanzbereich modelliert werden. In diesem Artikel erklären wir die Funktion von Standard-Links und wie die Modellierung speziell in der Bankenbranche funktioniert.

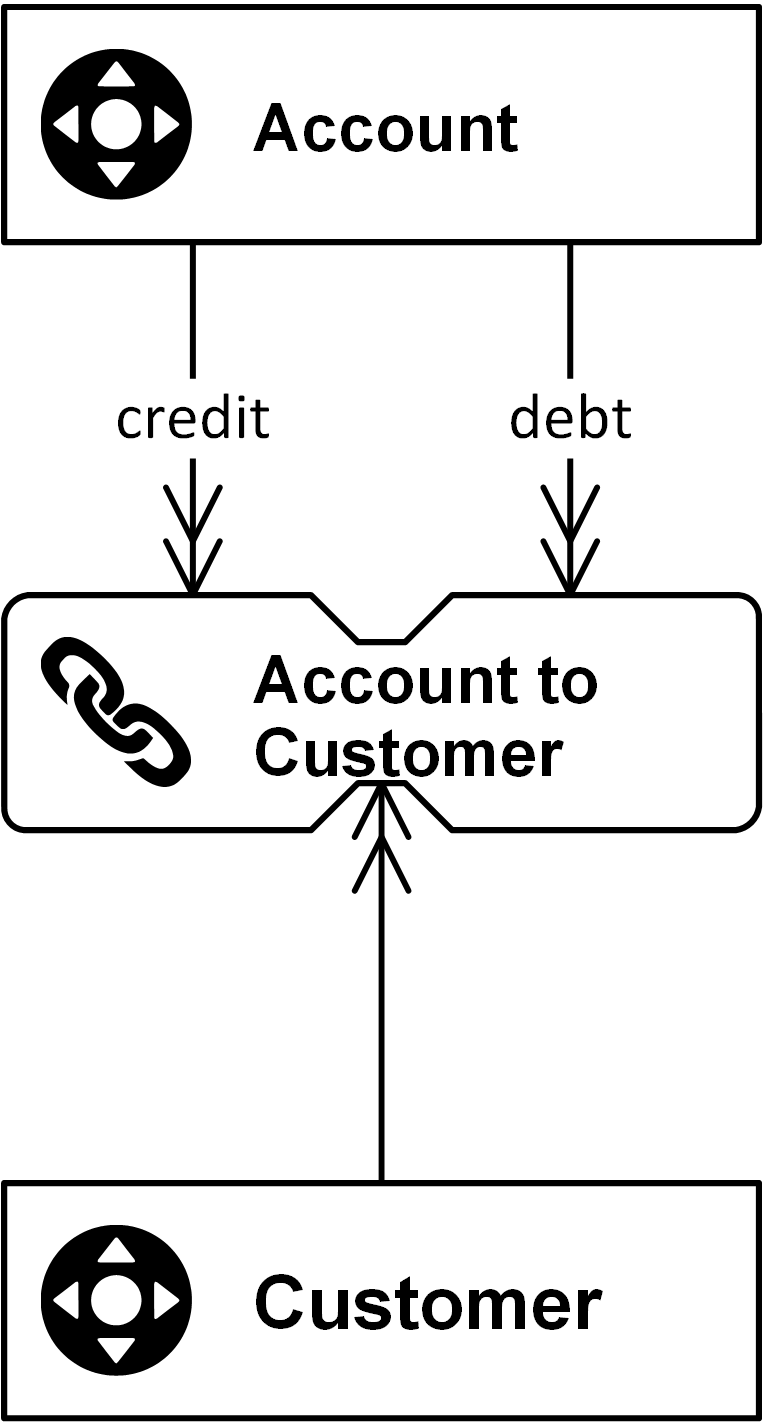
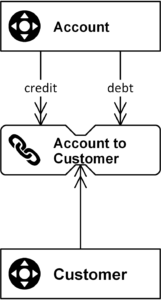
Links verbinden einzelne Hubs in einem Data-Vault-Modell und repräsentieren entweder Transaktionen oder Beziehungen zwischen Business-Objects. Im laufenden Geschäftsbetrieb sind Business-Objects stets miteinander verknüpft – kein Business-Object existiert völlig isoliert von anderen. Stattdessen werden sie durch die operativen Geschäftsprozesse miteinander verbunden, welche diese Objekte bei der Ausführung ihrer Aufgaben nutzen. Das folgende Diagramm veranschaulicht einen Link, der zwei Hubs miteinander verbindet (ein Standard-Link erfordert mindestens zwei Verbindungen):

Figure 1: A standard link connects two hubs

Der Link im obigen Beispiel referenziert zwei Hubs: Account und Customer. Die Verbindungslinie (der Pfeil) ist zu lesen als: „(Der Hub) Customer wird verwendet von (dem Link) Account to Customer“. Die zweite Referenz unterscheidet sich leicht, da der Name der Verbindung zwischen dem Account-Hub und dem Link durch die fachliche Rolle eines Kredit- oder Debitoren-Accounts überschrieben wird. Dies ist immer dann erforderlich, wenn das Modell eine präzisere fachliche Semantik benötigt oder wenn mehrere Verbindungen zum selben Hub bestehen. Die Hash-Keys jedes Hubs, die jedes Business-Object über ein berechnetes Attribut eindeutig identifizieren, werden unter Verwendung desselben Attributnamens in die Link-Entität repliziert.

Ein Link bildet n:m-Beziehungen (Many-to-Many) ab und bietet dadurch eine hohe Flexibilität: Änderungen an den Business-Rules erfordern kein aufwendiges Re-Engineering, und die Granularität wird durch die Anzahl der referenzierten Hubs klar ausgedrückt und transparent dokumentiert.

Link table example
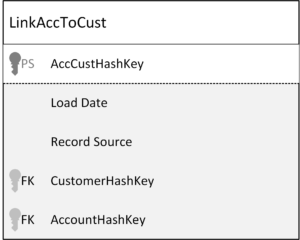
Figure 2: Link table with its attributes

Der Link enthält alle Hash-Keys der zugehörigen Hubs (als logische Fremdschlüssel), ein Load Date (das den ersten Eingang der Beziehung im Data Warehouse dokumentiert), die Record Source der Daten sowie den Link-Hash-Key (als logischen Primärschlüssel). Letzterer wird aus den Business-Keys der Hubs berechnet – nicht aus den Hash-Keys, denn: Hashen Sie niemals einen Hash! Zudem folgt die Beladung einem reinen Insert-only-Muster.

Links erhöhen die Flexibilität des Data-Vault-Modells erheblich, da sich neue Links leicht hinzufügen und bestehende Beziehungstypen mühelos anpassen lassen. Dadurch verkürzt sich die Reaktionszeit auf geschäftliche Veränderungen spürbar. Um neue Funktionalitäten zu ergänzen, fügen Sie lediglich neue Hubs hinzu und verbinden diese über Links mit den bestehenden Strukturen. In der Regel wird dem Link ein Standard-Satellite angehängt, der die beschreibenden Daten der Beziehung enthält.

Eine weitere verbreitete Form ist der Non-Historized Link (auch als Transactional Link bekannt). Dieser speichert ausschließlich Transaktionsdaten, benötigt keinen Satellite und folgt strikt einem Insert-only-Lademuster. Weitere Details zum Mehrwert von NH-Links finden Sie in einem unserer früheren Beiträge aus diesem Jahr.

Fazit

Die Modellierungssprache Visual Data Vault bietet einen standardisierten und hocheffizienten Ansatz zur Abbildung komplexer Beziehungen und Transaktionen in der Bankenbranche. Durch die gezielte Verknüpfung von Business-Objects über Links entsteht eine klare, logische Struktur, die reale Geschäftsprozesse präzise abbildet. Diese Methodik steigert nicht nur die Transparenz von Datenmodellen, sondern vereinfacht auch das Datenmanagement sowie spätere Datenabfragen nachhaltig was sie zu einem unverzichtbaren Werkzeug für Enterprise Data Warehouse-Architekten macht.

Data Lineage in Data Vault 2.0 erreichen

Eine häufige Anforderung in Data-Warehouse-Projekten besteht darin, eine lückenlose End-to-End-Data-Lineage bereitzustellen. Individuelle Einzellösungen (wie beispielsweise spezifische Meta-Marts für selbst entwickelte Data-Vault-Generatoren) oder Tools verschiedener Anbieter unterbrechen diesen durchgängigen Nachweis jedoch häufig.

Im Gegensatz zu fachlichen oder technischen Metadaten, die vom Fachbereich oder den Quellanwendungen bereitgestellt werden, generiert das Data-Warehouse-Team Metadaten zur Prozessausführung (Process Execution Metadata). Diese liefern wertvolle Einblicke in die ETL-Verarbeitung zu Wartungszwecken. Sie werden vom Data-Warehouse-Team oder von Endanwendern genutzt, um die Data-Warehouse-Performance und die in den Information-Marts dargestellten Ergebnisse besser zu verstehen. Eine Unterart dieser Prozessmetadaten sind Control-Flow-Metadaten, die unter anderem Datenflüsse steuern und ausführen. Die Protokollierung der Prozessausführung ist ein unverzichtbares Werkzeug zur Wartung und Fehlerbehebung (Debugging) der ETL-Prozesse, da sie präzise Informationen über die Data Lineage aller Elemente des Data Warehouses liefert. Continue Reading

Data-Vault-Modellierung: Visuelles Beispiel – Scalefree

Data Vault Modeling of a Hub

Visuelles Beispiel einer Data-Vault-Modellierung

Durch die Ergänzung von Architektur- und Prozessdefinitionen in Data Vault 2.0 hat Dan Linstedt die Data-Vault-Modellierung standardisiert.

Basierend auf diesen standardisierten Symbolen wurde die Visual-Data-Vault-Modellierungssprache entwickelt, die Enterprise-Data-Warehouse-Architekten zur Erstellung von Data-Vault-Modellen nutzen können.

Die Autoren des Buches „Building a Scalable Data Warehouse“, die auch die Gründer von Scalefree sind, benötigten einen visuellen Ansatz, um die Data-Vault-Konzepte im Buch darzustellen.

Zu diesem Zweck entwickelten sie die grafische Data-Vault-Modellierungssprache, die sich auf die logischen Aspekte von Data Vault konzentriert.

Die Microsoft-Visio-Stencils und ein detailliertes Whitepaper stehen auf www.visualdatavault.com zum kostenlosen Download zur Verfügung.

Hubs in Visual Data Vault

Business-Keys spielen in jedem Unternehmen eine wichtige Rolle, da Geschäftstransaktionen und Beziehungen zwischen Geschäftsobjekten auf sie verweisen.

Immer wenn ein Unternehmen Geschäftsobjekte identifiziert und nachverfolgt, kommen Business-Keys in allen Geschäftsprozessen zum Einsatz.

Dies ist einer der Gründe, warum Data Vault auf den Business-Keys basiert. In der Data-Vault-Modellierung werden Business-Keys in Hub-Entitäten gespeichert.

Die Herausforderung besteht darin, die Business-Keys zu identifizieren, die ein Geschäftsobjekt eindeutig repräsentieren. Das kann ein einzelner Business-Key sein, aber auch ein Composite-Key oder ein Smart-Key.

Die erste Abbildung zeigt einen Hub mit nur einem Business-Key-Attribut:

Data Vault Modeling of a Hub

Hier reicht das Attribut „Invoice Number“ aus, um die Rechnung zu identifizieren. Es ist kein weiteres Attribut erforderlich (wie beispielsweise das Rechnungsjahr).

In anderen Fällen ist es nicht so einfach, wie das folgende Diagramm zeigt:

Data Vault Modeling for a Hub

In diesem Data-Vault-Modellierungsfall wird der Buchhalter durch ein „Country Code“-Attribut (wie den ISO2-Code) und ein „Employee Number“-Attribut identifiziert.

Ein Attribut allein würde nicht ausreichen, um den Buchhalter zu identifizieren: Die „Employee Number“ an sich könnte sich länderübergreifend überschneiden und nur eine lokale Bedeutung haben (die „Employee Number“ 10006 könnte in mehreren Ländern verwendet werden und in jedem Land einen anderen Buchhalter identifizieren).

Daher wird der lokale Schlüssel um den „Country Code“ erweitert, um den Buchhalter eindeutig zu identifizieren. Bitte beachten Sie, dass der „Country Code“ in den Quelldaten enthalten sein muss, damit dies ein gültiges Modell in Data Vault ist (letztendlich modellieren wir Quelldaten im Raw Data Vault, nicht das Zielmodell des Fachbereichs).

Ein weiteres Beispiel erweitert dieses Konzept zu einem sogenannten Smart-Key:

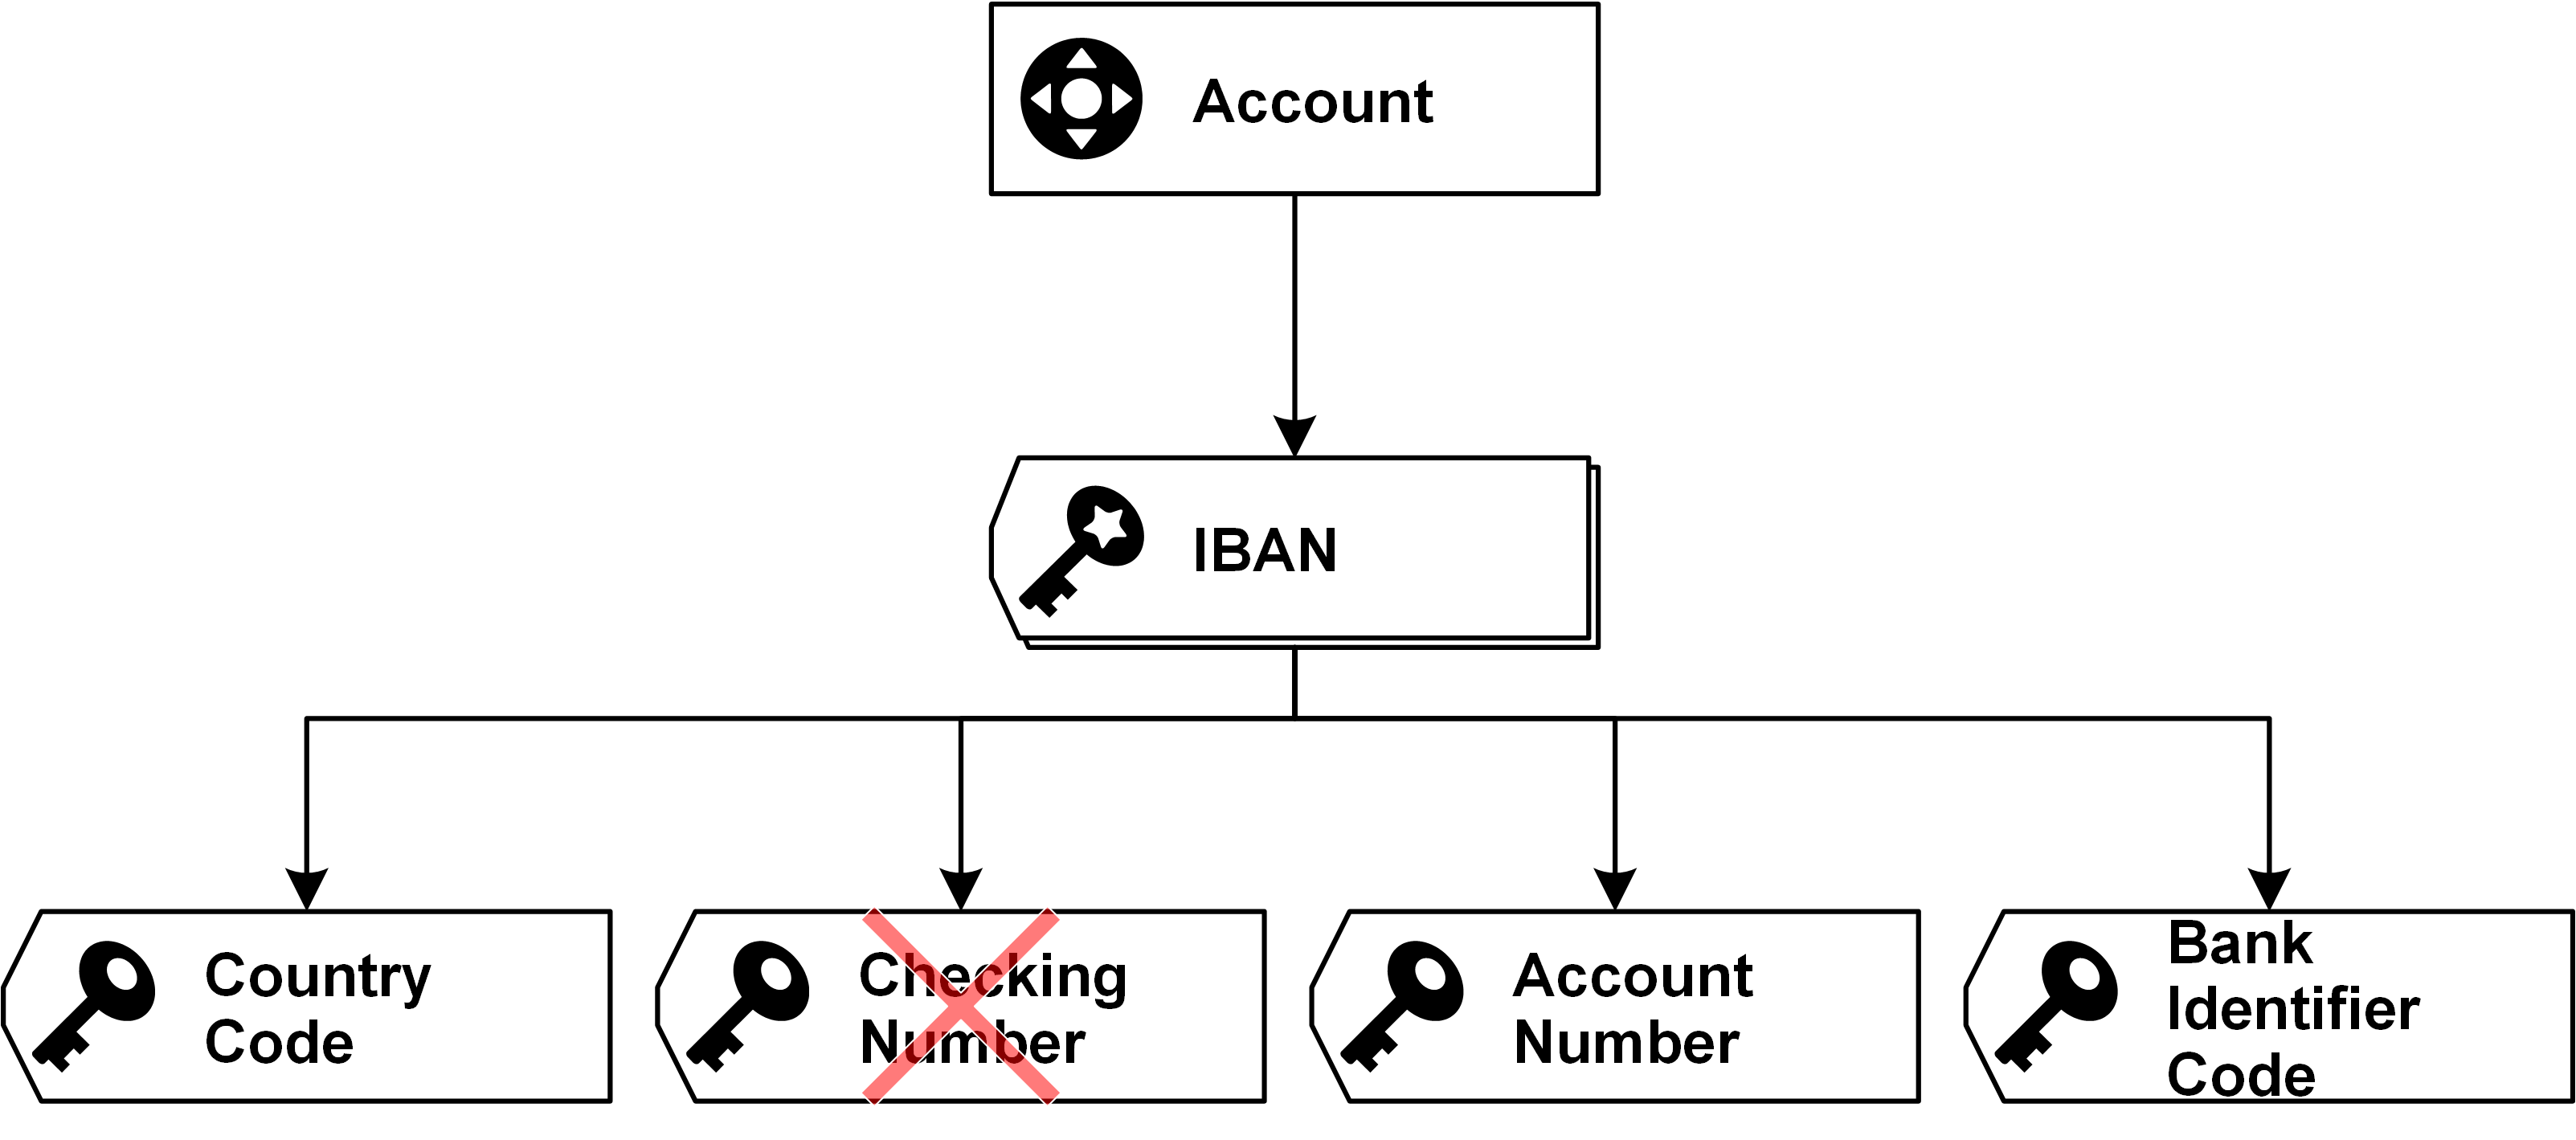
Data Vault Modeling of a Hub

Hier besteht die IBAN, die zur internationalen Identifizierung von Bankkonten dient, aus vier physischen Elementen:

  1. Country Code
  2. Checking number
  3. Account number
  4. Bank Identifier code

Um einen Smart-Key zu modellieren (einen Schlüssel, der aus mehreren Teilen oder Schlüsseln besteht), fügen Sie dem Hub einen Smart-Key und anschließend Business-Keys hinzu, um die einzelnen Segmente des Smart-Keys zu identifizieren.

Wie Sie in der obigen Abbildung sehen können, ähnelt das logische Symbol eines Smart-Keys dem eines Business-Keys. Die Symbole unterscheiden sich jedoch geringfügig, und die Form deutet auf einen Stapel hin.

In diesem Data-Vault-Modellierungsbeispiel wird jeder Business-Key als einzelnes Attribut in der Hub-Entität modelliert. Die Kombination identifiziert ein Geschäftsobjekt im Unternehmen. Die „Checking Number“ wird eigentlich nicht modelliert, da sie keinen geschäftlichen Nutzen hat (außer der Funktion als technische Prüfsumme).

Es ist jedoch nicht falsch, wenn Sie diese ebenfalls dem Modell hinzufügen.

Hash Keys in Data Vault

Hash Keys in Data Vault 2.0 for MPP

Hash-Keys in DV 2.0Hash Keys in DV2.0

Data Vault 2.0 führt Hash-Keys ein, um das traditionelle Data-Vault-Modell zu erweitern, was dem Data Warehousing mehrere Vorteile bringt. Hash-Keys beschleunigen nicht nur den Ladeprozess; sie stellen auch sicher, dass sich das Enterprise Data Warehouse über mehrere Umgebungen erstrecken kann: On-Premises-Datenbanken, Hadoop-Cluster und Cloud-Speicher.

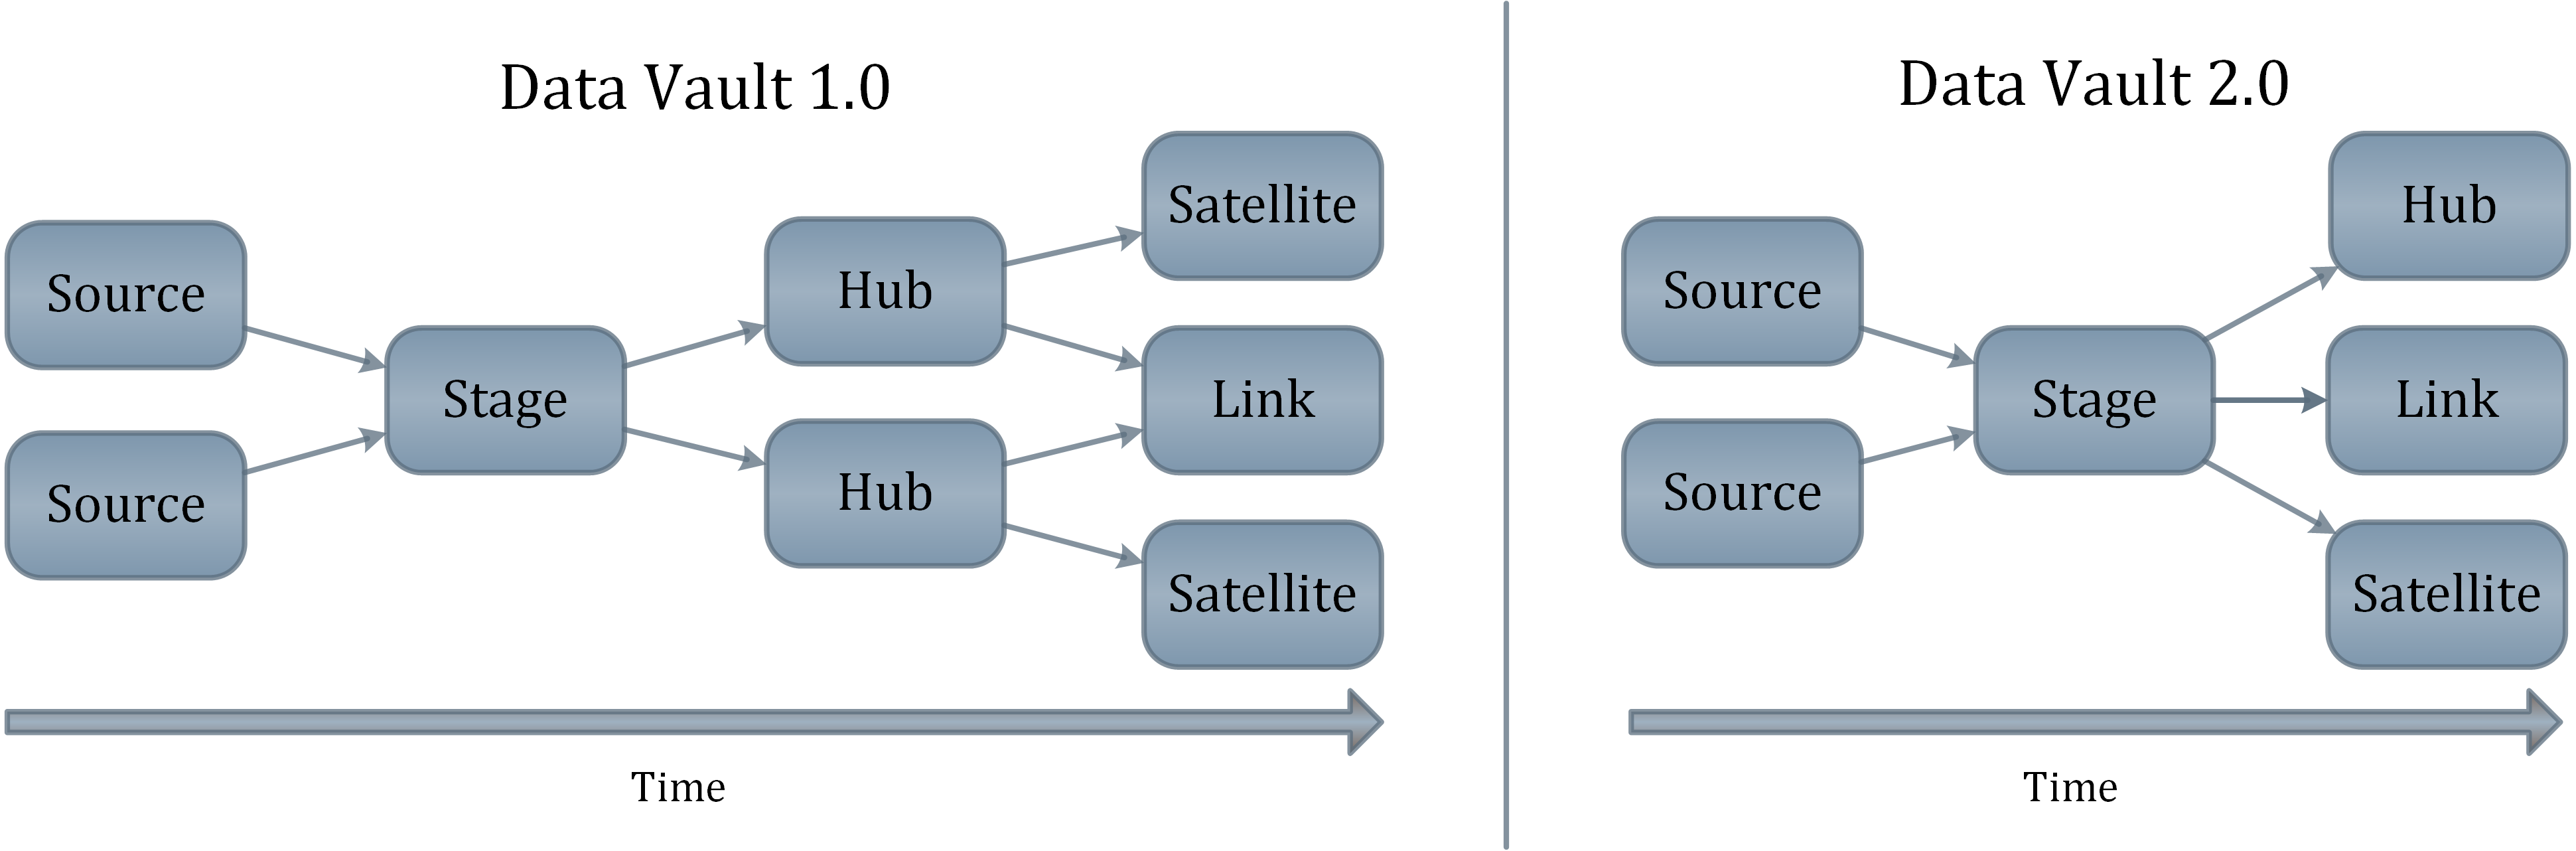
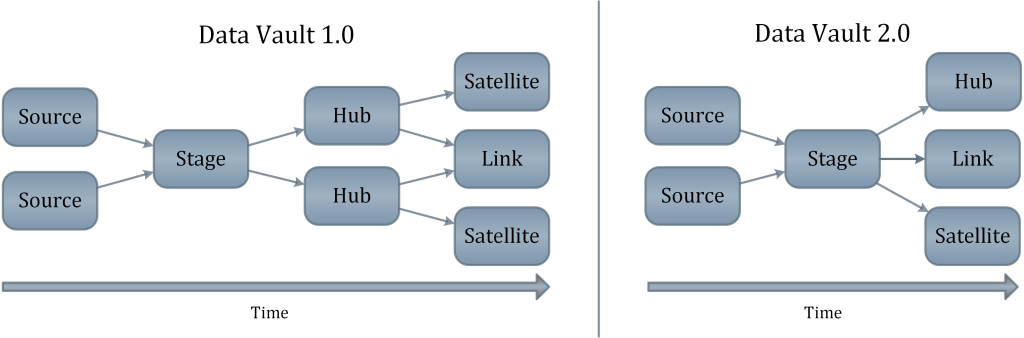
Lassen Sie uns zuerst über den Performance-Gewinn sprechen: Um die Ladevorgänge zu beschleunigen, müssen Abhängigkeiten im Ladeprozess minimiert oder sogar eliminiert werden. In Data Vault 1.0 wurden Sequenznummern verwendet, um eine Business-Entity zu identifizieren, was folglich zu Abhängigkeiten während des Ladeprozesses führte.

Diese Abhängigkeiten haben den Ladeprozess verlangsamt, was insbesondere bei Echtzeit-Feeds ein Problem darstellt. Hubs mussten zuerst geladen werden, bevor der Ladeprozess von Satellites und Links starten konnte. Das Ziel ist es, diese Abhängigkeiten aufzubrechen, indem Hash-Keys anstelle von Sequenznummern als Primärschlüssel verwendet werden.

Business-Keys vs. Hash-Keys

Vorab: Business-Keys können eine von einem einzelnen Quellsystem erstellte Sequenznummer sein, z. B. die Kundennummer.

Business-Keys können jedoch auch ein zusammengesetzter Schlüssel sein, um eine Business-Entity eindeutig zu identifizieren – beispielsweise wird ein Flug in der Luftfahrtindustrie durch die Flugnummer und das Datum identifiziert, da die Flugnummer jeden Tag wiederverwendet wird.

Allgemein gilt: Ein Business-Key ist der natürliche Schlüssel, der vom Fachbereich verwendet wird, um ein Business-Object zu identifizieren.

Die Verwendung von Business-Keys im Data Vault ist zwar eine Option, aber eine langsame, die viel Speicherplatz beansprucht (sogar mehr als Hash-Keys).

Insbesondere in Links und den davon abhängigen Satellites sind viele zusammengesetzte Business-Keys erforderlich, um die Beziehung oder Transaktion bzw. das Ereignis in einem Link zu identifizieren – und im Satellite zu beschreiben.

Dies würde viel Speicherplatz erfordern und den Ladeprozess verlangsamen, da nicht alle Datenbank-Engines in der Lage sind, effiziente Joins über Business-Keys mit variabler Länge auszuführen.

Andererseits hätten wir zu viele Spalten im Link, da jeder Business-Key ein Teil des Links sein muss.

Das Problem dabei ist, dass in den Links auch unterschiedliche Datentypen mit verschiedenen Längen vorliegen. Dieses Problem verschärft sich noch, da es auch erforderlich ist, die Business-Keys in die zugehörigen Satellites zu replizieren.

Um eine konsistente Join-Performance zu garantieren, besteht die Lösung darin, die Business-Keys mithilfe von Hash-Funktionen zu einem einzigen Spaltenwert zu kombinieren, um eine eindeutige Repräsentation eines Business-Objects zu berechnen.

Massively Parallel Processing (MPP)

Da die Ladeprozesse von Hubs, Links und Satellites voneinander unabhängig sind, können diese vollständig parallel ausgeführt werden.

Hash Keys in Data Vault 2.0 for MPP

Die Idee basiert auf der Tatsache, dass ein Hash-Key von einem Business-Key oder einer Kombination von Business-Keys abgeleitet wird, ohne dass eine Abfrage (Lookup) in der übergeordneten Tabelle erforderlich ist.

Anstatt also die Sequenz eines Business-Keys in einem Hub nachzuschlagen, bevor der Business-Key im Satellite beschrieben wird, lässt sich einfach der Hash-Key des Business-Keys berechnen.

Die korrekte Implementierung der Hash-Funktion stellt sicher, dass derselbe semantische Business-Key zu exakt demselben Hash-Key führt, unabhängig von der geladenen Ziel-Entity.

Hash-Keys zur Verknüpfung von Apache™ Hadoop®-Datensätzen

Ohne Hashing erfordert das Laden in Hadoop® oder NoSQL eine Abfrage (Lookup) der Hub- oder Link-Sequenz im relationalen System, bevor die Daten eingefügt oder angehängt werden können.

Hashing anstelle von Sequenzierung bedeutet, dass Ladevorgänge in alle Hubs, Links und Satellites in absolut zu 100 % parallelen Operationen erfolgen können. Gleichzeitig lassen sich alle Hadoop®- oder NoSQL-basierten Dokumente parallel anreichern.

Dies ermöglicht es dann auch, plattformübergreifende Joins über mehrere heterogene Plattformen hinweg durchzuführen – beispielsweise von einer Teradata-Datenbank zu Apache™ Hadoop®.

Hash-Difference

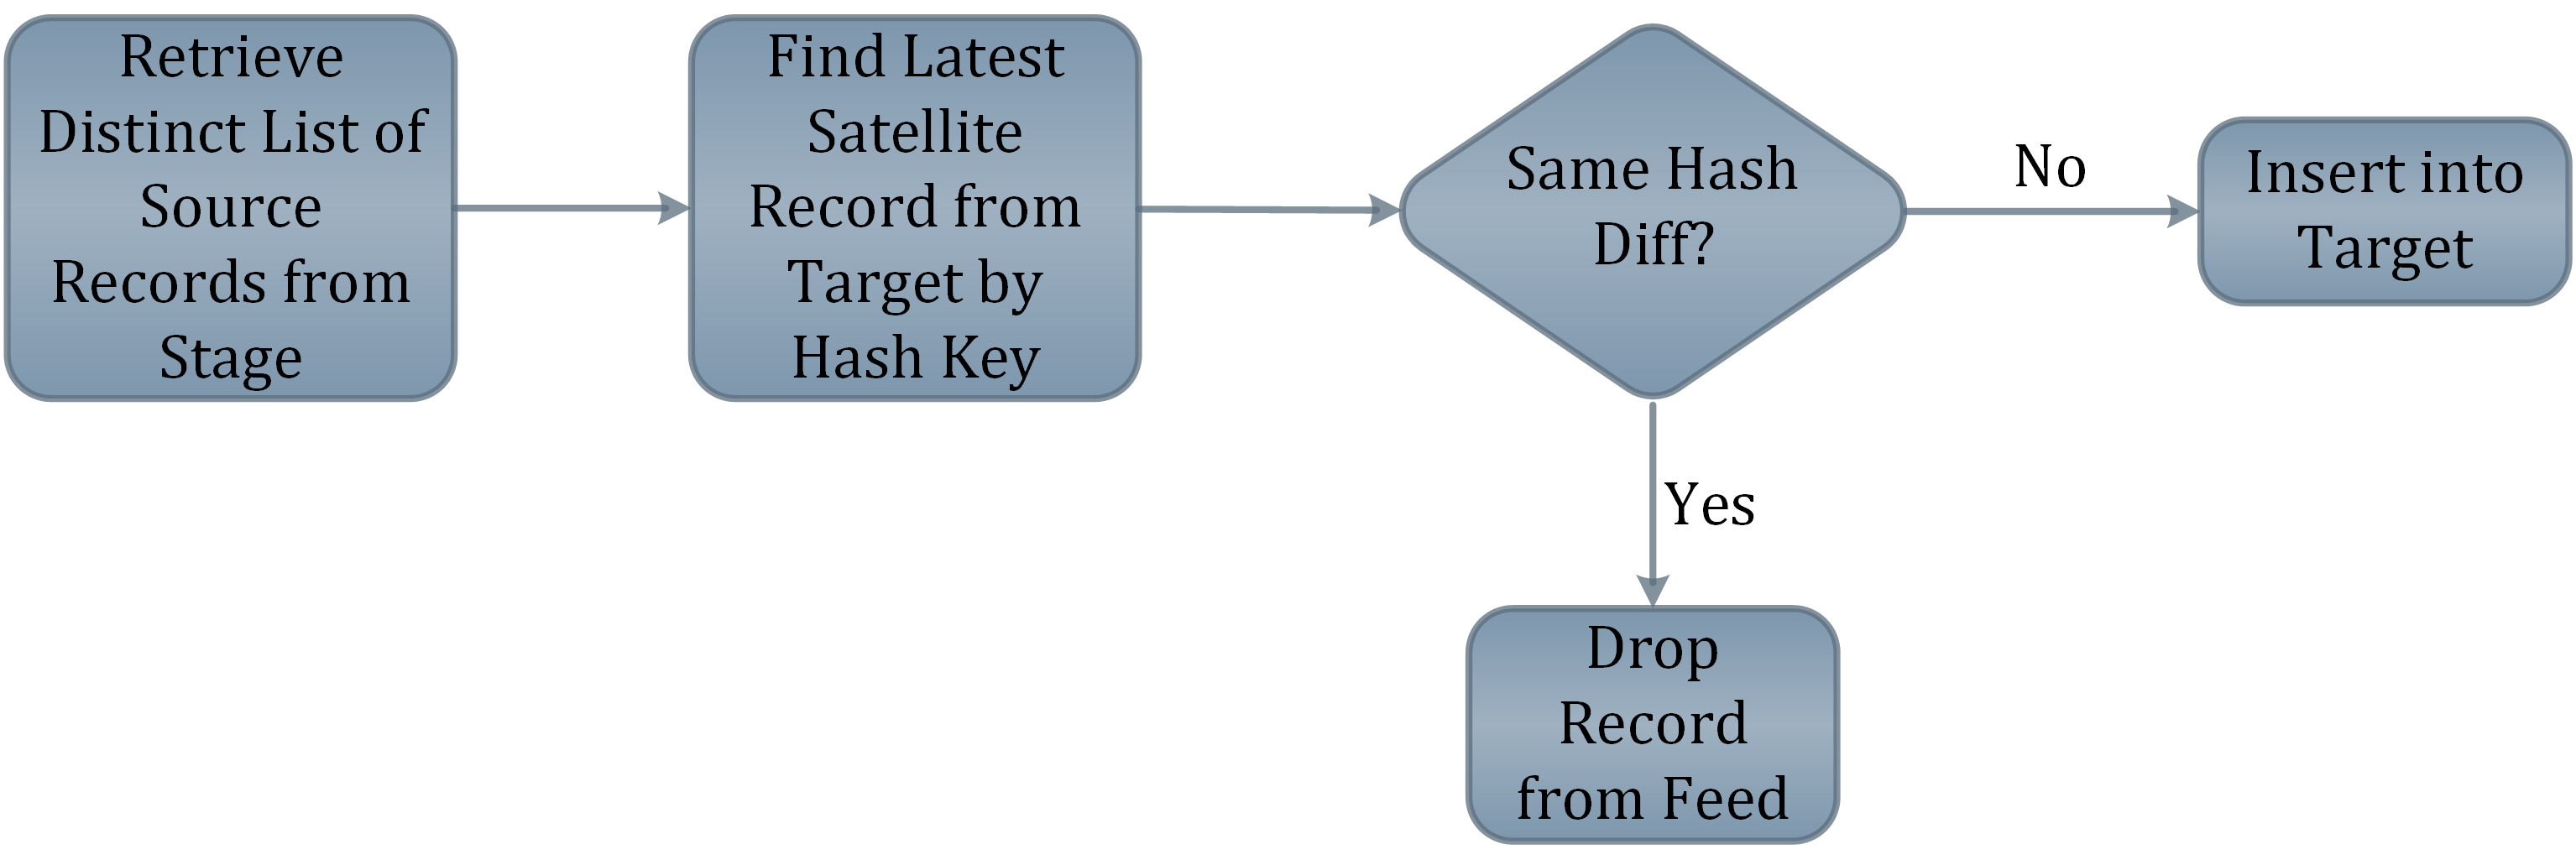
Die Hash-Difference-Spalte wird auf die Satellites angewendet. Der Ansatz ist derselbe wie bei den Business-Keys, nur dass hier alle beschreibenden Daten gehasht werden.

Das reduziert den Aufwand während eines Ladeprozesses, da nur eine einzige Spalte nachgeschlagen werden muss. Der Satellite-Ladeprozess prüft zuerst, ob der Hash-Key bereits im Satellite vorhanden ist, und zweitens, ob es Unterschiede zwischen den Hash-Difference-Werten gibt.

Die obige Abbildung zeigt den Prozess, wenn das Quellsystem Ihnen eine vollständige Datenlieferung sendet.

Der Zeitpunkt, an dem die Werte gehasht werden, sollte auf dem Weg in die Staging-Area liegen, da zu diesem Zeitpunkt genügend Zeit vorhanden ist, um auf Hash-Kollisionen zu prüfen und Hashing-Probleme zu behandeln, bevor die Daten in den Data Vault geladen werden.

Welche Hash-Funktion sollte verwendet werden?

Es stehen viele Hash-Funktionen zur Auswahl: MD5, MD6, SHA-1, SHA-2 und einige mehr.

Wir empfehlen in den meisten Fällen die Verwendung des MD5-Algorithmus mit einer Länge von 128 Bit, da dieser auf den meisten Plattformen allgegenwärtig verfügbar ist und eine angemessen geringe Wahrscheinlichkeit für eine Hash-Kollision bei akzeptablem Speicherplatzbedarf aufweist.

Ein zusätzlicher Vorteil des Hashings besteht darin, dass die Hashes dieselbe Länge haben und vom selben Datentyp sind, woraus sich eine Performance-Steigerung ergibt.

Darüber hinaus sind generierte Hash-Werte deterministisch, sodass sie nie verloren gehen und sich jederzeit reproduzieren lassen.

Kollisionen

Hashing birgt ein sehr geringes Risiko: die Kollision. Das bedeutet, dass zwei unterschiedliche Datenwerte denselben Hash-Wert erhalten.

Dieses Risiko ist jedoch extrem gering. Ein Beispiel: In einer Datenbank mit mehr als einer Billion Hash-Werten ist die Wahrscheinlichkeit, dass Sie eine Kollision erhalten, in etwa so hoch wie die Wahrscheinlichkeit, dass ein Meteorit auf Ihrem Rechenzentrum einschlägt.

Zusammenfassung

Hash-Keys sind im Data Vault nicht zwingend erforderlich, werden aber dringend empfohlen. Die Vorteile von

  • Massively Parallel Processing (MPP),
  • Data-Load-Performance,
  • Konsistenz und
  • Auditierbarkeit

sind unverzichtbar und können mit Sequenzen oder Business-Keys nicht erreicht werden.

Hash-Keys sind kein Allheilmittel… aber sie bieten weitaus mehr Vorteile, als sie Nachteile (wie erhöhten Speicherplatzbedarf) mit sich bringen.

Der Wert von Non-Historized Links

So verwenden Sie Non-Historized Links

Non-Historized Links in Data Vault 2.0

Non-Historized Links in Data Vault 2.0 vereinfachen die Datenmodellierung, indem sie sich auf aktuelle Beziehungen konzentrieren statt auf historische Änderungen. Dies verbessert die Effizienz, reduziert die Komplexität und steigert die Abfrageleistung für agilere Analysen.

Einführung in Non-Historized Links

Non-Historized Links, auch als Transaction Links bekannt, sind ein wesentlicher Bestandteil des Data Vault 2.0 Frameworks – aber wie funktionieren sie innerhalb eines Modells? Als Dan Linstedt, Mitgründer von Scalefree, den Data Vault erfand, verfolgte er mehrere Ziele. Eines davon war es, Daten so schnell wie möglich aus der Quelle in ein Data Warehouse Modell zu laden, sie in Informationen umzuwandeln und dem Business Analysten in jeder gewünschten Zielstruktur bereitzustellen.

Für die Data Warehouse Automatisierung und Einfachheit besteht das Data Vault 2.0 Modell aus nur drei grundlegenden Entitätstypen:

  1. Hubs: eine eindeutige Liste von Business Keys
  2. Links: eine eindeutige Liste von Beziehungen zwischen Business Keys
  3. Satellites: beschreibende Daten, die das übergeordnete Element (Business Key oder Beziehung) aus einem bestimmten Kontext heraus beschreiben, versioniert über die Zeit.

Wie wir immer lehren (und manchmal predigen): Sie können alle Unternehmensdaten allein mit diesen drei Entitätstypen modellieren. Ein Modell, das jedoch nur diese Entitätstypen verwendet, hätte mehrere Nachteile: viele komplexe Joins, hoher Speicherverbrauch, eingeschränkte Ladeleistung und verpasste Möglichkeiten zur Virtualisierung.

Die Lösung? Das Hinzufügen weiterer Bausteine zu den Kernentitätstypen des Data Vault, um diese Probleme zu bewältigen. Einer dieser Bausteine ist die Verwendung von Non-Historized Links, auch als Transaction Links bekannt:

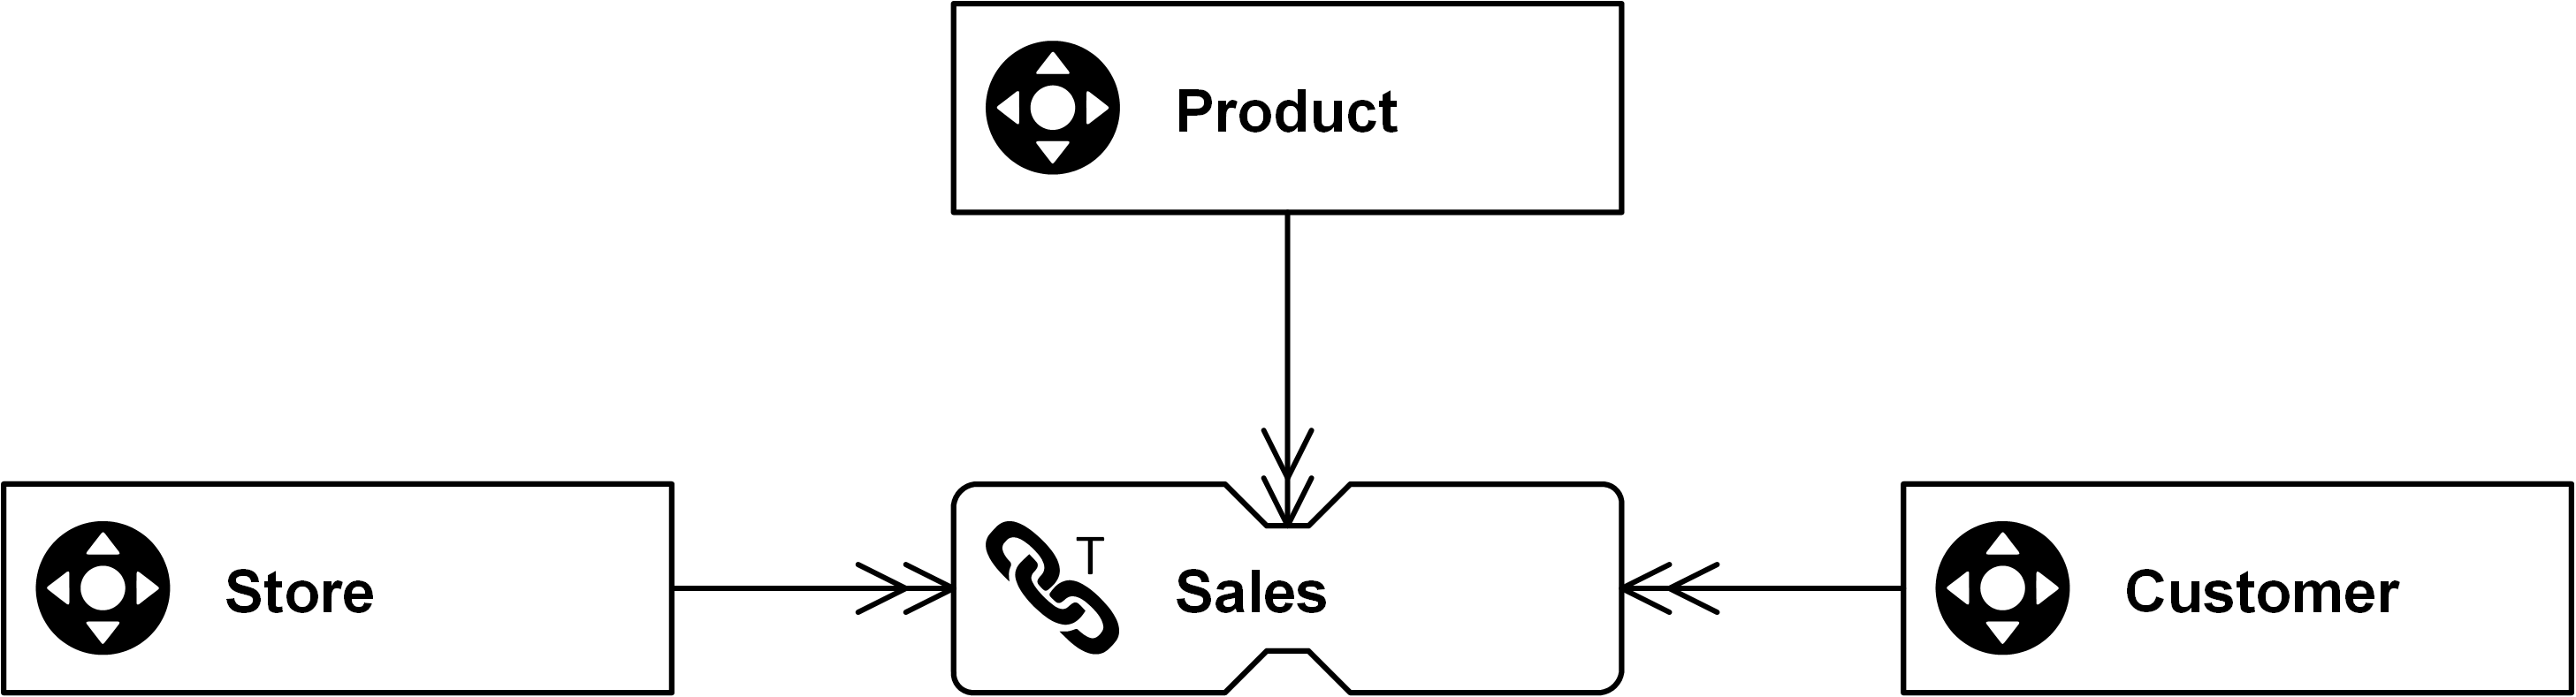
Sales - Non-historized Links

In diesem Beispiel können Verkäufe mit Non-Historized Links modelliert werden, die Verkaufstransaktionen eines Kunden in Bezug auf ein Geschäft erfassen. Das Ziel des Non-Historized Links ist es, eine hohe Performance sowohl beim Laden in als auch beim Auslesen aus dem Data Warehouse sicherzustellen. Vergessen Sie nicht: Das ultimative Ziel des Data Warehousing ist es, ein Data Warehouse zu bauen – nicht nur zu modellieren. Und der Aufbau eines Data Warehouse umfasst weit mehr als nur das Modell: Es erfordert Menschen, Prozesse und Technologie.

Wesentliche Merkmale von Non-Historized Links

Wie erfüllen Non-Historized Links diese Ziele? Denken Sie an Ihre Business Analysten. Was sind ihre Ziele? Ehrlich gesagt interessiert sie das Data Vault Modell am Ende nicht direkt. Stattdessen möchten sie dimensionale Modelle sehen – Star Schemas, Snowflake Schemas oder flache, breite Modelle für Data Mining. Oder gelegentlich möchten sie die unübersichtlichen Tabellen aus dem Mainframe sehen, manchmal verknüpft, manchmal nicht – und nicht mehr viele Menschen verstehen die Beziehungen noch vollständig… aber für die Abwärtskompatibilität ist das hervorragend.

Nachdem das Ziel definiert wurde, stellt sich die nächste Frage: Was ist die Zielgranularität? In einem dimensionalen Modell spiegelt die Zielgranularität von Faktentabellen beispielsweise häufig die zu analysierenden Transaktionen wider – denken Sie an Anrufaufzeichnungen in der Telekommunikationsbranche oder Banktransaktionen.

Interessanterweise ist diese gewünschte Zielgranularität häufig direkt in den Quellsystemen zu finden. Ein Telekommunikationsanbieter verfügt über ein operatives System, das jeden Telefonanruf aufzeichnet. Oder eine Bankanwendung, die jede Kontotransaktion erfasst. Diese Datensätze werden in der Regel ohne Aggregation in das Data Warehouse geladen – im Data Vault arbeiten wir auf der feinsten Granularität für Prüf- und Lieferzwecke.

Und hier liegt das Problem mit den Standard-Data Vault Entitätstypen. Obwohl sie sehr einfach und musterbasiert sind, haben sie ein Problem: Der Standard-Link speichert eine eindeutige Liste von Beziehungen. Das bedeutet, dass der Link nur an Beziehungen aus der Quelle interessiert ist, die dem Ziel-Link unbekannt sind. Wenn ein Kunde mehrmals in ein Geschäft geht und dasselbe Produkt kauft, ist die Beziehung zwischen Kunde, Geschäft und Produkt bereits bekannt – es wird kein weiterer Link-Eintrag hinzugefügt.

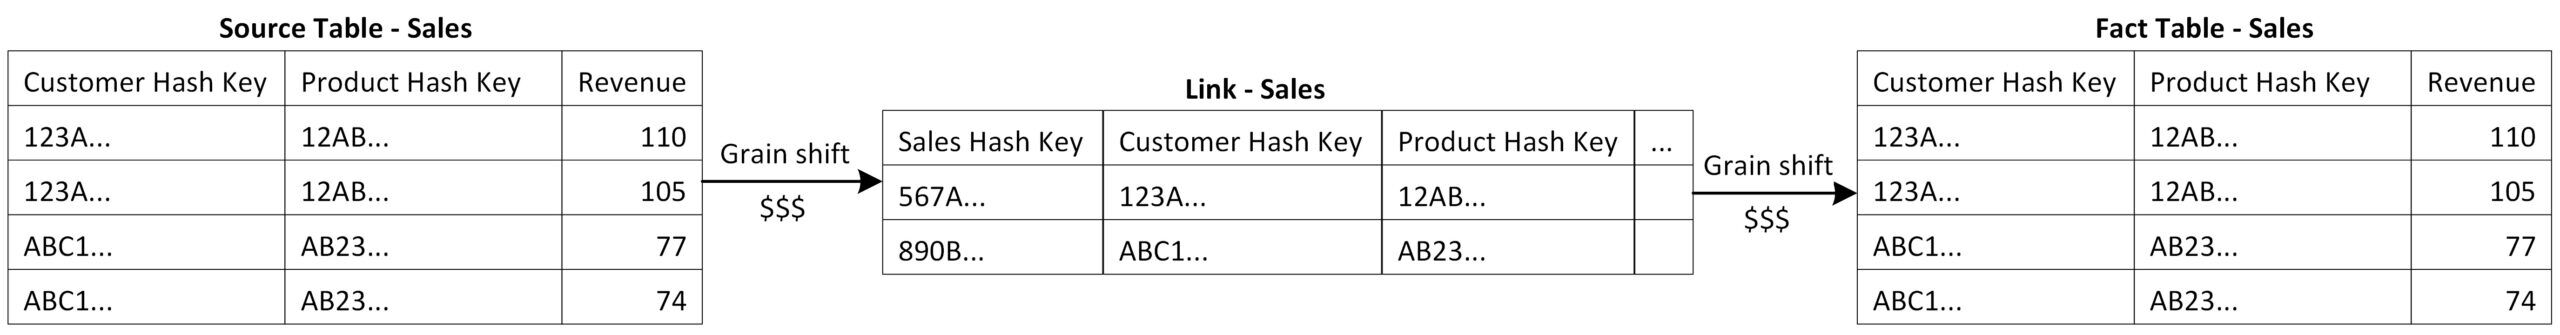
Infolgedessen wird die Granularität der eingehenden Daten beim Laden des Ziel-Links verändert. Wenn die dem Vorgang zugrunde liegende Beziehung bereits bekannt ist, wird die Transaktion ausgelassen – und stattdessen von einem Satellite erfasst.

Das nächste Problem besteht darin, dass die Link-Granularität nun von der Zielgranularität abweicht, weil der Business Analyst einen Datensatz pro Transaktion und nicht pro eindeutiger Business Key-Beziehung wollte. Eine weitere Granularitätsverschiebung ist erforderlich, die typischerweise das Verknüpfen des Satellite des Links mit dem Link selbst beinhaltet, um die ursprüngliche Granularität wiederherzustellen.

Wie wir in unserem Buch „Building a Scalable Data Warehouse with Data Vault 2.0“ erläutert haben, ist eine Granularitätsverschiebung in Bezug auf die Performance relativ kostspielig. Dies liegt daran, dass der Vorgang aufwendige GROUP BY-Anweisungen oder LEFT und RIGHT JOINS erfordert.

Und wofür? Das Endergebnis beider Operationen entspricht oft der ursprünglichen Granularität aus dem Quellsystem. Zwei aufwendige Granularitätsverschiebungen für nichts – das klingt nach einem schlechten Tausch.

non-historized Links

Und genau das ist der Fall.

Hier kommen Non-Historized Links ins Spiel: Der Link ist eine einfache Variation des Standard-Links mit dem Ziel, die Quelltransaktionen und -ereignisse in der ursprünglichen Granularität zu erfassen.

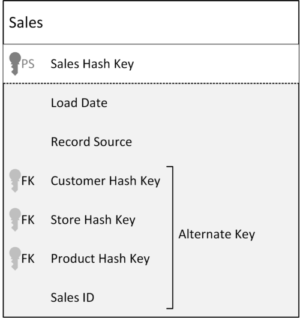
In einem Standard-Link wird die Granularität durch die Anzahl der Hub-Referenzen im Link definiert. Dies wäre nicht ausreichend, um mehrere Transaktionen zu erfassen, die dieselben Business Keys (z. B. denselben Kunden, dasselbe Geschäft und dasselbe Produkt) im selben Ziel-Link beinhalten. Um das Problem zu lösen, ist ein zusätzliches Element des alternativen Schlüssels in den Non-Historized Links erforderlich – typischerweise eine Transaktions- oder Ereignis-ID, wie die Anruf-ID oder eine Warenkorb-ID im Einzelhandel (die auch als eigener Hub modelliert werden kann). In Kombination mit den Hub-Referenzen sollte der kombinierte Business Key pro Transaktion eindeutig sein. Auf diese Weise können wir nun einen Datensatz im Ziel-Link pro Quelldatensatz aus dem operativen System erfassen.
How to use non-historized Links

Abbildung: Non-Historized Link mit der Verkaufs-ID als zusätzlichem Schlüssel

Ein tiefergehendes Szenario wäre, wenn dasselbe Produkt (in diesem Fall die höchste Granularität) zweimal in einem Verkauf vorkommt – beispielsweise aufgrund unterschiedlicher Rabatte. In diesem Fall wäre die Positionsnummer ein zusätzlicher Schlüssel (Dependent Child Key), um jeden Datensatz eindeutig zu machen.

Aus der Ladeperspektive wird der Aufnahmeprozess der eingehenden Daten erheblich verbessert, da keine Granularitätsverschiebung mehr erforderlich ist. Alle Daten werden direkt aus der Quelle in das Ziel geladen. Solange der Business Analyst genau auf dieser Granularität berichten möchte, ist es möglich, die Non-Historized Link-Tabelle in eine Faktentabelle umzustrukturieren, indem eine virtuelle SQL-Ansicht darüber gelegt wird.
Ein wesentlicher Punkt ist, dass Non-Historized Links keine Änderungen der beschreibenden Daten erlauben – das bedeutet, dass für die Fakten nie eine Historie erstellt wird (z. B. bei sensor- oder maschinenerzeugten Daten). Da sich die beschreibenden Daten nicht ändern können, müssen sie nicht in einem Satellite gespeichert werden, sondern werden direkt in den Non-Historized Links gehalten.

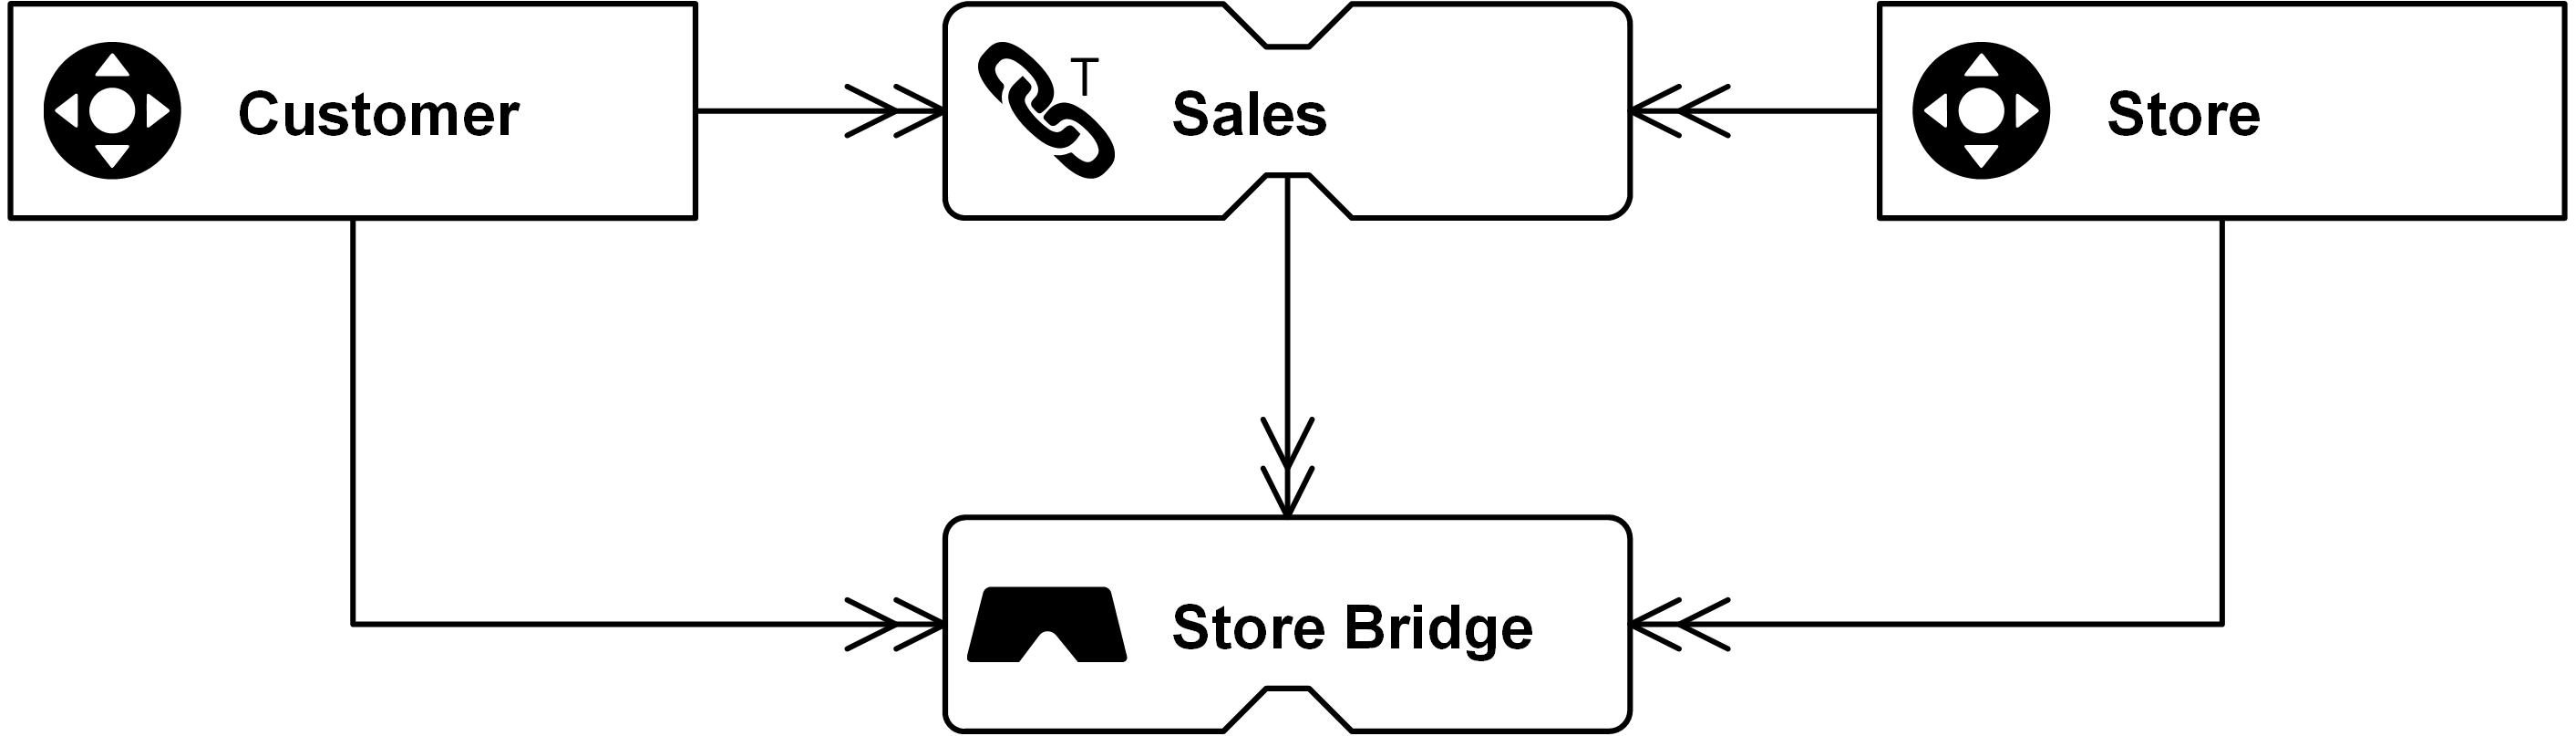
Aus Performance-Gründen sollten Granularitätsverschiebungen beim Auslesen vermieden werden. Wenn eine andere Zielgranularität erforderlich ist und es nicht möglich ist, diese Granularität aus dem Quellsystem oder aus dem Data Vault Modell zu laden, sollten Sie eine Bridge Table in Betracht ziehen. Der Zweck dieses Entitätstyps besteht darin, die Granularitätsverschiebung zu materialisieren und dabei den Vorteil zu behalten, das Ziel gemäß den individuellen Anforderungen des dimensionalen Ziels anzupassen.

So verwenden Sie Non-Historized Links

Abbildung: Virtuelle Bridge Table als Faktentabelle mit GROUP BY Store Hash Key

Fazit

Non-Historized Links bieten einen effizienten Ansatz zur Data Vault Modellierung, der die Performance optimiert und Datenstrukturen vereinfacht. Indem sie sich auf aktuelle Beziehungen statt auf historische Änderungen konzentrieren, steigern sie die Effizienz, reduzieren den Speicherbedarf und verbessern die Abfragegeschwindigkeit. Die Integration in Ihre Datenarchitektur kann zu einer agileren und skalierbareren Analyseumgebung führen.