Category

Wissen

Wird KI Ihren Data Vault Engineer ersetzen? Wir haben Conversational Analytics auf den Prüfstand gestellt

AI Fact Table Comparison

Scalefree hat untersucht, ob KI einen Data Vault Engineer ersetzen kann. Die Genauigkeit war perfekt, doch Aufwand und Leistungslücke erzählten eine andere Geschichte.

Jedes Datenteam stellt sich derzeit die gleiche Frage: Wenn KI SQL schreiben, Dokumentationen erstellen und komplexe Strukturen eigenständig abfragen kann – welche Aufgaben bleiben dann eigentlich noch für den Data Engineer?

Kann ein KI-Agent ein Raw Data Vault selbständig abfragen? Benötigt ein Unternehmen noch erfahrene Engineers, um ein Vault zu modellieren, zu dokumentieren und zu pflegen, wenn die KI dies theoretisch selbst ermitteln könnte? Wir haben das Experiment durchgeführt. Die Ergebnisse waren unerwartet.

Conversational Analytics meistern: Ein praktischer Leitfaden für Einrichtung, Test und Optimierung

Erfahren Sie, wie Sie mit den Daten Ihres Unternehmens in Alltagssprache kommunizieren und präzise, sofortige Antworten auf Basis Ihrer individuellen Kennzahlen erhalten. Dieses praxisorientierte Webinar zeigt Ihnen eine Strategie, mit der Sie KI-Halluzinationen vermeiden und zuverlässige KI-Datenassistenten implementieren – ohne umfassende, kostspielige Umstrukturierungen. Melden Sie sich zum kommenden Webinar am 16. Juni 2026 an! (Kostenlose Registrierung)

Register for free

Kommt Ihnen das bekannt vor?

Ihr LinkedIn-Feed ist voll von Aussagen wie: „KI kann SQL schreiben.“ „Stellen Sie Ihren Daten einfach eine Frage.“ „Kein Engineer erforderlich.“ Und tatsächlich: Einiges davon stimmt. KI-Agenten werden zunehmend besser darin, Datenstrukturen abzufragen, für die vor zwei Jahren noch Spezialwissen nötig war.

Die Frage ist also berechtigt: Wenn eine KI durch Raw-Data-Vault-Entitäten navigieren, Hubs mit Links und Satellites verknüpfen und eine korrekte Antwort liefern kann – welche Rolle bleibt für den Data Vault Engineer?

Scalefree wollte nicht länger über diese Frage diskutieren, sondern sie messen. Gleiche Daten, identischer KI-Agent, zwei Architekturen: eine schlanke Fact Table mit neun Spalten und ein vollständiges Raw Data Vault mit zwölf Tabellen. Zwanzig Fragen wurden jeweils beiden Systemen gestellt.

Das Ergebnis bei der Genauigkeit? Gleichstand. Das Gesamtbild? Weitaus differenzierter.

Die Einrichtung hinter den Ergebnissen

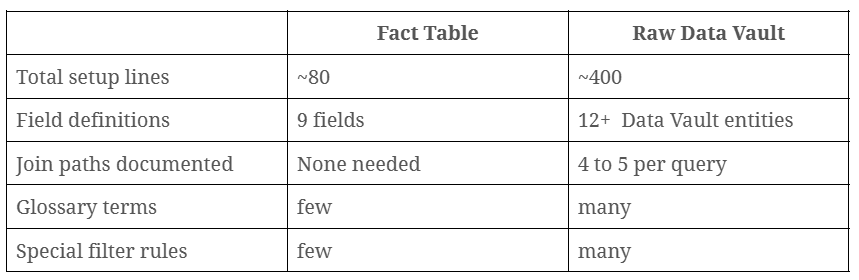
Beide Agenten basierten auf Googles Gemini Data Analytics SDK, einem sofort einsatzbereiten Python-Toolkit, das sich direkt mit BigQuery verbindet und die NL2SQL-Pipeline standardmäßig abwickelt. Doch bevor einer der Agenten eine einzige Frage beantworten konnte, benötigten beide einen detaillierten Satz von Systemanweisungen: Tabellenbeschreibungen, Felddefinitionen, Glossarbegriffe, Abfragehinweise. Hinter jeder dieser Informationen steht eine Person, die die Daten gut genug kennt, um sie präzise zu beschreiben. Diese Rolle verschwindet durch KI nicht – sie wird vielmehr noch wichtiger.

So sah dies in der Praxis aus:

AI Fact Table Comparison

Die Anweisungen für die Fact Table ließen sich in einem Durchgang erstellen. Das Raw Vault erforderte die Dokumentation jedes Join-Pfads, jeden Satellite-Filters und jeder Entitätsbeziehung, bevor der Agent korrekt schlussfolgern konnte. Das bedeutete fünfmal so viel Dokumentation für das gleiche Ergebnis.

Beide auf dem Prüfstand

Der Test war so angelegt, dass er sich in der Komplexität steigerte. Die ersten fünf Fragen waren einfach: Gesamtanzahl der Buchungen, Filterung nach Bürostandort. Dann kamen Datums- und Zeitlogik: bestimmte Tage, Monatszeiträume, tägliche Aufschlüsselungen. Die mittlere Stufe betraf die Daueranalyse: durchschnittliche Buchungslängen, das längste Zeitfenster, exakte Übereinstimmungen in Minuten. Danach folgten Muster nach Wochentagen: welcher Wochentag am häufigsten genutzt wurde, wie Montage im Vergleich abschnitten. Die letzten fünf Fragen kombinierten alle Aspekte – multidimensionale Abfragen, bei denen Standort, Zeit und Ressourcentyp in einer einzigen Antwort zusammengeführt werden mussten. Hier ein Auszug aus den letzten drei Stufen:

AI Excerpt of the 20-question benchmark test suite

Auszug aus der Benchmark-Test-Suite mit 20 Fragen

Eine bewusste Designentscheidung: keine personenbezogenen Daten. Namen und E-Mail-Adressen befinden sich in einem zugriffsbeschränkten Bereich des Vaults, auf den der Agent nicht zugreifen kann. Die Fact Table wurde von Anfang an entsprechend gestaltet. Ein fairer Test und saubere Data Governance.

Die Ergebnisse

Ehrlich? Niemand hatte mit einem perfekten Genauigkeitsergebnis gerechnet. Und unter uns: Als Data Vault Engineers hatten wir gehofft, dass es nicht so kommt.

AI Accuracy Comparison Table

Beide Architekturen beantworteten jede einzelne Frage korrekt. Der KI-Agent bewältigte ein Vault mit zwölf Tabellen inklusive Hubs, Links und Satellites genauso souverän wie eine einzelne, flache Tabelle. Das ist beeindruckend – und ein wenig ernüchternd. Es zeigt auch: Die Modellierung und Dokumentation wurden korrekt durchgeführt. Mit einer schlecht beschriebenen Struktur sind 20 von 20 Punkten unmöglich.

Doch betrachten Sie die letzten beiden Spalten: Das Raw Vault benötigte insgesamt 33 Minuten, um das zu leisten, was die Fact Table in sechs Minuten schaffte. Das entspricht durchschnittlich 1,65 Minuten pro Frage gegenüber 0,3 Minuten bei der Fact Table. Gleiches Ziel, aber fünfmal längerer Weg.

Was das für Ihr Unternehmen bedeutet

Übertragen wir diese Zahlen auf die geschäftliche Praxis:

33 Minuten Gesamtabfragezeit gegenüber sechs Minuten. Das sind durchschnittlich 1,65 Minuten pro Frage gegenüber 0,3 Minuten bei der Fact Table. Für Business-Anwender, die schnelle Antworten erwarten, ist dieser Unterschied spürbar. Und bevor überhaupt eine Abfrage lief, benötigte das Raw Vault etwa 400 Zeilen Systemanweisungen – geschrieben von jemandem, der die Daten tief genug versteht, um sie präzise zu beschreiben.

Das bedeutet nicht, dass das Raw Data Vault die falsche Wahl ist. Für das Enterprise-Datenmanagement bleibt es der Goldstandard. Doch ein KI-Agent, der direkt darauf arbeitet – ohne Semantic Layer und erfahrene Engineers – führt zu langsamen Antworten und frustrierten Nutzern.

Bauen Sie das Vault auf, und erstellen Sie darüber eine Fact Table als KI-taugliche Schicht. Diese Kombination vereint die Vorteile beider Ansätze. Sie gibt Ihrem Data Vault Engineer eine Aufgabe, die KI nicht übernehmen kann: Jemand muss die Daten gut genug kennen, um sie zu beschreiben und so modellieren, dass die KI damit arbeiten kann. Diese Rolle wird nicht verschwinden.

Die wichtigsten Erkenntnisse

  • Bewerten Sie Ihr KI-Setup nicht nur anhand der Genauigkeit. Berücksichtigen Sie auch Abfragezeit und Einrichtungsaufwand.
  • Eine gut modellierte Fact Table liefert schnelle, zuverlässige Conversational Analytics mit minimalem Aufwand.
  • Ein Raw Data Vault kann diese Genauigkeit erreichen, benötigt aber fünfmal mehr Dokumentation und läuft fünfmal langsamer.
  • Gute Dokumentation erfordert jemanden, der die Daten versteht. KI kann das nicht für Sie übernehmen – zumindest noch nicht.
  • Die beste Architektur für KI-Analysen ist kein Entweder-oder: Nutzen Sie das Vault für Datenintegrität und die Fact Table als KI-Schicht.
  • Ihr Data Vault Engineer ist kein Kostenfaktor, den man streichen kann. Er ist der Grund, warum das alles funktioniert.

Was als Nächstes kommt

Die gesamte Geschichte erfahren Sie in unserem kommenden Webinar: Conversational Analytics meistern – Ein praktischer Leitfaden für Einrichtung, Test und Optimierung. Live-Abfragen, echte Fehlerbeispiele, ein praktischer Entscheidungsrahmen – und das alles mit echten Unternehmensdaten. (Hier kostenlos registrieren)

Register here for free

In der Zwischenzeit teilen Sie uns gerne Ihre Situation mit: Arbeiten Sie mit einem Raw Vault, einer Fact Table oder einem anderen Ansatz? Hinterlassen Sie einen Kommentar – wir lesen alle.
Data Vault & Data Mesh in einer Data Fabric: Ein moderner Architekturleitfaden

Best Practices für die Data-Mesh-Implementierung

Unternehmen stehen häufig vor der Herausforderung, ihre Daten effizient zu verwalten. Daten sind meist über viele getrennte Systeme verteilt, wachsen kontinuierlich an Umfang sowie Komplexität und werden für eine zunehmende Anzahl von Anwendungsfällen benötigt. Selbst erfahrene Fachleute stoßen hierbei an Grenzen. Um dem zu begegnen, haben sich Ansätze wie Data Fabric, Data Vault und Data Mesh als wesentliche Grundlagen für den Aufbau robuster, flexibler Datenplattformen und effizienter Prozesse etabliert.

Gleichzeitig bringen diese modernen Ansätze zusätzliche Komplexität für das Management von Datenplattformen mit sich. Dieser Artikel beleuchtet, wie sich die drei Konzepte optimal kombinieren lassen, um eine leistungsfähige und zukunftssichere Datenarchitektur zu schaffen, die Datenarchitekten als fundierter Leitfaden dient.

Data Vault & Data Mesh in einer Data Fabric: Ein moderner Architekturleitfaden

Dieses Webinar bietet einen kompakten Überblick über Data Fabric, Data Vault sowie Data Mesh und vertieft anschließend die konkreten Vorteile aus der Kombination dieser Ansätze. Melden Sie sich jetzt für unser kostenloses Webinar am 13. Mai 2025 an!

Watch Webinar Recording

Die Data Fabric: Vereinheitlichung verteilter Datenökosysteme

Um der Herausforderung verteilter, heterogener Datenlandschaften zu begegnen, hat sich die Data Fabric als architektonischer Ansatz etabliert. Sie nutzt metadatengetriebene Automatisierung und intelligente Funktionen, um eine einheitliche und konsistente Datenmanagementschicht zu schaffen. Dieses Framework ermöglicht einen nahtlosen Datenzugriff sowie eine reibungslose Datenbereitstellung und steigert so nachhaltig die Agilität des gesamten Unternehmens.

Zu den Hauptmerkmalen einer Data Fabric gehören:

  • Einheitlicher Datenzugriff: Bereitstellung eines integrierten Zugriffs für unterschiedlichste Benutzeranforderungen.
  • Zentralisierte Metadaten: Nutzung eines KI-gestützten Datenkatalogs für effiziente Data Discovery und ein besseres Datenverständnis.
  • Erweiterte, metadatengetriebene Automatisierung: Steigerung von Effizienz und Skalierbarkeit durch automatisierte Prozesse auf Basis eines umfassenden Metadatenmanagements.
  • Verstärkte Governance und Sicherheit: Standardisierung von Verfahren zur unternehmensweiten Verbesserung von Governance und Datensicherheit.

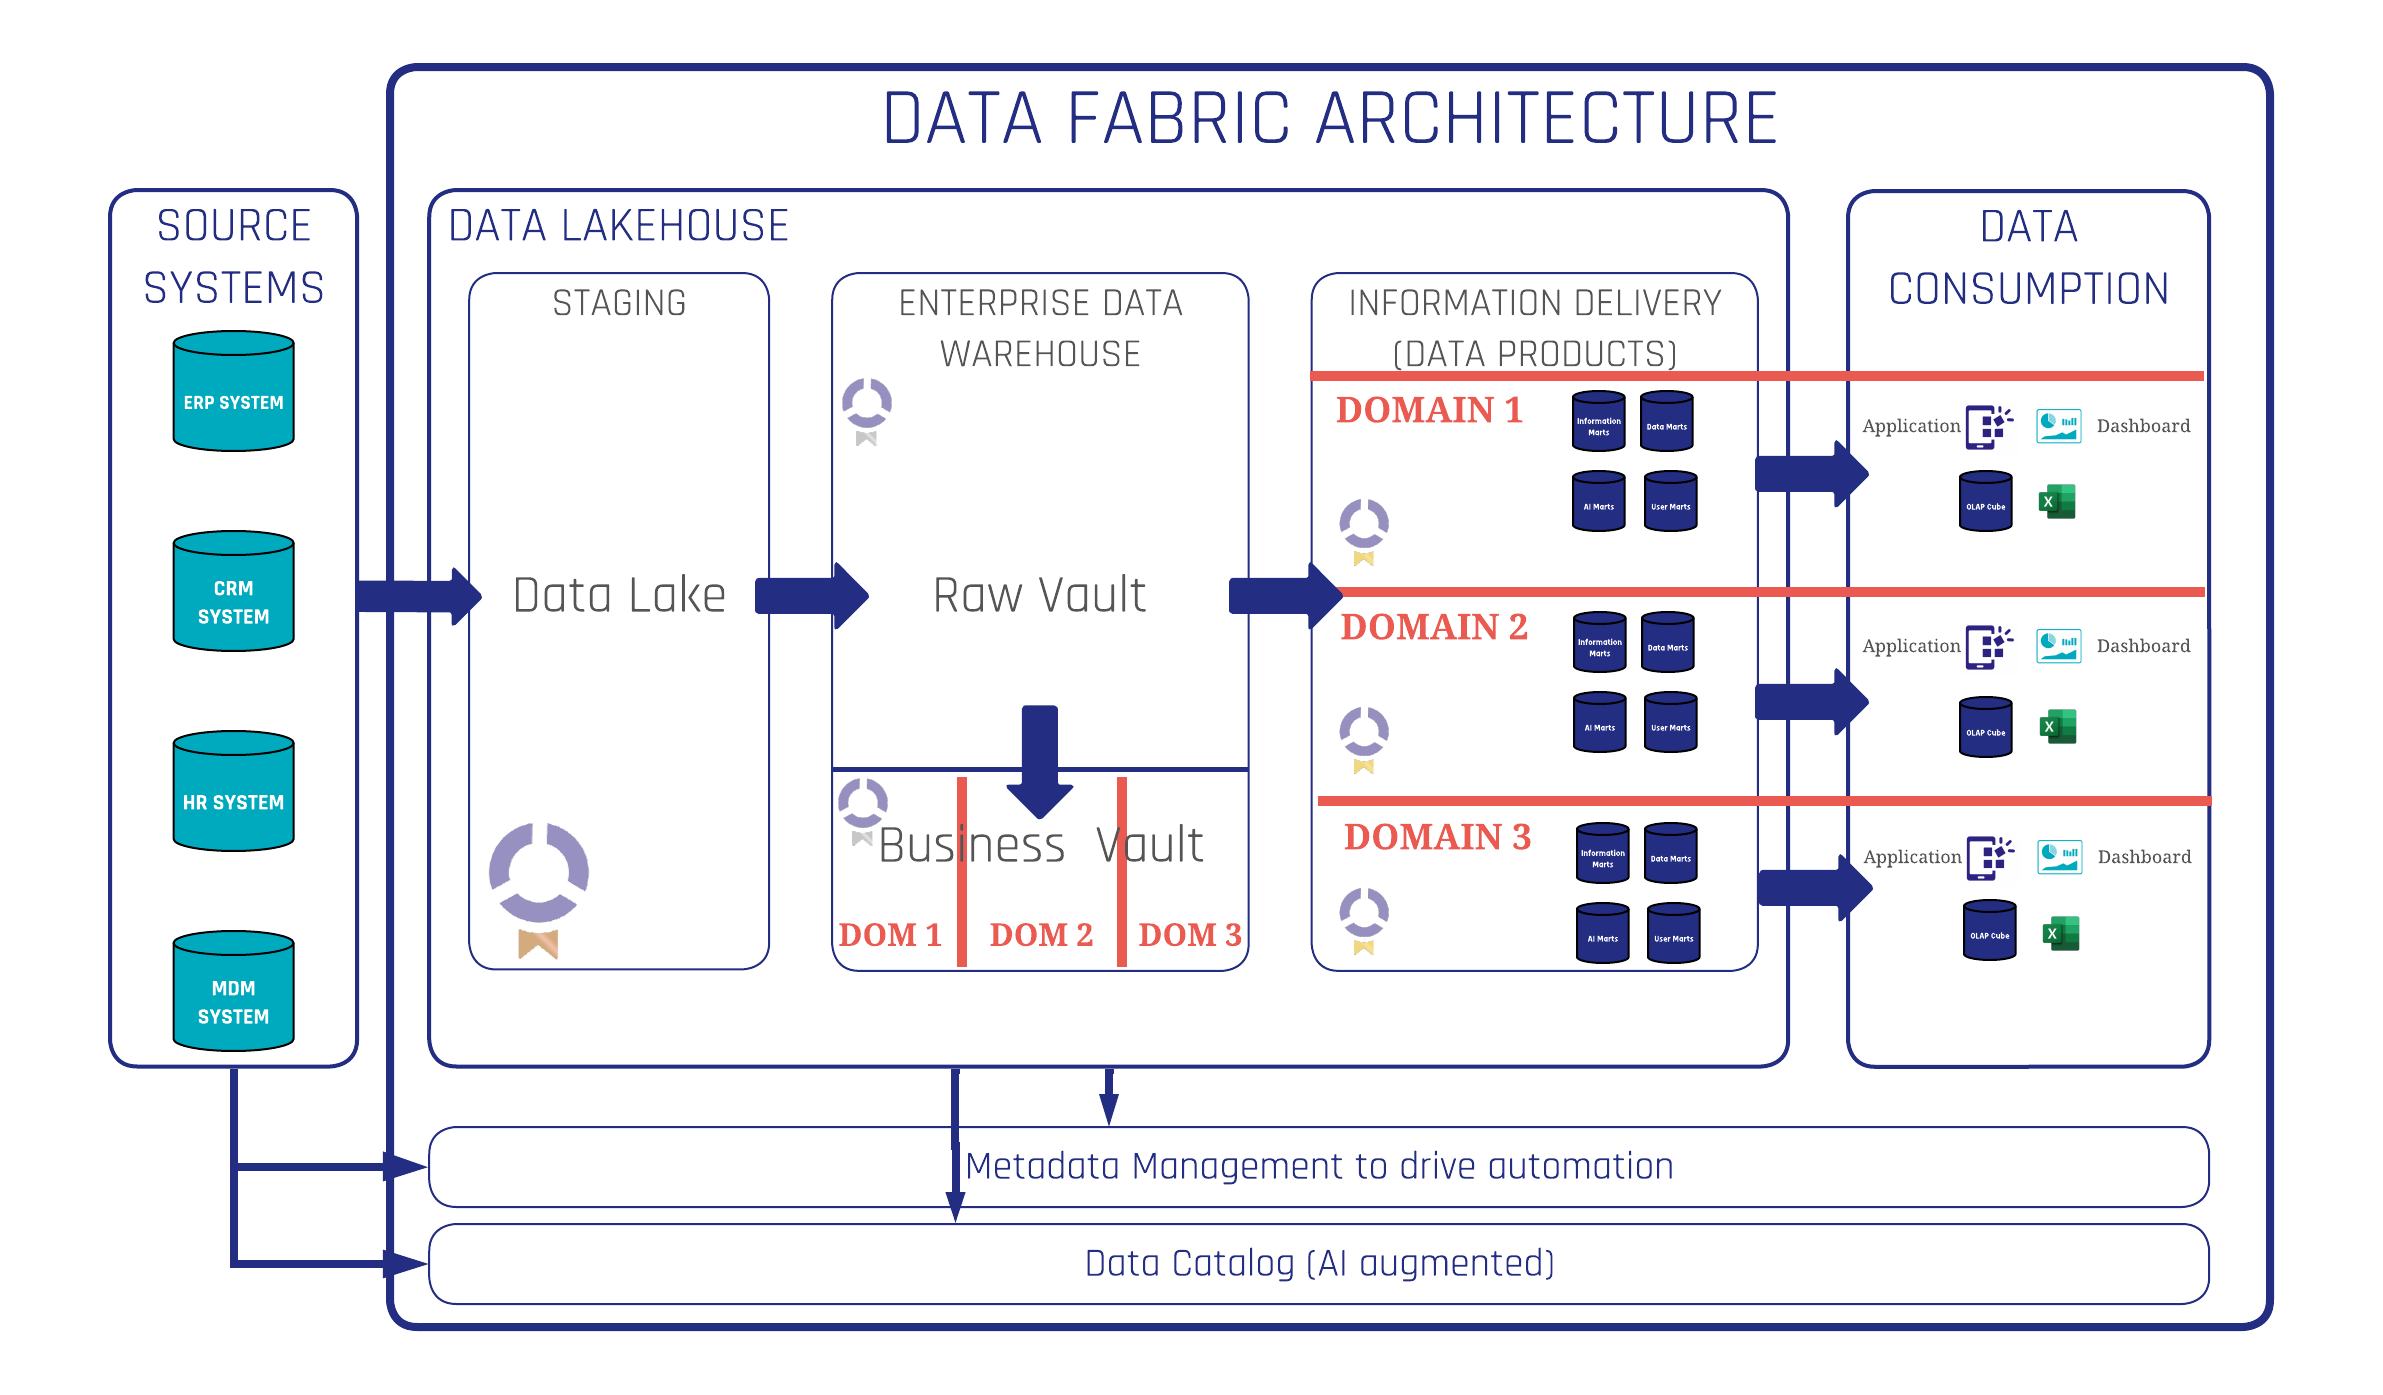
Eine moderne Data-Fabric-Plattform integriert eine Vielzahl von Systemen und Prozessen, um das Datenmanagement zu optimieren. Dieser Ablauf beginnt mit der Einbindung von Daten aus verschiedenen Quellsystemen wie ERP, CRM, HR und MDM. Anschließend wird ein Data Lakehouse angebunden, das als Staging Area für die Datenaufbereitung dient.

Data Fabric Architecture EDW

Die Architektur umfasst darüber hinaus ein Enterprise Data Warehouse für die zentrale Datenspeicherung, gefolgt von der Implementierung von Information Marts, AI Marts und User Marts für eine zielgerichtete Informationsbereitstellung. Schließlich unterstützt die Plattform verschiedene Formen der Datennutzung, darunter Applikationen, Dashboards und OLAP-Cubes.

Das Data Lakehouse bildet zudem die drei Medallion-Schichten ab: Rohdaten (Bronze Layer), integrierte Datenschicht (Silver Layer) und Informationsbereitstellungsschicht (Gold Layer) mit ihren einsatzbereiten Datenprodukten.

Entscheidend für diese Architektur sind ein robustes Metadatenmanagement und ein KI-gestützter Datenkatalog, die gemeinsam die Automatisierung vorantreiben und Data Discovery erleichtern.

Data Vault: Aufbau einer Single Source of Facts

Data Vault ist eine Datenmodellierungsmethodik, die speziell für den Aufbau und die Wartung von Enterprise Data Warehouses konzipiert wurde. Bekannt für Flexibilität, Skalierbarkeit und die lückenlose Historisierung von Daten, fügt sich Data Vault nahtlos in das Ziel einer einheitlichen Datenmanagementschicht sowie in den Automatisierungsfokus einer Data Fabric ein.

Zu den Hauptvorteilen von Data Vault gehören:

  • Skalierbarkeit: Mühelose Anpassung an wachsende Datenmengen und steigende Komplexität.
  • Flexibilität: Schnelle Reaktion auf sich verändernde Geschäftsanforderungen.
  • Konsistenz: Sicherstellung der Datenintegrität über das gesamte Unternehmen hinweg.
  • Musterbasierte Modellierung (Pattern-based Modeling): Ideale Grundlage für eine durchgehende Datenautomatisierung.
  • Auditierbarkeit: Bereitstellung einer klaren, revisionssicheren Datenhistorie.
  • Agilität: Schnellere Bereitstellung neuer Datenstrukturen und Funktionen.

Innerhalb einer modernen Data-Fabric-Plattform wird das Data-Vault-Modell im Enterprise Data Warehouse implementiert. Der Raw Data Vault integriert alle Quellsysteme in Form von Business Objects und deren Beziehungen. Der schlank und bedarfsgerecht aufgebaute Business Vault auf Basis des Raw Data Vault ergänzt erweiterte Data-Vault-Entitäten, beispielsweise für Query Assistants, um die Erstellung zu erleichtern und die Performance der Informationsbereitstellungsschicht zu optimieren.

Data Fabric Architecture with Data Vault

Dieser Ansatz liefert alle genannten Vorteile und ermöglicht dank seiner musterorientierten Modellierungsmethode einen außergewöhnlich hohen Automatisierungsgrad.

Data Mesh: Dezentralisierung von Data Ownership und Datenzugriff

Data Mesh ist ein dezentraler Ansatz für das Datenmanagement, der Domain Ownership, Data as a Product, Self-Service-Datenplattformen und Federated Governance in den Mittelpunkt stellt. Dieses Konzept verlagert die fachliche Verantwortung für das Datenmanagement auf domänenspezifische Teams und fördert so eine höhere Eigenverantwortung und Agilität.

Zu den Kernprinzipien gehören:

  • Domain Ownership: Dezentrale Verantwortung für analytische und operative Daten.
  • Data as a Product: Behandlung analytischer Daten als hochwertige, gemanagte Produkte.
  • Self-Service-Datenplattform: Bereitstellung von Tools für die autonome Erstellung und Verwaltung von Daten.
  • Federated Governance: Etablierung einer domänenübergreifenden, kollaborativen Governance.
  • Dezentrale Datendomänen: Jede Domäne verantwortet und betreibt ihre eigenen Datenprodukte.

Die Implementierung eines Data Mesh auf einer Data-Fabric-Plattform erfordert grundlegende Komponenten wie standardisierte DevOps-Prozesse, klare Modellierungsrichtlinien und einen umfassenden Datenkatalog.

Obwohl eine vollständige Dezentralisierung der Datenpipelines über ein reines Data Mesh theoretische Vorteile verspricht, zeigt die Praxis, dass eine selektive Integration zentraler Data-Mesh-Prinzipien in eine Data-Fabric-Architektur deutlich wirksamer ist. So lässt sich eine dezentrale Ownership nutzen, während gleichzeitig die Stärken eines automatisierten, zentralen Datenkerns auf Basis von Data Vault erhalten bleiben.

Best Practices für die Data-Mesh-Implementierung

  • Zentralisiertes Staging und Raw Vault: Schafft die Basis für einen maximalen Automatisierungsgrad.
  • Dezentraler Business Vault und nachgelagerte Schichten: Erleichtert die Einbindung von Fachbereichswissen und den produktiven Einsatz cross-funktionaler Teams.
Best Practices für die Data-Mesh-Implementierung

Für eine optimale Umsetzung sorgt ein Ansatz mit zentralem Staging und Raw Vault für einen hohen Automatisierungsgrad und garantiert, dass sich alle Datenprodukte auf eine verlässliche Single Source of Facts beziehen. Im Gegensatz dazu ermöglicht eine Strategie mit dezentralem Business Vault und nachgelagerten Bereichen die nötige Integration von Fachwissen, eine klare Verantwortung für Datenprodukte (Data Product Ownership) sowie eine effiziente Skalierung. Dieser Grad an Dezentralisierung ist der Schlüssel für eine erfolgreiche Data-Mesh-Implementierung unter Einbindung cross-funktionaler Domänenteams.

Empfohlene Architektursynthese

Die empfohlene Architektur vereint Data Fabric, Data Mesh und Data Vault zu einem harmonischen Gesamtbild und schöpft die individuellen Stärken jedes Ansatzes optimal aus. Diese Synthese führt zu einer metadatengetriebenen, flexiblen, hochgradig automatisierten, transparenten und sicher gesteuerten (governed) Datenumgebung.

Anwendungsfälle und Einsatzbereiche

Diese moderne Datenarchitektur unterstützt ein breites Spektrum an Anwendungsfällen, darunter:

  • Effizientes und vertrauenswürdiges Reporting sowie Advanced Analytics
  • Regulatorische Compliance durch einen vollständig auditierbaren Kern
  • Vielfältige KI- und Machine-Learning-Anwendungen

Fazit

Die Integration von Data Fabric, Data Vault und Data Mesh ermöglicht es Unternehmen, eine zukunftsfähige Datenarchitektur aufzubauen, die durch Flexibilität, Skalierbarkeit und Effizienz überzeugt. Dieser ganzheitliche Ansatz optimiert das Datenmanagement, verbessert den Datenzugriff und beschleunigt die Bereitstellung von Datenprodukten – was bei einem Höchstmaß an Automatisierung, Governance und Transparenz zu messbar besseren Geschäftsergebnissen führt.

Vom Vault zum Value: Scalefree & Coalesce transformieren die Datenautomatisierung

Data Vault4Coalesce Data Automation Banner

In der heutigen schnelllebigen Datenlandschaft erfordert ein nachhaltiger Wettbewerbsvorsprung effiziente, skalierbare und automatisierte Prozesse – insbesondere in komplexen Data-Warehousing-Umgebungen. Dieser Newsletter zeigt auf, wie eine strategische Partnerschaft und innovative Werkzeuge Ihren Ansatz für Data Vault revolutionieren können, sodass Sie schneller messbare Mehrwerte generieren und gleichzeitig die Kosten effektiv steuern. Erfahren Sie im Detail, wie Scalefree und Coalesce gemeinsam die Datenautomatisierung neu gestalten.

Vom Vault zum Value: Scalefree & Coalesce transformieren die Datenautomatisierung

Sind Ihre Data-Vault-Projekte zu langsam und zu kostenintensiv?
Machen Sie Ihren Data Vault zum echten Werttreiber! Entdecken Sie, wie Scalefree und Coalesce die Datenautomatisierung transformieren. Erfahren Sie mehr über die neuesten DataVault4coalesce-Features, innovative Funktionen in coalesce.io und wie unsere Partnerschaft Ihnen dabei hilft, Kosten zu senken sowie schnellere Ergebnisse zu liefern. Registrieren Sie sich jetzt für unser kostenloses Webinar am 17. April 2025!

Watch Webinar Recording

Schnellere Wertschöpfung erzielen und Kosten in Ihren Data-Vault-Projekten senken

Bei der Beschleunigung von Data-Vault-Implementierungen und der Maximierung des ROI steht man oft vor Hürden wie langen Entwicklungszyklen, hohen Wartungskosten und der Herausforderung, mit sich ständig weiterentwickelnden Technologien Schritt zu halten. Um diesen Herausforderungen wirksam zu begegnen, bedarf es einer Kombination aus bewährter Methodik und leistungsstarker Automatisierung. Die strategische Partnerschaft zwischen Scalefree (den Data-Vault-Experten) und Coalesce (Plattform für Datentransformation) adressiert genau diese Kernprobleme.

Durch die Kombination standardisierter Data-Vault-Patterns mit automatisierter Codegenerierung und Transformationsverwaltung bietet dieser Ansatz eine zukunftssichere Lösung. Er reduziert den manuellen Aufwand erheblich, spart Entwicklungskosten, ermöglicht schnelle Ergebnisse und minimiert Risiken durch Dateninkonsistenzen. Erfahren Sie alle Details dazu, wie diese Zusammenarbeit Prozesse optimiert, in unserem bevorstehenden Webinar „From Vault to Value: Scalefree & coalesce.io Transforming Data Automation“.

Die Kraft der Partnerschaft: Expertise trifft auf Automatisierung

Scalefree bringt fundiertes Fachwissen und Best Practices der Data-Vault-2.0-Methodik ein, während coalesce.io eine leistungsstarke Plattform zur Automatisierung von Datentransformationen bereitstellt – speziell optimiert für Snowflake. Gemeinsam schaffen beide Partner Synergien, die die Agilität Ihrer Teams spürbar steigern und die Gesamtkosten (Total Cost of Ownership, TCO) Ihres Data Warehouse nachhaltig senken.

Vorstellung von DataVault4coalesce: Ihr Accelerator

Ein wesentlicher Schwerpunkt liegt auf DataVault4coalesce, dem von Scalefree entwickelten Spezialpaket. Es automatisiert die Generierung von Data-Vault-Strukturen und Loading-Patterns innerhalb von coalesce.io. Dies führt unmittelbar zu kürzeren Entwicklungszeiten, einem minimierten Fehlerrisiko und deutlich reduziertem Wartungsaufwand – wodurch typische Kostentreiber in komplexen Projekten eliminiert werden. Das Paket umfasst modernste Komponenten, die darauf ausgelegt sind, noch schneller Ergebnisse zu erzielen – selbst bei knapp kalkulierten Budgets.

Zu den neuesten Erweiterungen gehört die Unterstützung weiterer Data-Vault-Entitäten wie Effectivity Satellites und Reference Data. Zudem arbeitet das Scalefree-Team kontinuierlich daran, die Ladeleistung (Loading-Performance) der bereitgestellten Nodes weiter zu optimieren.

Modernste Technologien entdecken: Was gibt es Neues bei Coalesce?

Über die Erweiterungen des DataVault4coalesce-Pakets hinaus entwickelt sich auch die coalesce.io-Plattform kontinuierlich weiter. Dieser Abschnitt behandelt spannende neue Funktionalitäten, darunter Updates zur Verbesserung von Entwicklungs-Workflows sowie erste KI-gestützte Features. Zudem beleuchten wir die ersten Preview-Funktionen für Databricks und zeigen auf, wie die kürzliche Übernahme von Castordoc durch Coalesce das gesamte Ökosystem stärkt und Data Governance sowie Data Discovery gezielt verbessert. Bleiben Sie am Puls der Zeit und erfahren Sie, wie diese Fortschritte zu einer nachhaltigen und zukunftssicheren Datenstrategie beitragen.

Ausblick: Die Roadmap für DataVault4coalesce

Ein Ausblick auf die Roadmap unterstreicht das Engagement von Scalefree und Coalesce für kontinuierliche Innovation. So wird sichergestellt, dass Ihre Werkzeuge zur Datenautomatisierung stets auf dem neuesten Stand bleiben und sich flexibel an neue Anforderungen anpassen.

Mit der Erweiterung von Coalesce auf Databricks arbeitet Scalefree aktiv daran, eine umfassende Unterstützung für diese Datenplattform bereitzustellen. Eine Databricks-Version von DataVault4coalesce befindet sich bereits in der aktiven Entwicklung. Die künftige Unterstützung weiterer Datenbanken ist fest in der Entwicklungs-Roadmap verankert, um allen Anwendern von coalesce.io ein erstklassiges Data-Vault-Erlebnis zu garantieren – unabhängig von der gewählten Zielplattform.

Wesentliche Vorteile und Kernpunkte

Die wichtigsten Erkenntnisse im Überblick:

  • Maximierung der Wertschöpfung durch die Partnerschaft zwischen Scalefree und Coalesce
  • Nutzung von DataVault4coalesce für erhebliche Zeit- und Kosteneinsparungen auf Snowflake
  • Einsatz modernster Funktionen in coalesce.io wie KI-Unterstützung und Databricks-Integrationen
  • Umfassendes Verständnis für das sich stetig weiterentwickelnde Ökosystem der Datenautomatisierung

Verwandeln Sie Ihre Data-Vault-Projekte von komplexen Großvorhaben in hocheffiziente Motoren für Ihre unternehmerische Wertschöpfung.

Fazit

Fundierte Einblicke in diese Themen zu gewinnen, ist entscheidend, um modernste Automatisierungstechnologien gewinnbringend in Ihren Data-Vault-Projekten einzusetzen. Dieses Verständnis ist der Schlüssel, um Ihre Datenstrategie zu optimieren, den administrativen Overhead zu reduzieren und im heutigen Wettbewerbsumfeld schnellere sowie kosteneffizientere Ergebnisse zu erzielen.

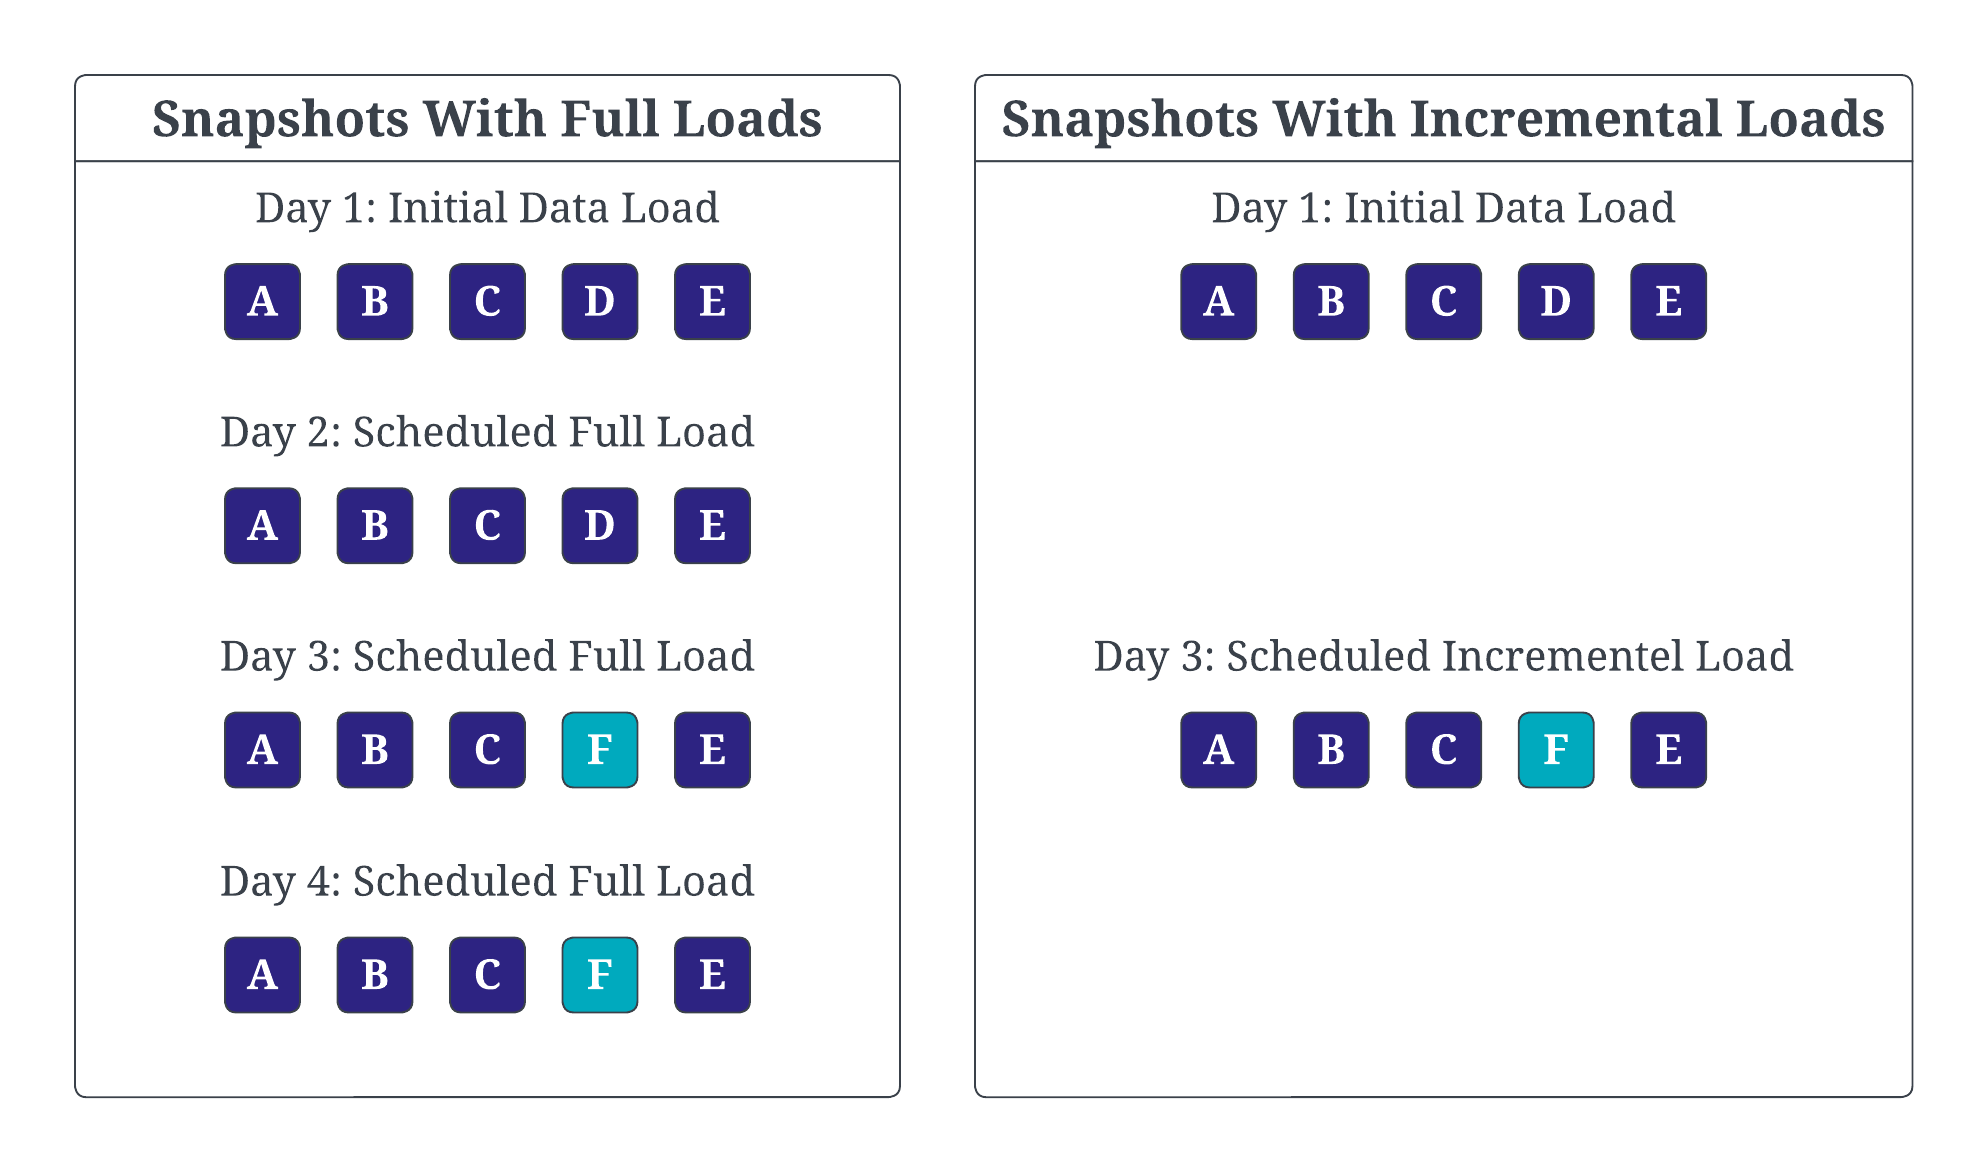
Handhabung von Snapshotting über eine andere Zeitachse als das Load Date

Snapshot Full Load vs. Incremental Load

Snapshotting ist ein entscheidender Prozess bei der Verwaltung von Finanz- und Geschäftsdaten. Dabei wird eine statische Datenkopie zu einem bestimmten Zeitpunkt (Point in Time) erfasst und für künftige Referenzen, Analysen und das Reporting aufbewahrt. Somit erleichtert Snapshotting die datenbasierte Entscheidungsfindung, indem es eine verlässliche historische Zeitachse für bestimmte Business Dates bereitstellt – etwa für Trendanalysen, Compliance, Prognosen und viele weitere Anwendungsfälle zur Wertsteigerung Ihrer Berichte. Dieser Newsletter befasst sich detailliert mit dem Thema Snapshotting auf Basis von Business Dates im Vergleich zu System-Timestamps und hebt dessen Bedeutung für die Sicherstellung von Datengenauigkeit und Datenkonsistenz hervor.

Handhabung von Snapshotting über eine andere Zeitachse als das Load Date

Dieses Webinar befasst sich mit den Feinheiten des Snapshotting auf Basis von Business Dates, einer essenziellen Data-Warehousing-Technik, die historische Daten an spezifischen fachlichen Anforderungen ausrichtet und dem Snapshotting nach Load Date gegenüberstellt. Seien Sie am 15. April um 11:00 Uhr MESZ dabei, um dieses Thema eingehend zu vertiefen.

Watch Webinar Recording

Snapshotting – Ein Überblick

Snapshotting ist im Wesentlichen der Prozess der Erstellung eines Datenabbilds zu einem bestimmten Zeitpunkt. Im Geschäfts- und Finanzkontext stellt die Ausrichtung von Snapshots an Business Dates statt an System-Timestamps sicher, dass Berichte und Analysen die operativen Zeitabläufe widerspiegeln. Dies ist entscheidend für das Periodenabschluss-Reporting, die Einhaltung gesetzlicher Vorschriften (Compliance) und historische Trendanalysen.

Hauptmerkmale von Snapshots

  • Datenintegrität und Datengenauigkeit: Snapshots erfassen einen vollständigen Datensatz zu einem bestimmten Zeitpunkt; der erfasste Datensatz sollte unveränderlich (immutable) sein – mit Ausnahme von Late-Arriving Data, auf die wir später eingehen werden. Diese historische Darstellung stellt sicher, dass Daten für zukünftige Referenzen, Reports und Analysen konsistent und verlässlich bleiben, unabhängig von nachfolgenden Änderungen oder Löschungen.
  • Source of Truth: Durch die exakte Aufbewahrung der Daten im Zustand eines bestimmten Zeitpunkts bieten Snapshots eine verlässliche Source of Truth für Audits, Compliance und regulatorische Anforderungen. Sie ermöglichen es Unternehmen, Veränderungen im Zeitverlauf nachzuvollziehen, Trends zu erkennen und fundierte Entscheidungen auf der Grundlage präziser historischer Daten zu treffen.
  • Ausrichtung an den Geschäftsprozessen: Anders als traditionelle Datenspeichermethoden, die auf Timestamps basieren, werden Snapshots nach einem festgelegten Zeitplan indexiert, z. B. nach Business Dates oder Zeitintervallen (stündlich, täglich, wöchentlich usw.). Dieser Ansatz stellt sicher, dass Daten so strukturiert und zugänglich sind, dass sie mit den Geschäftsprozessen und Berichtszyklen übereinstimmen. Durch die Berücksichtigung von arbeitsfreien Tagen, Feiertagen und definierten fachlichen Stichtagen (Business Cutoffs) liefern Snapshots aus betriebswirtschaftlicher Sicht eine aussagekräftigere und relevantere Datendarstellung.

Herausforderungen bei Snapshots

  • Umgang mit Late-Arriving Data: Transaktionen oder Aktualisierungen können nach der Erstellung eines Snapshots eintreffen, was Strategien zur Handhabung rückwirkender Änderungen erfordert.
  • Business Date vs. Kalenderdatum: Die Ausrichtung von Snapshots an Business Dates statt an System-Timestamps kann komplex sein, insbesondere im Umgang mit Wochenenden, Feiertagen oder unterschiedlichen Zeitzonen.
  • Systemübergreifende Datenkonsistenz: Das Sicherstellen, dass alle zusammenhängenden Datensätze zum selben logischen Zeitpunkt erfasst werden, ist entscheidend für eine konsistente Berichterstattung und Analyse.
  • Snapshot-Frequenz und Granularität: Die Wahl der richtigen Balance zwischen vollständigen (Full Snapshots) und inkrementellen Snapshots beeinflusst die Systemleistung und Benutzerfreundlichkeit. Werden zu wenige Snapshots erstellt, kann dies zu Datenlücken führen; zu viele Snapshots hingegen erhöhen den Verarbeitungsaufwand.

Strategien für ein effektives Snapshot-Management

Um Snapshotting über eine Zeitachse, die nicht ausschließlich auf dem Load Date basiert, effektiv zu verwalten, müssen mehrere wichtige Aspekte berücksichtigt werden:

Snapshot-Frequenz

  • Die Häufigkeit, mit der Snapshots erstellt werden, sollte sich nach den spezifischen Anforderungen des Unternehmens richten, einschließlich des Reporting-Bedarfs, gesetzlicher Vorgaben und Datenaufbewahrungsrichtlinien (Retention Policies).
  • Zu den Optionen für die Snapshot-Frequenz gehören tägliche, wöchentliche, monatliche oder noch feingranularere Intervalle, abhängig von der Volatilität der Daten und der Notwendigkeit historischer Genauigkeit.
  • Es ist unerlässlich, den Bedarf an häufigen Snapshots mit dem dadurch entstehenden Speicher- und Verarbeitungsaufwand abzuwägen.

Ausrichtung am Business Date

  • Snapshots sollten an Business Dates statt an System-Timestamps ausgerichtet sein, um Konsistenz und Relevanz für die Geschäftsabläufe sicherzustellen.
  • Diese Ausrichtung muss Wochenenden, Feiertage und sonstige arbeitsfreie Tage ebenso berücksichtigen wie Periodenabschluss-Korrekturen und andere geschäftsspezifische Kalenderfaktoren.
  • Ziel ist es, Daten zu erfassen, die den Zustand des Unternehmens zu einem bestimmten Zeitpunkt aus fachlicher Sicht präzise widerspiegeln.

Snapshot-Typ

  • Die Entscheidung zwischen vollständigen Snapshots (Full Snapshots) und inkrementellen Snapshots hängt von Faktoren wie Speicherkapazität, Rechenleistung und Anforderungen an den Datenabruf ab.
  • Vollständige Snapshots erfassen den gesamten Datensatz zu einem bestimmten Zeitpunkt, während inkrementelle Snapshots lediglich die Änderungen speichern, die seit dem letzten Snapshot aufgetreten sind.
  • Inkrementelle Snapshots sind hinsichtlich Speicherplatz und Rechenleistung im Allgemeinen effizienter, können jedoch in der Verwaltung und Wiederherstellung komplexer sein.
Snapshot Full Load vs. Incremental Load

Verspätete und korrigierte Daten (Late / Corrected Data)

Um die Datengenauigkeit und historische Integrität in einem Snapshotting-System zu gewährleisten, das eine andere Zeitachse als das Load Date verwendet, muss ein robuster Mechanismus für den Umgang mit verspätet eintreffenden Transaktionen (Late-Arriving Transactions) und Datenkorrekturen implementiert werden. Dies ist unerlässlich, um eine verlässliche und konsistente Darstellung der Daten im Zeitverlauf aufrechtzuerhalten.

Hierfür können verschiedene Strategien eingesetzt werden, darunter Versionierung und Rückdatierung (Backdating). Bei der Versionierung werden mehrere Versionen der Daten vorgehalten, die jeweils einen bestimmten Zeitpunkt repräsentieren, was eine einfache Nachverfolgung von Änderungen und bei Bedarf Rollbacks ermöglicht. Bei der Rückdatierung (Backdating) hingegen wird den Daten ein Timestamp zugewiesen, der den tatsächlichen Zeitpunkt des Auftretens widerspiegelt und nicht den Zeitpunkt des Ladens in das System. Dadurch wird sichergestellt, dass die Daten in ihren korrekten historischen Kontext eingeordnet werden.

Darüber hinaus ist es entscheidend, die potenziellen Auswirkungen verspäteter oder korrigierter Daten auf das Reporting und die Analysen zu berücksichtigen. Verspätet eintreffende Daten können Ergebnisse verfälschen und zu ungenauen Schlussfolgerungen führen, wenn sie nicht ordnungsgemäß behandelt werden. Ebenso können Datenkorrekturen frühere Analysen entwerten und Neuberechnungen erforderlich machen. Daher müssen geeignete Kontrollmechanismen und Sicherheitsvorkehrungen getroffen werden, um diese Risiken zu minimieren. Dazu können Datenvalidierungsprüfungen, Abstimmungsprozesse (Reconciliation) und Audit-Trails gehören, um Datenänderungen nachzuverfolgen und Verantwortlichkeiten sicherzustellen.

Durch die Implementierung dieser Maßnahmen können Unternehmen die Genauigkeit, Konsistenz und Verlässlichkeit ihrer Snapshot-Daten auch bei verspäteten Transaktionen und Datenkorrekturen wahren. Dies wiederum ermöglicht es Ihnen, fundierte Entscheidungen zu treffen, präzise Berichte zu erstellen und effektive Analysen auf Basis vertrauenswürdiger historischer Daten durchzuführen.

Weitere Überlegungen

  • Retention Policy: Etablieren Sie eine klare Aufbewahrungsrichtlinie für Snapshots unter Berücksichtigung gesetzlicher, regulatorischer und geschäftlicher Anforderungen.
  • Speicher und Performance: Evaluieren Sie Speicheroptionen und deren Auswirkungen auf die Systemleistung unter Berücksichtigung von Skalierbarkeit und Kosten.
  • Datensicherheit: Implementieren Sie geeignete Sicherheitsmaßnahmen, um Snapshot-Daten vor unbefugtem Zugriff oder Manipulationen zu schützen.
  • Disaster Recovery: Binden Sie Snapshots in Disaster-Recovery-Pläne ein, um die Geschäftskontinuität sicherzustellen.
  • Metadatenmanagement: Verwalten Sie Metadaten zu Snapshots, einschließlich des Erstellungszeitpunkts, des Business Date und des Snapshot-Typs –, um die Verwaltung und den Abruf zu erleichtern.

Durch die sorgfältige Berücksichtigung dieser Faktoren und die Umsetzung einer durchdachten Snapshot-Management-Strategie können Unternehmen Snapshots effektiv nutzen, um Geschäftsabläufe, die regulatorische Compliance und eine datengestützte Entscheidungsfindung zu unterstützen.

Fazit

Snapshotting auf Basis von Business Dates ist für das Datenmanagement, insbesondere im Geschäfts- und Finanzbereich von entscheidender Bedeutung. Es bietet eine verlässliche Grundlage für Reporting, Analysen und Entscheidungsfindung, indem es Daten im Einklang mit den operativen Geschäftsabläufen erfasst und strukturiert. Snapshots erleichtern zudem die historische Dokumentation für Compliance und Audits und ermöglichen Vergleiche zwischen verschiedenen Zeiträumen. Potenzielle Herausforderungen wie Datenduplikation und Dateninkonsistenzen müssen jedoch durch solide Datenmanagement-Praktiken bewältigt werden. Zusammenfassend bietet Snapshotting erhebliche Vorteile, erfordert jedoch ein sorgfältiges Management zur Gewährleistung von Datengenauigkeit und Datenintegrität.

Unit of Work im Data Vault

Was ist die Unit of Work?

Die Unit of Work ist ein grundlegendes Konzept bei der Data-Vault-Modellierung. Sie beschreibt das Prinzip, alle zusammenhängenden Business Keys aus einem Quellsystem gemeinsam in einer einzigen Link-Struktur zu erfassen. Dadurch wird sichergestellt, dass die in den Rohdaten abgebildeten Beziehungen in Ihrem Raw Data Vault vollständig und unverfälscht erhalten bleiben.

Stellen Sie es sich wie ein Puzzle vor, bei dem alle Teile zusammengehören: Wenn Sie die Teile ohne eine klare Strategie für das spätere Zusammensetzen voneinander trennen, riskieren Sie, das ursprüngliche Gesamtbild zu verlieren – oder schlimmer noch, ein Bild zu erzeugen, das in der Realität nie existiert hat.


Die Kernfrage: Was passiert, wenn Sie Links aufteilen?

Die zentrale Frage aus unserer Data-Vault-Friday-Session lautete:

„Es wäre gut, das Thema Unit of Work noch einmal aufzugreifen. Welche Informationen verliere ich, wenn ich breitere Links in kleinere Paare aufteile (DrivingKey -> Key1/Key2 etc)? Ich kann mir ein technisches Setup vorstellen, bei dem ich mehrere Links und Effectivity Satellites nutze und in der Lage sein sollte, zu jedem beliebigen Zeitpunkt dieselben Ergebnisse zu erzielen… Welche Informationen gehen genau verloren, wenn ich Links aufteile?“

Das Risiko beim Aufteilen von Links: Ein Praxisbeispiel

Beginnen wir mit einem einfachen Beispiel, um das Problem zu veranschaulichen:

Stellen Sie sich eine Beziehung zwischen drei Geschäftsentitäten vor – Customer, Store und Product. Customers betreten Stores und kaufen Products. Wenn Sie diese Beziehung als einen einzelnen Link modellieren, der alle drei Hubs (Customer, Store, Product) umfasst, erhalten Sie ein präzises und unverfälschtes Bild dieser Transaktion.

Nehmen wir nun an, Sie entscheiden sich dafür, diesen Link in zwei kleinere Links aufzuteilen:

  • Customer -> Store
  • Customer -> Product

Auf den ersten Blick mag das unproblematisch erscheinen. Wenn Sie jedoch versuchen, den ursprünglichen Datensatz durch das Verknüpfen (Joinen) dieser beiden Links zu rekonstruieren, erzeugen Sie möglicherweise neue Kombinationen, die es in Wirklichkeit nie gegeben hat. Zum Beispiel:

  • Customer A hat Store K besucht und Product X gekauft (valide)
  • Customer A hat Store L besucht (ebenfalls valide), aber wenn Sie dies mit Product X verknüpfen, entsteht eine falsche Beziehung: Customer A hat Product X in Store L gekauft (was tatsächlich nie stattgefunden hat).

Dieses Phänomen, bei dem durch Joins neue, künstliche Datensätze generiert werden, führt zu Dateninkonsistenzen. Sie führen damit Beziehungen ein, die im Quellsystem nicht existierten. Genau darin liegt das wesentliche Risiko beim Aufteilen von Links.

Der Jedi-Test: Überprüfung Ihres Modells

Um solche Probleme zu vermeiden, empfiehlt Michael die Anwendung des sogenannten Jedi-Tests (Star-Wars-Fans dürfen sich freuen!).

Der Jedi-Test ist eine einfache, aber wirkungsvolle Validierungsmethode: Versuchen Sie, den ursprünglichen Quelldatensatz aus Ihrem Data-Vault-Zielmodell exakt zu rekonstruieren. Wenn Sie die ursprünglichen Zeilen genau reproduzieren können – nicht mehr und nicht weniger –, ist Ihr Modell optimal. Entstehen dabei zusätzliche oder fehlende Zeilen, liegt ein Modellierungsproblem vor.

Dieser Test stellt sicher, dass Ihre Links korrekt modelliert sind und beim Aufteilen weder Daten verloren gehen noch inkorrekte Beziehungen entstehen.

Driving Keys und Unit of Work

Ein Szenario, bei dem das Aufteilen von Links unausweichlich zu Problemen führt, ist der Einsatz von Driving Keys. Driving Keys sind eine Teilmenge von Business Keys, die eine Beziehung eindeutig identifizieren.

Michael erläutert, dass die Aufteilung von Komponenten eines Driving Keys fast immer das Prinzip der Unit of Work verletzt. Wenn Sie einen Driving Key zerlegen, gefährden Sie die Integrität Ihrer Beziehungsdaten. Daher sollten alle Hub-Referenzen aus derselben Quelle stets gemeinsam in einem Unit-of-Work-Link innerhalb des Raw Data Vault abgebildet werden.

Er betont, dass er selbst zwar kein Verfechter von Driving Keys ist (und von einer gewissen „Hassliebe“ spricht), es jedoch Anwendungsfälle gibt, in denen sie notwendig sind. Wenn dies der Fall ist, müssen Sie zwingend darauf achten, sie nicht aufzuteilen.

Die sicherste Lösung: Links im Raw Data Vault zusammenhalten

Die bewährte Best Practice lautet: Belassen Sie alle Hub-Referenzen aus derselben Quelltabelle zusammen in einem einzigen Link – dem Unit-of-Work-Link.

Dieser Ansatz garantiert, dass die vollständige Beziehung exakt so erfasst wird, wie sie im Quellsystem vorlag. Sie können diese Beziehungen später im Business Vault jederzeit aufteilen, wenn dort Transformationen und zusätzliche Geschäftsregeln greifen. Der Raw Data Vault hingegen dient als Ihre vertrauenswürdige, unveränderliche Single Source of Truth.

Indem Sie die Unit of Work im Raw Data Vault wahren, beugen Sie Dateninkonsistenzen vor und gewährleisten, dass Sie nachgelagert jederzeit korrekte und verlässliche Datenstrukturen aufbauen können.

Was tun, wenn ein Link aufgeteilt werden muss?

Gelegentlich erfordern technische Restriktionen die Aufteilung eines Links. Beispielsweise wenn:

  • Ihr Datenbanksystem die Anzahl der Hub-Referenzen limitiert, die in einen zusammengesetzten Index aufgenommen werden können.
  • Deskriptive Daten auf unterschiedlichen Granularitätsebenen vorliegen, die einen breiten Link unpraktikabel machen.

In solchen Fällen empfiehlt Michael folgende Vorgehensweisen:

  1. Behalten Sie den Unit-of-Work-Link als Basis-Link bei.
  2. Erstellen Sie zusätzliche Links, um spezifische Granularitätsanforderungen abzubilden (z. B. Customer -> Product, Customer -> Store, etc.).
  3. Wenn Sie Links aufteilen, stellen Sie sicher, dass alle fehlenden Beziehungen ebenfalls erfasst werden. Wenn Sie beispielsweise Customer -> Store and Customer -> Product, modellieren, benötigen Sie gegebenenfalls auch Store -> Product, um das vollständige Beziehungsgeflecht zu erhalten.

Diese ergänzenden Links ermöglichen es Ihnen, den ursprünglichen Datenbestand bei Bedarf exakt wiederherzustellen, erhöhen jedoch die Systemkomplexität. Mehr Links bedeuten mehr Entitäten, mehr Joins und potenziell geringere Abfragegeschwindigkeiten. Daher betont Michael die Bedeutung eines schlanken Modells und rät dazu, Links wann immer möglich zusammenzuhalten.

Effizienzüberlegungen

Unter Performance-Gesichtspunkten führen weniger Links mit mehr Hub-Referenzen in der Regel zu schnelleren Abfragen. Sie reduzieren die Anzahl der Joins und vereinfachen das Datenmodell. Mehr Links erhöhen dagegen die Komplexität und die Fehleranfälligkeit.

Die Abwägung ist daher eindeutig: Einfachheit und Effizienz durch einen Unit-of-Work-Link stehen der Flexibilität durch zusätzliche Links gegenüber – letzteres jedoch auf Kosten höherer Komplexität und operationeller Risiken.

Fazit und Empfehlungen

Zusammenfassend gilt:

  • Halten Sie Hub-Referenzen aus derselben Quelle im Raw Data Vault stets gemeinsam in einem Unit-of-Work-Link.
  • Führen Sie den Jedi-Test durch, um auszuschließen, dass Datenbeziehungen verloren gehen oder fälschlicherweise generiert werden.
  • Müssen Links getrennt werden, dokumentieren und verwalten Sie diese sorgfältig und stellen Sie sicher, dass sämtliche notwendigen Beziehungen erhalten bleiben (auch solche, die auf den ersten Blick nicht offensichtlich sind).
  • Verlagern Sie komplexe Aufteilungen und Transformationen in den Business Vault, da Anpassungen dort vorgenommen werden können, ohne den gesamten Datensatz neu laden zu müssen.

Eine sauber strukturierte Unit of Work stellt sicher, dass Ihr Data Vault ein robustes und verlässliches Fundament für Analytics, Reporting und Data-Science-Initiativen bleibt.

Video ansehen

Echtzeit-Data-Warehousing & BI mit Data Vault 2.0 und AWS

real time data aws

Daten sind der Treibstoff der digitalen Wirtschaft. Ihr wahrer Wert entfaltet sich jedoch erst, wenn sie schnell, zuverlässig und strukturiert für Analysen und Berichte aufbereitet werden. Real-Time-Data-Streaming ermöglicht es Unternehmen, datenbasierte Entscheidungen in Echtzeit zu treffen. Data Vault 2.0 in Kombination mit AWS Kinesis bietet eine zukunftssichere Lösung für die effiziente Verarbeitung und Speicherung großer Datenmengen in modernen Data-Warehousing- und BI-Umgebungen.

Echtzeit auf AWS mit Data Vault 2.0

Nehmen Sie am 18. März 2025 um 11:00 Uhr MEZ an unserem Webinar teil und erfahren Sie, wie Sie eine skalierbare Echtzeit-Datenarchitektur auf AWS aufbauen. Wir behandeln die AWS-Infrastruktur für Echtzeitdaten, den Einsatz von Data Vault 2.0 in Echtzeitszenarien und präsentieren eine Live-Demo anhand eines praxisnahen Anwendungsfalls.

Watch Webinar Recording

Warum Real-Time-Data-Streaming für Data Warehousing und BI?

In der heutigen dynamischen Geschäftswelt ist der unmittelbare Zugriff auf präzise Daten unerlässlich, um fundierte Entscheidungen zu treffen. Traditionelle Batch-Processing-Methoden können mit dem Bedarf an Echtzeit-Insights nicht mehr Schritt halten, was häufig zu veralteten Berichten und verzögerten Reaktionszeiten führt. Real-Time-Data-Streaming löst dieses Problem durch eine kontinuierliche Datenintegration: Unternehmen können aktuelle Daten direkt beim Eintreffen analysieren und sofort darauf reagieren. Dieser Wandel steigert nicht nur die operative Effizienz, sondern stärkt auch ganzheitliche Business-Intelligence-Strategien, da stets die aktuellsten Informationen bereitstehen.

Data Vault 2.0 als Fundament für Echtzeit-Data-Warehousing

Da Unternehmen mit wachsenden Datenmengen aus verschiedensten Quellen konfrontiert sind, benötigen sie einen flexiblen und skalierbaren Ansatz für die Datenmodellierung. Data Vault 2.0 bildet die ideale Grundlage für Echtzeit-Data-Warehousing, da es eine strukturierte und zugleich anpassungsfähige Methodik bietet. Im Gegensatz zu traditionellen Datenmodellen, die oft starr und schwer zu modifizieren sind, lässt sich Data Vault 2.0 zügig an neue Anforderungen anpassen. Durch den Einsatz von Data Vault 2.0 bauen Unternehmen ein robustes, zukunftssicheres Data Warehouse auf, das Echtzeit-Datenströme mühelos verarbeitet.

AWS Kinesis: Echtzeitdaten für Ihr Data Warehouse

Die skalierbare Verarbeitung von Echtzeitdaten erfordert eine leistungsfähige Infrastruktur – genau dafür wurde AWS Kinesis entwickelt. Der Dienst ermöglicht es Unternehmen, Echtzeit-Datenströme zuverlässig zu erfassen, zu verarbeiten und zu analysieren, sodass Data Warehouses kontinuierlich auf dem neuesten Stand bleiben. Durch die Eliminierung von Datenlatenzen gewinnen Unternehmen Erkenntnisse in Echtzeit, was zu schnelleren Entscheidungen und einer höheren operativen Leistungsfähigkeit führt. Darüber hinaus lässt sich AWS Kinesis nahtlos in führende Cloud-Data-Warehouse- und BI-Lösungen wie Amazon Redshift und Snowflake integrieren. Die dynamische Skalierung gewährleistet Kosteneffizienz, indem der Ressourcenverbrauch automatisch an den tatsächlichen Bedarf angepasst wird. Fortschrittliche Sicherheitsfunktionen stellen zudem sicher, dass sensible Daten geschützt bleiben und alle regulatorischen Branchenstandards eingehalten werden.

Fazit: Zukunftssichere BI und modernes Data Warehousing mit Real-Time-Streaming

Unternehmen, die auf Echtzeit-Datenverarbeitung setzen, profitieren von schnelleren BI-Analysen, reduzierten Betriebskosten und einer höheren Skalierbarkeit. Data Vault 2.0 in Kombination mit AWS Kinesis bietet eine leistungsstarke Basis für moderne Data-Warehousing-Architekturen. Durch die nahtlose Integration von Echtzeitdaten können Unternehmen unmittelbar auf Marktveränderungen reagieren, interne Abläufe optimieren und ihre Marktposition stärken.

Die Investition in Real-Time-Data-Streaming bedeutet nicht nur mehr Geschwindigkeit, sie schafft eine widerstandsfähige und adaptive Dateninfrastruktur, die mit Ihrem Unternehmen wächst. Wer diese Technologien bereits heute nutzt, sichert sich einen entscheidenden Wettbewerbsvorteil sowie langfristigen Erfolg in einer zunehmend datengetriebenen Welt. Nutzen Sie Real-Time-Streaming für BI und schöpfen Sie das volle Potenzial Ihrer Daten aus!

Data Streaming in Snowflake

Data Streaming in Snowflake

In diesem Newsletter geben wir Ihnen einen Überblick über die Möglichkeiten des Datenstreamings mit Snowflake.

Die hier vorgestellten Ansätze konzentrieren sich darauf, wie die Funktionen und Leistungsmerkmale von Snowflake die Ingestion und Verarbeitung von Datenströmen mit hoher Geschwindigkeit ermöglichen. Ziel ist es, aufzuzeigen, wie Unternehmen sich durch die Nutzung von Echtzeitdaten einen Wettbewerbsvorteil verschaffen können, um zeitkritische Entscheidungen zu treffen, die betriebliche Effizienz zu steigern und das Kundenerlebnis zu verbessern. Darüber hinaus untersuchen wir die Architektur von Snowflake als verlässliche Lösungsgrundlage, ihre Eignung für Streaming-Workloads sowie die Herausforderungen, die sie adressiert.

Data Streaming in Snowflake

In diesem Webinar am 11. Februar 2025 um 11:00 Uhr MEZ erfahren Sie, wie Sie datengestützte Entscheidungen mithilfe der Echtzeitdaten-Funktionen von Snowflake beschleunigen können. Lernen Sie, wie Sie Batch- und Streaming-Datenpipelines vereinheitlichen, um große Datenmengen mit Snowpipe Streaming, Hybrid Tables und Dynamic Tables zu verarbeiten. Entdecken Sie, wie Sie Erkenntnisse mit geringer Latenz gewinnen und schnellere Entscheidungen treffen, ohne Ihre bestehenden Prozesse zu beeinträchtigen. Wir beleuchten Praxisbeispiele dafür, wie andere Unternehmen Echtzeitdaten für Dashboards, Customer Experiences und mehr nutzen, ergänzt durch Best Practices zur Sicherstellung von Datenqualität und Performance. Diese Session ist ideal für Data Engineers und Architekten geeignet und zeigt Ihnen, wie Snowflake Ihre Analytik revolutionieren und Sie in der dynamischen digitalen Welt von heute voranbringen kann.

Watch Webinar Recording

Was Sie erwartet

Sie erhalten einen Überblick über die verschiedenen integrierten Tools und Techniken, die Snowflake für das Real-Time-Data-Streaming bereitstellt, einschließlich der Funktionen für Dateningestion, -verarbeitung und -abfrage. Wir behandeln die Architekturkomponenten von Snowflake wie Tabellen, Views und Verarbeitungsfunktionen und untersuchen, wie diese zur Verwaltung transaktionaler Workloads eingesetzt werden.

Der Schwerpunkt dieses Beitrags liegt darauf, Einblicke zu vermitteln, wie Snowflake die Echtzeit-Datenverarbeitung ermöglicht, welche Chancen sich daraus ergeben und welche Kompromisse bei der Implementierung von Streaming-Lösungen zu berücksichtigen sind.

Echtzeitdaten – ein Überblick

Echtzeitdaten ermöglichen es Unternehmen, Informationen unmittelbar nach deren Erzeugung zu verarbeiten. Im Gegensatz zur traditionellen Batch-Verarbeitung, die in festen Intervallen erfolgt, fließen Echtzeitdaten kontinuierlich und ermöglichen so dynamische und unmittelbare Maßnahmen. Diese Form der Datenverarbeitung gewinnt für Organisationen, die in einem schnelllebigen Markt wettbewerbsfähig bleiben wollen, zunehmend an Bedeutung.

Wichtigste Merkmale von Echtzeitdaten

Echtzeitdaten weisen charakteristische Merkmale auf, die sie von anderen Datenflüssen unterscheiden:

  • Hohe Geschwindigkeit (High Velocity): Daten werden mit hoher Geschwindigkeit verarbeitet, oft innerhalb von Millisekunden oder Sekunden.
  • Geringe Latenz (Low Latency): Systeme sind darauf ausgelegt, Verzögerungen zu minimieren und einen zeitnahen Zugriff auf Erkenntnisse zu gewährleisten.
  • Dynamische Datenströme (Dynamic Streams): Kontinuierliche und oft unvorhersehbare Datenströme erfordern eine flexible und skalierbare Verarbeitung.

Jedes dieser Merkmale bringt eigene Vorteile und Herausforderungen mit sich. Aus diesem Grund benötigen Unternehmen spezialisierte Tools und Plattformen, um Echtzeitdaten effektiv zu handhaben.

Warum Echtzeitdaten wichtig sind

Der Wert von Echtzeitdaten liegt in ihrer Fähigkeit, unmittelbare Erkenntnisse zu liefern, die es Unternehmen ermöglichen, ohne Verzögerung zu handeln. Sie können verschiedene Geschäftsbereiche maßgeblich verbessern, wie etwa:

  • Verbesserte Entscheidungsfindung: Echtzeit-Erkenntnisse ermöglichen proaktive Reaktionen, wie beispielsweise die dynamische Anpassung von Preisen oder Lagerbeständen basierend auf der aktuellen Nachfrage
  • Personalisierte Customer Experience: Durch die Analyse des Nutzerverhaltens in Echtzeit können Unternehmen maßgeschneiderte Erlebnisse bieten, die den Kundenerwartungen im jeweiligen Moment entsprechen.
  • Operative Effizienz: Kontinuierliches Monitoring hilft Unternehmen dabei, Probleme frühzeitig zu erkennen und zu beheben, was Ausfallzeiten reduziert und die Performance optimiert.
  • Risiko- und Betrugserkennung (Fraud Detection): Die schnelle Identifizierung von Anomalien oder Bedrohungen verringert die Anfälligkeit für Betrug und operative Risiken.

Die Vorteile von Echtzeitdaten liegen auf der Hand; ihre Implementierung bringt jedoch spezifische Herausforderungen mit sich, die im Folgenden detailliert beschrieben werden.

Herausforderungen bei Echtzeitdaten

Obwohl die Vorteile von Echtzeitdaten beträchtlich sind, gehen sie mit einer Reihe spezifischer Herausforderungen einher:

  • Bewältigung von Geschwindigkeit und Datenvolumen: Die Verarbeitung großer Datenströme bei hoher Geschwindigkeit erfordert hochgradig skalierbare Systeme.
  • Sicherstellung der Konsistenz: Die Gewährleistung der Datengenauigkeit über verteilte Systeme hinweg kann komplex sein, insbesondere bei der Einbindung mehrerer Datenquellen.
  • Integrationskomplexität: Echtzeitdaten müssen häufig mit Batch-Systemen oder bestehenden Legacy-Analyselösungen kombiniert werden, was zusätzliche technische Komplexität mit sich bringt.

Der kontinuierliche Fluss und die Unmittelbarkeit von Echtzeitdaten machen sie unverzichtbar für Unternehmen, die in ihrer Branche eine Vorreiterrolle einnehmen wollen. Mit den richtigen Tools und der passenden Architektur können Organisationen dieses Potenzial erschließen und sich einen entscheidenden Wettbewerbsvorteil sichern.

Echtzeitdaten in Snowflake

Snowflake bietet einen modernen Ansatz für den Umgang mit Echtzeitdaten, indem es seine cloudnative Architektur mit Funktionen für die kontinuierliche Ingestion, Verarbeitung und Abfrage kombiniert. Mit nativen Tools wie Snowpipe, Streams und Tasks ermöglicht Snowflake Unternehmen die Integration von Echtzeitdaten. In diesem Abschnitt untersuchen wir, wie Snowflake Echtzeitdaten verwaltet und welche Möglichkeiten die Plattform bietet, um den Anforderungen von Streaming-Workloads gerecht zu werden.

Die Architektur von Snowflake für Echtzeitdaten

Die Architektur von Snowflake kombiniert Shared-Disk- und Shared-Nothing-Konzepte. Sie nutzt ein zentrales, cloudbasiertes Daten-Repository (die „Shared-Disk“-Komponente), während Rechenressourcen (Virtual Warehouses) unabhängig voneinander skalieren und Daten parallel verarbeiten (der „Shared-Nothing“-Aspekt).

  • Batch: Traditionell laden Data Engineers große Datenmengen mittels COPY-Befehl oder über geplante Ladevorgänge in Batches in Snowflake. Die Compute-Ebene skaliert für rechenintensive Lasten hoch und anschließend zur Kostenoptimierung wieder herunter.
  • Real Time: Die kontinuierliche Ingestion konzentriert sich auf kleine, häufig eintreffende Datenmengen. Auch hier profitiert die Architektur von der Trennung von Storage und Compute, sodass Snowflake Echtzeit-Feeds verarbeiten kann, ohne Batch-Workloads oder Analyseabfragen zu blockieren.

Micro-Partitions

Snowflake unterteilt Tabellen automatisch in Micro-Partitions – kompakte Speichereinheiten, die Daten basierend auf ihrer natürlichen Reihenfolge oder Lademustern gruppieren.

  • Batch: Micro-Partitions spielen ihre Stärken bei großen analytischen Abfragen aus, da Snowflake irrelevante Partitionen schnell ausschließen kann (Pruning), was die Performance umfangreicher Abfragen deutlich steigert.
  • Real Time: Häufige Ladevorgänge erzeugen eine größere Anzahl an Micro-Partitions. Die feingranulare Struktur bleibt zwar vorteilhaft, Sie müssen jedoch einen etwas höheren Overhead bei der Partitionsverwaltung einplanen, insbesondere dann, wenn Ihre Echtzeit-Datenströme extrem hohe Volumina erzeugen.

Dynamic Tables und Hybrid Tables

Apropos Tabellen: Die folgenden beiden Entitäten sind besonders hilfreich, wenn es um die Verarbeitung von Echtzeitdaten in Snowflake geht.

Dynamic Tables ermöglichen es Ihnen, kontinuierliche Transformationen direkt in Snowflake zu definieren. Sie ähneln Materialized Views, sind jedoch flexibler und in der Lage, komplexe Transformationen und Abhängigkeiten zu verarbeiten. Sie definieren über eine SQL-Abfrage, wie die Tabelle aufgebaut werden soll, und Snowflake verarbeitet inkrementelle Änderungen aus den Quelltabellen automatisch im Hintergrund.

  • Inkrementelle Datenverarbeitung: Anstatt Ad-hoc- oder zeitgesteuerte Jobs auszuführen, aktualisieren sich Dynamic Tables automatisch, sobald neue Daten eintreffen. Sie können einen Ziel-Lag (Target Lag) festlegen, indem Sie eine Aktualisierungsdauer angeben oder eine Downstream-Abhängigkeit definieren. Bei einer Downstream-Abhängigkeit bestimmt die letzte Dynamic Table, wann die Daten aktualisiert werden müssen.
  • Kontinuierliche Pipelines: Sie reduzieren den Bedarf an manueller Orchestrierung über Snowflake Tasks oder externe Job-Scheduler.
  • Komplexe Transformationen: Im Gegensatz zu Materialized Views (die sich meist für einfachere Aggregationen eignen) unterstützen Dynamic Tables Joins, Window-Funktionen und weitere erweiterte SQL-Operationen.


Hybrid Tables sind ein neueres Konzept, das Snowflakes spaltenbasierten Micro-Partition-Speicher mit zeilenorientierten Funktionen verbindet. Dadurch lassen sich schnelle Inserts oder Updates mit hohem Volumen einfacher durchführen. Ziel ist es, sowohl analytische (OLAP) als auch transaktionale (OLTP-ähnliche) Workloads in einer einzigen Snowflake-Umgebung zu unterstützen.

  • Schnellere Operationen auf Zeilenebene: Herkömmliche Snowflake-Tabellen können Inserts und Updates zwar in großem Umfang verarbeiten, sind jedoch primär für analytische Lesezugriffe optimiert. Hybrid Tables machen Operationen auf Zeilenebene effizienter.
  • Unterstützung gemischter Workloads (Mixed Workloads): Kombinieren Sie die Echtzeit-Ingestion von Events (die häufig zeilenbasierten Datenbanken zugeordnet wird) mit analytischen Abfragen (bei denen spaltenbasierter Speicher seine Stärken voll ausspielt).
  • Geringere Latenz: Durch die verbesserte Verarbeitung kleiner Transaktionen und häufiger Datenänderungen tragen Hybrid Tables dazu bei, die Zeitspanne zu verkürzen, bis neue Daten für Abfragen bereitstehen.

Snowpipe und Snowpipe Streaming

Snowpipe ist der kontinuierliche Dateningestion-Dienst von Snowflake, der Daten aus externen oder internen Stages lädt. Typischerweise wird Snowpipe mit einem Cloud-Speicherort (z. B. Amazon S3) verknüpft, an dem neue Dateien eingehen, und importiert diese automatisch.

  • Klassischer Batch-Betrieb: Der COPY-Befehl wird häufig in festen Intervallen ausgeführt (z. B. stündlich oder täglich), was zu Latenzen führen kann.
  • Snowpipe: Anstatt auf einen geplanten Batch-Lauf zu warten, lädt Snowpipe kleinere Datei-Inkremente automatisch kurz nach deren Eintreffen in der Stage. Dadurch verkürzt sich die Zeitspanne zwischen der Datengenerierung und der Verfügbarkeit für Abfragen.

Allerdings ist Snowpipe für das kontinuierliche Laden kleiner Dateien optimiert, man kann sich dies als Micro-Batches anstelle großer Einzeldateien vorstellen. Sollte Ihr Datenvolumen sprunghaft ansteigen, können höhere Kosten entstehen oder ein Wechsel der Ingestion-Strategie erforderlich sein, um den Durchsatz aufrechtzuerhalten.

Snowpipe Streaming ist ein API-basierter Ansatz, der Daten direkt in Snowflake-Tabellen schreibt und Zwischenspeicher vollständig umgeht. Dadurch lassen sich Latenzzeiten und Ladedauern im Vergleich zu Standard-Snowpipe noch weiter reduzieren.

Warum ist das „noch mehr Echtzeit“? Die Daten treffen sofort (oder nahezu verzögerungsfrei) in Snowflake ein und ermöglichen so ein Near-Real-Time-Reporting. Sie müssen nicht mehr warten, bis Batch-Dateien im Cloud-Speicher abgelegt werden, und der Ansatz ist bei entsprechender Skalierung oft kosteneffizienter – insbesondere bei hochfrequenten, kleinen Datenereignissen.

Zudem unterstützt der Snowflake Connector for Apache Kafka Snowpipe Streaming, was einen nahezu nahtlosen Fluss von Nachrichten aus Kafka-Topics direkt in Snowflake-Tabellen ermöglicht. Diese Integration ist ein entscheidender Schritt, um die Lücke zwischen Streaming-Datenplattformen und dem Cloud Data Warehouse von Snowflake zu schließen.

Snowflake Streams

Schließlich erfasst ein Snowflake „Stream“ Änderungen an einer Tabelle (Inserts, Updates und Deletes). Dies ist besonders nützlich für Change-Data-Capture-Workflows (CDC) und ermöglicht eine effiziente Verarbeitung von Echtzeitdaten.
Sie können Pipelines erstellen, die auf diese CDC-Streams reagieren und nachgelagerte Transformationen oder Prozesse anstoßen. Dies eignet sich ideal für Szenarien, in denen Aktualisierungen von Echtzeitdaten in transaktionale oder operative Systeme einfließen müssen.

Grenzen und Möglichkeiten von Echtzeitdaten in Snowflake

Nachdem wir einige Schlüsselfaktoren aufgeschlüsselt haben, betrachten wir nun verschiedene Grenzen und Möglichkeiten bei der Arbeit mit Snowflake und Echtzeitdaten.

Obwohl Snowflake auf eine Verarbeitung nahezu in Echtzeit (Near Real Time) abzielt, ist es nicht als Event-Processing-Engine für den Subsekundenbereich mit Ultra-Low-Latency konzipiert. Eine schnelle, kontinuierliche Ingestion kann die Kosten in die Höhe treiben, wenn Warehouse-Dimensionierung und Auto-Suspend-Einstellungen nicht sorgfältig konfiguriert sind. Jedes Warehouse und jede Streaming-Komponente kann bei häufigen Abfragen und Ladevorgängen Kosten verursachen.

Das Monitoring mehrerer Datenströme sowie deren Skalierung und Durchsatzsteuerung können komplex sein. Sie benötigen solide DevOps- und DataOps-Praktiken, um die Datenintegrität und eine gleichbleibende Performance sicherzustellen.

Auf der anderen Seite können Sie Echtzeit-Dashboards und Analysen realisieren. Mit Snowpipe Streaming und dem Kafka-Connector können Sie Daten direkt in Snowflake einspeisen und Dashboards betreiben, die sich innerhalb von Sekunden oder Minuten aktualisieren. CDC-Streams ermöglichen ereignisgesteuerte Pipelines, bei denen Änderungen in Ihren transaktionalen Datenbanken sofortige Aktionen in Snowflake auslösen – etwa nachgelagerte Transformationen oder Warnmeldungen. Die Trennung von Storage und Compute in Snowflake erleichtert den Umgang mit Lastspitzen (Spiky Workloads). Echtzeit-Pipelines können unabhängig von anderen Batch- oder Analyseaufgaben hochskaliert werden, was eine reibungslose parallele Verarbeitung gewährleistet.

Viele Unternehmen kombinieren Echtzeit-Datenströme mit traditionellen Batch-Ladevorgängen. Die Architektur von Snowflake kann beide Ansätze problemlos und ohne Konflikte parallel bedienen.

Fazit

Durch das Zusammenspiel von Hybrid Tables für zeilenbasierte Schreibzugriffe, Snowpipe Streaming für die Ingestion nahezu in Echtzeit, Snowflake Streams für die kontinuierliche Änderungserkennung und Dynamic Tables für automatisierte Transformationen können Unternehmen Echtzeit-Datenflüsse auf Basis ihrer bestehenden Batch-Architektur etablieren. Dieses Zusammenspiel der Snowflake-Funktionen eröffnet die Möglichkeit, Daten mit hoher Geschwindigkeit zu erfassen und fast unmittelbar zu verarbeiten. Dadurch erhalten Entscheidungsträger Zugriff auf Live-Metriken, können Kundeninteraktionen in Echtzeit personalisieren, operative Prozesse optimieren und Anomalien oder Betrugsfälle mit minimaler Verzögerung aufdecken. In Kombination mit der standardmäßigen Batch-Ingestion bewahrt diese Architektur historische Daten und groß angelegte Analysen und ergänzt diese um eine Schicht für latenzarme, ereignisgesteuerte Erkenntnisse.

Es gibt jedoch auch Herausforderungen und Einschränkungen zu beachten. Häufigere Schreibvorgänge können die Compute-Kosten in die Höhe treiben, insbesondere dann, wenn Daten mit unvorhersehbarem Volumen und unbeständiger Geschwindigkeit eintreffen. Die Gewährleistung konsistenter Datenmodelle wird anspruchsvoller, wenn sich Schemata schnell ändern, da Echtzeit-Pipelines mit Anpassungen in den Quellsystemen Schritt halten müssen. Hybrid Tables eignen sich zwar hervorragend für schnelle Inserts, liefern bei umfangreichen analytischen Workloads jedoch unter Umständen nicht dieselbe Abfrage-Performance wie spaltenbasierte Tabellen. Ebenso kann der Kostenaufwand für permanent aktive Streaming-Pipelines erheblich sein, wenn diese nicht sorgfältig dimensioniert und überwacht werden. Zudem steigt die Komplexität mit der Anzahl der beweglichen Teile, weshalb ein robustes DataOps- oder DevOps-Framework unerlässlich ist, um Ingestion, Transformation und Monitoring über verschiedene Verarbeitungsmodi hinweg zu steuern.

Dennoch lässt sich die Integration dieser Echtzeit-Funktionen in eine bestehende Batch-Loading-Architektur schrittweise umsetzen: indem eine dedizierte Echtzeit-Pipeline eingerichtet wird, die parallel zu den traditionellen Bulk-Loads in Snowflake einspeist. Die neue Pipeline könnte Event-Daten mittels Snowpipe Streaming erfassen und zunächst in Hybrid Tables speichern, wo Streams und Dynamic Tables Änderungen nahezu in Echtzeit verarbeiten. Historische Datenladevorgänge und rechenintensive analytische Abfragen würden weiterhin den bestehenden Batch-Ansatz mit spaltenbasierten, mikropartitionierten Tabellen nutzen. Im Laufe der Zeit können Teams beide Ansätze auf der Consumption-Ebene zusammenführen, sei es in BI-Dashboards, ML-Pipelines oder operativer Analytik, um die Unmittelbarkeit von Echtzeitdaten mit der Tiefe historischer Kontexte zu verbinden und das alles innerhalb desselben Snowflake-Ökosystems.

Inkrementelle Microbatch-Modelle: Ein neuer Ansatz für große Datenmengen

Was ist Microbatch?

Microbatch ist eine innovative inkrementelle Strategie, die speziell für große Zeitreihendatensätze entwickelt wurde. Eingeführt in dbt Core Version 1.9 (derzeit in der Beta-Phase), ergänzt sie bestehende inkrementelle Strategien um eine strukturierte und effiziente Methode zur schrittweisen Datenverarbeitung in Batches.


Zu den wichtigsten Merkmalen von Microbatch gehören:

  • Verwendung einer Zeitspalte zur Definition von Batch-Bereichen.
  • Unterstützung bei der erneuten Verarbeitung fehlgeschlagener Batches.
  • Automatische Erkennung paralleler Batches.
  • Verzicht auf komplexe bedingte Logik für das Backfilling.

Diese Strategie eignet sich jedoch nicht für Datensätze, denen eine verlässliche Zeitspalte fehlt oder die eine besonders feinkörnige Kontrolle über die Verarbeitungslogik erfordern.

Wie Microbatches funktionieren

Microbatching funktioniert, indem die Modellverarbeitung auf Basis folgender Parameter in mehrere Abfragen (Batches) aufgeteilt wird:

  • event_time: Die Zeitspalte, die die Batch-Bereiche definiert.
  • batch_size: Das Zeitintervall für jeden Batch (hour, day [Standard], month, yea

Jeder Batch fungiert als unabhängige, atomare Einheit, was Folgendes bedeutet:

  • Batches können individuell verarbeitet, wiederholt oder ersetzt werden.
  • Die parallele Ausführung ermöglicht eine separate, idempotente Batch-Verarbeitung.

Die Strategien zum Ersetzen von Batches variieren je nach Datenbank-Adapter:

  • Postgres: Verwendet.merge
  • BigQuery und Spark: Verwenden insert_overwrite.
  • Databricks: Verwendet replace_where.
  • Redshift und Snowflake: Verwenden delete + insert.

Konfiguration von Microbatch-Modellen

Bei der Einrichtung eines Microbatch-Modells sind folgende Konfigurationen erforderlich:

  • event_time: Gibt die Zeitspalte in UTC an.
  • batch_size: Definiert die Batch-Granularität (hour, day, month, year).
  • begin: Legt den Startzeitpunkt für initiale Builds oder vollständige Aktualisierungen (Full Refreshes) fest.

Zu den optionalen Konfigurationen gehören:

  • lookback: Verarbeitet vorherige Batches erneut, um verspätet eintreffende Datensätze zu erfassen.
  • concurrent_batches: Steuert die parallele Ausführung (wird standardmäßig automatisch erkannt).

Parallele Ausführung von Batches

Die parallele Ausführung wird basierend auf den Batch-Bedingungen und der Adapter-Unterstützung automatisch erkannt. Sie können dieses Verhalten jedoch über die Einstellung concurrent_batches concurrent_batches manuell anpassen.

Eine parallele Ausführung ist möglich, wenn:

  • Der Batch weder der erste noch der letzte in der Reihenfolge ist,
  • Der jeweilige Datenbank-Adapter die parallele Ausführung unterstützt,
  • Die Modelllogik nicht von einer festgelegten Ausführungsreihenfolge abhängt.

Wie Sie Daten nachladen (Backfilling)

Backfilling ermöglicht die erneute Verarbeitung historischer Daten innerhalb eines festgelegten Zeitraums über folgenden Befehl:

dbt run --event-time-start "2025-02-01" --event-time-end "2025-02-03"

Dadurch wird sichergestellt, dass ausschließlich Batches innerhalb des definierten Zeitfensters unabhängig voneinander verarbeitet werden.

Microbatch im Vergleich zu anderen inkrementellen Strategien

Microbatch unterscheidet sich von traditionellen inkrementellen Strategien durch:

  • Die Verwendung voneinander unabhängiger Abfragen für zeitbasierte Batches,
  • Den Verzicht auf is_incremental() und komplexe SQL-Logik,
  • Die automatische Auswahl der effizientesten Operation (insert, update, replace) für die jeweilige Plattform.

Fazit

Microbatch ist ein leistungsstarker neuer Ansatz für die inkrementelle Datenverarbeitung in dbt Core. Indem große Datenmengen in überschaubare, parallelisierbare Einheiten unterteilt werden, vereinfacht dieser Ansatz die Datenmodellierung und steigert gleichzeitig die Effizienz sowie Skalierbarkeit. Vor der Implementierung sollten Sie jedoch genau prüfen, ob Microbatch den spezifischen Anforderungen Ihrer Datenpipeline entspricht.

Watch the Video

Modellierung von Salesforce-History-Tabellen in Data Vault

Modellierung von Salesforce-History-Tabellen

Salesforce erfasst Änderungen an konfigurierten Attributen in sogenannten History-Tabellen. Diese Daten – darunter Record-ID, Feldname, vorheriger und neuer Wert sowie der Zeitstempel – stellen eine besondere Herausforderung für die Data-Vault-Modellierung dar. In diesem Artikel untersuchen wir, wie sich diese Daten unter Berücksichtigung der Data-Vault-Prinzipien optimal modellieren lassen.


Salesforce-History-Tabellen verstehen

Salesforce ermöglicht die Nachverfolgung bestimmter Attributänderungen innerhalb von Objekten wie Contacts. Diese Änderungen werden in History-Tabellen wie beispielsweise ContactHistory gespeichert. Jeder Eintrag protokolliert:

  • Record-ID (z. B. Contact-ID)
  • Feldname
  • Alter Wert
  • Neuer Wert
  • Zeitstempel

Herausforderungen bei der Modellierung von Salesforce-Historiedaten

Bei der Entwicklung eines Data-Vault-Modells für diese Historiedaten gilt es zentrale Herausforderungen zu beachten:

  • Verarbeitung mehrerer Änderungen desselben Datensatzes innerhalb eines kurzen Zeitraums
  • Gewährleistung der referenziellen Integrität
  • Effizientes Abfragen und Pivotieren von Daten für das Reporting

Ansatz: Multi-Active-Satellite

Ein gängiger erster Ansatz besteht darin, die History-Tabelle als Multi-Active-Satellite an einen Contact-Hub anzubinden, wobei der Feldname als Dependent-Key dient. Dieser Ansatz birgt jedoch Fallstricke:

  • Duplikate können entstehen, wenn mehrere Änderungen desselben Feldes innerhalb desselben Batches auftreten
  • Auf Zeitstempeln basierende Schlüssel sind unzuverlässig, da identische Zeitstempel vorkommen können

Um dem entgegenzuwirken, sollte in der Staging-Area eine eindeutige Sequenznummer vergeben und als Dependent-Key genutzt werden.

Optimierter Ansatz: Non-Historized-Link

Anstelle eines Multi-Active-Satellites kann ein Non-Historized-Link genutzt werden, um Salesforce-Historiedaten effizienter zu modellieren. So funktioniert es:

  • Erstellen Sie einen Non-Historized-Link, der den Contact-Hub und den User-Hub verbindet.
  • Speichern Sie änderungsbezogene Attribute (Feldname, alter Wert, neuer Wert, Zeitstempel) direkt in diesem Link.
  • Verwenden Sie den Zeitstempel als ereignisbasiertes Attribut und nicht als Teil des Primary-Keys.

Dieser Ansatz vermeidet komplexe Joins und vereinfacht die Abfragen spürbar.

Effizienter Datenabruf: Pivoting

Da History-Tabellen in einem Key-Value-Format strukturiert sind, erfordern Abfragen häufig ein Pivoting. Durch den Einsatz nativer Pivot-Funktionen der Datenbank lassen sich die Daten ohne übermäßige Joins in ein Format überführen, das für das Reporting optimal nutzbar ist.

Alternative Überlegung: JSON-Speicherung

Ein weiterer Ansatz besteht darin, Änderungsdaten als JSON-Objekt in einem Standard-Satellite zu speichern. Diese Methode bietet Flexibilität, insbesondere bei einer großen Anzahl von Attributen. Allerdings verkompliziert sie Abfragen und sollte nur dann eingesetzt werden, wenn es technisch zwingend erforderlich ist.

Fazit

In den meisten Fällen ist ein Non-Historized-Link die optimale Lösung, um Salesforce-History-Tabellen im Data Vault zu modellieren. Er vereinfacht die Datenspeicherung, reduziert den Bedarf an aufwendigen Joins und verbessert die Abfrageleistung. Multi-Active-Satellites stellen eine Alternative dar, erfordern jedoch einen sorgfältigen Umgang mit doppelten Zeitstempeln und wiederholten Feldänderungen.

Watch the Video

Flow.BI: Generierung des Raw Data Vaults mittels KI und dbt

Flow.Bi architecture Data Warehouse

Raw Data Vault

Diese Frage ist vielleicht so alt wie Data Vault selbst: Kann eine künstliche Intelligenz (KI) den Raw Data Vault generieren? Bis vor Kurzem war die vorherrschende Erwartung in der Branche, dass eine KI – sofern sie überhaupt existiert – bestenfalls Datenmodellierer unterstützen könnte, beispielsweise durch das Identifizieren und Vorschlagen von Business Keys oder das Gestalten einzelner Modellbereiche.

Die Frage entsteht aus einer Notwendigkeit: In der Vergangenheit sind Datenvolumen und Datenvielfalt exponentiell gewachsen. Es gibt keine Anzeichen dafür, dass sich dieses Wachstum in Zukunft verlangsamen wird. Aber wer soll all die Daten analysieren, die für heutige Datenplattformen benötigt werden? Es herrscht bereits ein Mangel an qualifizierten Data Engineers. Diese Situation wird sich in Zukunft weiter verschärfen, da die Zahl der Studierenden an den Universitäten nicht im gleichen Maße steigt.

Generierung des Raw Data Vaults mit Flow.BI und dbt

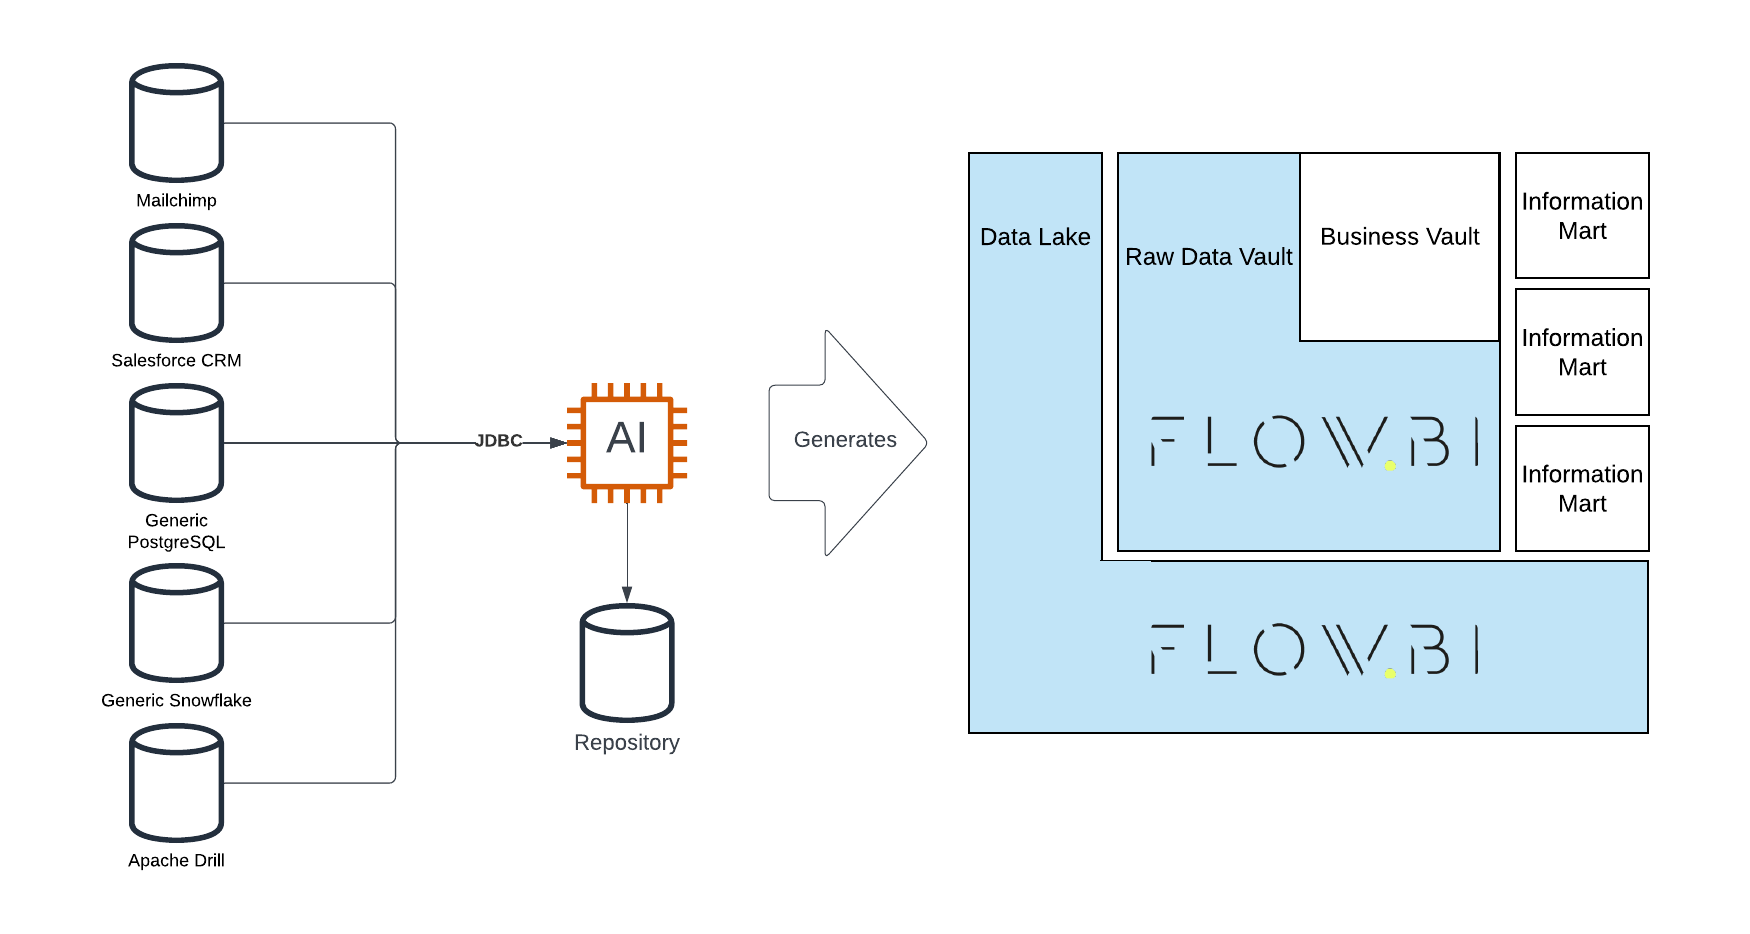
Wir stellen die Integration zwischen datavault4dbt und Flow.BI vor, die zur Generierung des Raw Data Vaults eingesetzt wird. Flow.BI ist eine künstliche Intelligenz, die in der Lage ist, alle Hubs, Links und Satellites für Unternehmensdaten zu definieren. Dies umfasst die Bestimmung der Business Keys und spezieller Entitätstypen wie Effectivity Satellites, Hierarchical Links, Multi-Active Satellites, Non-Historized Links und Reference Tables. Die Arbeitsteilung ist einfach: Die fortschrittliche KI von Flow.BI definiert den Raw Data Vault mit allen erforderlichen Entitäten, und datavault4dbt generiert den Code – einschließlich der CREATE-TABLE- und INSERT-INTO-Statements sowohl für das Modell als auch für die Ladeprozesse des Raw Data Vaults.

Watch Webinar Recording

Erwartungen übertroffen mit generativer KI

Mit dem Release von Flow.BI wurde die Erwartung übertroffen, dass nur eine unterstützende KI möglich sei. Flow.BI ist eine generative KI, die den Raw Data Vault vollständig definiert, einschließlich:

  • Hubs und ihrer Business Keys
  • Links, einschließlich Hierarchical Links
  • Satellites, einschließlich der Satellite-Splits für Datenschutz, Sicherheit und Rate-of-Change
  • Non-Historized Links und ihrer Satellites
  • Effectivity Satellites und Multi-Active Satellites
  • Reference Hubs und ihrer Satellites

Meistern Sie dbt für skalierbare Datenplattformen

Neben der Modellstruktur legt die fortschrittliche KI von Flow.BI auch die Ladedefinitionen fest, das heißt die Vorgabe, woher der Business Key eines Hubs oder das Attribut eines Satelliten geladen wird. Dies wird später genutzt, um die INSERT-INTO-Statements zu generieren.

Da all dies automatisiert durch die KI erledigt wird, funktioniert der Prozess auch in großem Maßstab und kann schnell Raw-Data-Vault-Modelle mit Tausenden von Entitäten generieren.

Vereinfachte Modellierung mit Flow.BI

Flow.BI vereinfacht den Modellierungsansatz drastisch: Alles, was Sie als Anwender tun müssen, ist, Datenquellen für die Analyse und das Profiling an Flow.BI anzubinden und den Prozess zu starten. Flow.BI definiert daraufhin mindestens ein gültiges Modell. Um dies zu erreichen, identifiziert die Lösung zuerst die Konzepte in den Entitäten der Datenquellen und anschließend die Business Keys für diese Konzepte. Als Nächstes identifiziert sie die Beziehungen und verarbeitet die beschreibenden Datenattribute in Satellites. Für den letzten Feinschliff fügt der integrierte Natural Language Generator die Dokumentation, Attribute und Ladedefinitionen der Entitäten hinzu.

Anwender können das Zielmodell weiter verfeinern, indem sie die identifizierten Konzepte sowie die Regeln für Datenschutz, Sicherheit und Satellite-Splits anpassen.

Ein datengetriebener Ansatz

Das von Flow.BI definierte Modell folgt einem datengetriebenen Ansatz und entspricht damit der Lehre der Data-Vault-Schulungen von Scalefree.

Bei einem datengetriebenen Ansatz bildet das Data-Vault-Modell die Rohdaten so ab, wie der Fachbereich sie nutzt. Das bedeutet: Der Fokus liegt klar auf den Rohdaten, während Business Keys die Daten über mehrere Datenquellen hinweg integrieren.

Die Idee dahinter ist, dass Business Keys häufig gemeinsam genutzte Schlüssel sind, die in mehreren Quellsystemen existieren und sich daher ideal für Integrationszwecke eignen.

Raw Data Vault vs. Business-Logik

Business-Logik wie WHERE-Bedingungen oder bedingte Logik hat in einem datengetriebenen Raw Data Vault keinen Platz. Ziel des Business Vaults ist es, den Raw Data Vault um genau diese Business-Logik zu erweitern.

Daher enthält das definierte Modell keinerlei Business-Logik, da diese erst später im Business Vault ergänzt wird. Dennoch ist das Raw-Data-Vault-Modell ein integriertes Unternehmensdatenmodell, das sich über alle angebundenen Datenquellen erstreckt.

Metadaten für fortgeschrittenes Data Warehousing

Die von Flow.BI erzeugten Metadaten können nicht nur für die Generierung des Raw Data Vaults verwendet werden, sondern auch für die Staging Area – sei es auf einer relationalen Datenbank oder in einem Data Lake.

Flow.BI generiert den Raw Data Vault nicht eigenständig physisch, sondern definiert ihn logisch. Das bedeutet, es gibt an, welche Hubs, Links und Satellites existieren sollten, um die Daten aus den Quellsystemen zu erfassen. Es erzeugt jedoch nicht direkt die CREATE-TABLE- und INSERT-INTO-Statements für das physische Modell. Stattdessen greift es auf Tools wie dbt über das Paket datavault4dbt zurück, um den Code zu generieren. Flow.BI übergibt die Metadaten des definierten Modells, und datavault4dbt erzeugt den eigentlichen Code.

In diesem Sinne agiert Flow.BI wie ein virtuelles Teammitglied, das die Datenquellen analysiert, profiliert, den Raw Data Vault modelliert und die Metadaten direkt in die SQL-Modelle von dbt einspeist.

Volle Kontrolle der Anwender über die KI-Modellierung

Flow.BI ahmt die Arbeitsweise menschlicher Datenmodellierer nach.

Bedeutet dies jedoch, dass Anwender die Kontrolle an die KI abgeben? Nein. Es gibt viele Möglichkeiten, die KI von Flow.BI zu steuern, um ein optimales Zielmodell zu erstellen. Doch zunächst sollte definiert werden, was ein besseres Modell ausmacht: Weniger Entitäten im Zielmodell? Schnellere Abfragen? Schnelleres Laden? Je nach Zielsetzung kann Flow.BI beispielsweise über die Klassifizierung von Konzepten und die Art der Datenbereitstellung gezielt beeinflusst werden.

Integration mit Data Warehouse Automation

Sobald die Metadaten für den Raw Data Vault definiert sind, werden sie an die Data-Warehouse-Automation-Lösung (DWA) übergeben. Eine der beliebtesten Optionen hierfür ist dbt. Scalefree hat das Open-Source-dbt-Paket datavault4dbt entwickelt, das sich in der Branche wachsender Beliebtheit erfreut.

Um SQL-Modelle für das dbt-Paket zu generieren, nutzt die Integration zwischen Flow.BI und datavault4dbt TurboVault, ein weiteres Open-Source-Paket von Scalefree. TurboVault bietet eine grafische Benutzeroberfläche, die die Metadaten für einen mit datavault4dbt zu generierenden Raw Data Vault aufbereitet.

Sobald die Metadaten für den Raw Data Vault definiert sind, werden sie an die Data-Warehouse-Automation-Lösung (DWA) übergeben. Eine der beliebtesten Optionen hierfür ist dbt. Scalefree hat das Open-Source-dbt-Paket datavault4dbt entwickelt, das sich in der Branche wachsender Beliebtheit erfreut.

Um SQL-Modelle für das dbt-Paket zu generieren, nutzt die Integration zwischen Flow.BI und datavault4dbt TurboVault, ein weiteres Open-Source-Paket von Scalefree. TurboVault bietet eine grafische Benutzeroberfläche, die die Metadaten für einen mit datavault4dbt zu generierenden Raw Data Vault aufbereitet.

Die optimale Lösung besteht darin, die Metadaten von Flow.BI in TurboVault einzuspeisen, um dessen Funktionen voll auszuschöpfen. Sobald die Metadaten geladen sind, generiert TurboVault die SQL-Modelle für datavault4dbt, welches wiederum die Data-Vault-Entitäten und die Ladeprozesse erzeugt.

Um die Integration zwischen Flow.BI und TurboVault zu erleichtern, hat Scalefree einen dedizierten Flow.BI-Konnektor veröffentlicht, der die logischen Datenmodelle aus Flow.BI abruft, transformiert und die automatisierte Generierung Ihres Data Vaults ermöglicht.

Mehrwert von Flow.BI

Flow.BI bietet vielschichtige Vorteile: Zunächst den Kostenvorteil. Die Definition des Modells mithilfe von KI ist weitaus kosteneffizienter als das manuelle Erstellen der Metadaten für datavault4dbt. Zudem sind erfahrene Data-Vault-Experten eine seltene und schwer verfügbare Ressource insbesondere wenn hohe Qualität gefordert ist, was bei Unternehmensdaten stets der Fall sein sollte.

Ein weiterer Vorteil von Flow.BI ist die Agilität: Statt den Raw Data Vault über Monate oder Jahre hinweg manuell zu definieren, berechnet die fortschrittliche KI von Flow.BI das Raw-Data-Vault-Modell innerhalb von Minuten oder wenigen Stunden.

Dies reduziert auch das Projektrisiko erheblich: Bei manuellen Ansätzen besteht das Risiko, nach jahrelanger Arbeit und hohen Investitionen ein unzureichendes Modell zu erhalten. Ein kompletter Neuanfang ist dann meist unrealistisch.

Mit Flow.BI liegen die Ergebnisse hingegen nahezu unverzüglich vor. Sollten Anpassungen nötig sein, können diese direkt vorgenommen werden, oder es steht weiterhin die manuelle Feinjustierung zur Verfügung.

Der beste Schritt für den Einstieg ist daher ein gemeinsamer Proof of Concept oder ein Workshop zu Flow.BI. Contactieren Sie uns gerne für nähere Informationen.

AI Act im Fokus: Verantwortungsvolle KI für Ihr Unternehmen sicherstellen

AI Act Business Intelligence Architecture graphic

AI Act

Das Gesetz über künstliche Intelligenz (AI Act) ist seit dem 1. August 2024 in Kraft und wird schrittweise wirksam. Als neuer rechtlicher Meilenstein bringt der AI Act verbindliche Anforderungen an den Einsatz künstlicher Intelligenz in Unternehmen mit sich, um die verantwortungsvolle Entwicklung und Nutzung dieser Technologie in der EU zu fördern. Doch anstatt im risikobasierten Ansatz des AI Act nur Hürden zu sehen, eröffnet er Unternehmen auch vielfältige Chancen für eine zukunftsorientierte KI-Strategie.

In unserem Newsletter werfen wir einen ersten Blick auf den neuen rechtlichen Rahmen und dessen Bedeutung für Ihr Unternehmen. Zudem zeigen wir, wie Unternehmen gesetzliche Compliance strategisch nutzen können, um sich einen Wettbewerbsvorteil zu verschaffen und innovative Geschäftsmodelle voranzutreiben.

AI Act im Fokus: Verantwortungsvolle KI für Ihr Unternehmen sicherstellen

Der AI Act der EU ist da! Erfahren Sie, wie sich diese wegweisende Regulierung auf Ihr Unternehmen auswirkt. Wir analysieren den risikobasierten Ansatz für KI-Systeme mit Fokus auf Hochrisiko-Anwendungen und Compliance-Anforderungen. Entdecken Sie praktische Schritte zur Gewährleistung von Transparenz und erfahren Sie, wie Sie Tools wie AI-Marts für eine effektive AI-Governance nutzen können.

Watch Webinar Recording

Was ist der AI Act und warum sollten Sie sich dafür interessieren?

Der AI Act zielt darauf ab, die Nutzung künstlicher Intelligenz innerhalb der EU sicherer und vertrauenswürdiger zu machen, indem klare Regeln für die Entwicklung und den Einsatz von KI-Systemen geschaffen werden. Im Mittelpunkt stehen dabei der Schutz von Grundrechten, Gesundheit und Sicherheit. Der rechtliche Rahmen basiert auf einem risikobasierten Ansatz: KI-Anwendungen werden je nach ihrem Gefährdungspotenzial für die Gesellschaft in vier verschiedene Kategorien eingeteilt, von minimalen bis hin zu inakzeptablen Risiken. Konkret sieht der AI Act folgende Kategorien vor:

  1. Inakzeptables Risiko: KI-Systeme, die eine Bedrohung für Grundrechte oder die Sicherheit darstellen – wie etwa Systeme für Social Scoring oder manipulative Praktiken, sind verboten.
  2. Hohes Risiko: Diese Systeme sind streng reguliert und umfassen Anwendungen in kritischen Bereichen wie biometrische Identifizierung, Gesundheitswesen, Verkehr, Bildung und Beschäftigung. Unternehmen, die Hochrisiko-KI einsetzen, müssen strenge Compliance-Standards erfüllen.
  3. Begrenztes Risiko: Diese Systeme unterliegen weniger Einschränkungen, müssen jedoch Transparenzanforderungen einhalten. Beispielsweise müssen Chatbots die Nutzer darüber informieren, dass sie mit einer KI interagieren.
  4. Minimales oder kein Risiko: Die am wenigsten regulierte Kategorie umfasst KI-Anwendungen wie Spam-Filter oder KI-gestützte Videospiele.

Der AI Act ist für Unternehmen von großer Bedeutung, da die neuen Anforderungen nicht nur Compliance-Pflichten mit sich bringen, sondern auch Chancen eröffnen, Wettbewerbsvorteile zu erzielen.

Durch die frühzeitige Anpassung an die gesetzlichen Vorgaben können Unternehmen das Vertrauen von Kunden und Partnern stärken, Risiken minimieren und Innovationen verantwortungsvoll vorantreiben. Ein fundiertes Verständnis der Regulierung ermöglicht es ihnen, den rechtlichen Rahmen strategisch zu nutzen und sich im internationalen Vergleich besser zu positionieren.

Für Unternehmen, die in der EU oder mit EU-Partnern tätig sind, wird die Einhaltung des AI Act daher ein entscheidender Faktor sein. Eine Nichteinhaltung kann erhebliche Strafen nach sich ziehen bis zu 7 % des weltweiten Jahresumsatzes oder 35 Millionen Euro, je nachdem, welcher Betrag höher ist.

Da die Gesetzgebung schrittweise greift, empfiehlt es sich für Unternehmen, im ersten Schritt ihre KI-Tools zu überprüfen und zu analysieren, wie diese Systeme im neuen Rahmenwerk klassifiziert und reguliert werden, um die erforderlichen Pflichten rechtzeitig umzusetzen.

Erfüllen Sie die Anforderungen des AI Act schon heute!

Die Vorbereitung auf den AI Act erfordert ein proaktives und ganzheitliches Vorgehen. Stellen Sie Compliance sicher, minimieren Sie Risiken und schaffen Sie Vertrauen in Ihre KI-Anwendungen.

Get My Free Checklist

Aus Sicht des Data Warehousing: Wie kann ein AI-Mart helfen?

Während sich Unternehmen darauf vorbereiten, die Anforderungen des AI Act der Europäischen Union zu erfüllen, ist es von entscheidender Bedeutung sicherzustellen, dass Daten und KI-Systeme den neuen Vorschriften entsprechen. Zentral hierbei sind die Konzepte von Data-Governance und Traceability (Rückverfolgbarkeit), insbesondere für KI-Modelle, die als Hochrisiko-Systeme eingestuft sind. Ein modernes Data Warehouse (DWH), insbesondere auf Basis von Data Vault 2.0, in Kombination mit einem spezialisierten AI-Mart, kann das notwendige technische Fundament für die Compliance bieten: Es verwaltet den Datenlebenszyklus, gewährleistet transparente Prozesse und protokolliert alle Aktivitäten von KI-Modellen lückenlos. Data Vault 2.0 bietet hierfür zahlreiche Vorteile: Es unterstützt agile Entwicklung, wodurch rasche Anpassungen an neue Geschäftsanforderungen ermöglicht werden; es gewährleistet Skalierbarkeit für die nahtlose Verarbeitung wachsender Datenmengen; und es bietet durch seine Architektur eine lückenlose Historisierung (Historical Tracking), was Audits und die Überprüfung der Compliance erheblich erleichtert.

Im Kontext von KI ist das AI-Mart ein spezialisiertes Data Mart innerhalb eines DWH, das gezielt auf die Verwaltung von KI-Trainingsdaten ausgerichtet ist. Sein Zweck ist es, eine strukturierte und regelkonforme Umgebung für die Speicherung und Kuratierung von Datensätzen bereitzustellen, die zum Trainieren, Validieren und Testen von KI-Modellen verwendet werden. Im Gegensatz zu einem traditionellen Data Mart verfügt das AI-Mart über speziell auf KI zugeschnittene Funktionen wie erweiterte Metadaten, Tracking und die Dokumentation des Modelltrainings.

Kernfunktionen eines AI-Marts

  1. Data Curation für das KI-Training: Das AI-Mart speichert Daten, die speziell für das Training von KI-Modellen kuratiert wurden, und stellt sicher, dass alle Datensätze bereinigt, unverzerrt (unbiased) und von hoher Qualität sind. Integrierte Data-Governance-Regeln stellen sicher, dass nur validierte Daten in das Mart gelangen. Dies gewährleistet die Einhaltung der Anforderungen des AI Act für Hochrisiko-KI-Systeme, bei denen Daten vertrauenswürdig, präzise und frei von Verzerrungen sein müssen.
  2. Metadaten und Dokumentation: Das AI-Mart speichert Metadaten zu jedem Datensatz, einschließlich dessen Quelle, angewendeter Transformationen und dessen Verwendung in spezifischen KI-Modellen. Diese Metadaten sind unerlässlich für die Traceability und stellen sicher, dass jeder in einem KI-Modell verwendete Datenpunkt bis zu seinem Ursprung zurückverfolgt und alle Änderungen dokumentiert werden können.
  3. Data Versioning und Data Lineage: Bei KI-Anwendungen ist es entscheidend sicherzustellen, dass Modelle aktuelle und verlässliche Daten nutzen. Das AI-Mart unterstützt Data Versioning, sodass Teams mehrere Versionen von Datensätzen verwalten und Änderungen im Zeitverlauf nachvollziehen können. Das Data-Lineage-Tracking stellt sicher, dass der gesamte Lebenszyklus der Daten – von der Ingestion bis zur Nutzung in KI-Modellen – vollständig nachvollziehbar ist, und liefert den für die Einhaltung des AI Act erforderlichen, umfassenden Audit-Trail.

Aus diesem Grund ist ein robustes Data-Governance-Framework entscheidend für die Einhaltung des AI Act. Durch die Integration eines Data Warehouse (DWH) mit einem AI-Mart können Unternehmen strenge Governance-Maßnahmen etablieren, die die Qualität und Verlässlichkeit von KI-Trainingsdaten sicherstellen. So prüfen beispielsweise automatisierte Validierungs-Pipelines innerhalb des DWH, dass nur Daten verwendet werden, die vordefinierten Qualitätsstandards entsprechen, wodurch Fehler, Verzerrungen (Biases) und unvollständige Informationen minimiert werden. Dies ist besonders wichtig für Hochrisiko-KI-Anwendungen, wie etwa in der biometrischen Identifizierung oder im Gesundheitswesen, wo eine mangelhafte Datenqualität zu schädlichen oder ungenauen Ergebnissen führen könnte.

Um die Vorgaben des AI Act zu erfüllen, müssen Unternehmen die Rückverfolgbarkeit in ihren KI-Systemen sicherstellen, indem sie zentrale Phasen des KI-Prozesses, von der Datenaufbereitung bis zur Modellnutzung nachverfolgen und dokumentieren. Die Integration von KI-Modell-Logs in ein Data Warehouse (DWH) spielt hierbei eine zentrale Rolle und bietet ein zentralisiertes System zur Überwachung und Speicherung kritischer Informationen über die Funktionsweise von KI-Modellen und deren Interaktion mit Daten.

AI Act Business Intelligence Architecture graphic

Protokollierung von KI-Entscheidungen und -Outputs: Jedes Mal, wenn ein KI-Modell Daten verarbeitet, sollten automatisch Logs generiert und im DWH gespeichert werden. Diese Protokolle erfassen wesentliche Details wie Eingabedaten, Feature-Transformationen, Modellparameter, Entscheidungsschwellenwerte und Ausgabewahrscheinlichkeiten. Durch das Laden dieser Logs in das DWH schaffen Unternehmen einen detaillierten Audit-Trail der KI-Aktivitäten und stellen sicher, dass zentrale Aspekte der Modelloperationen dokumentiert sind.

Log-Aggregation und -Speicherung: Protokolle von KI-Modellen sowohl während des Trainings als auch im Produktivbetrieb können als Teil der AI-Mart-Infrastruktur kontinuierlich in das DWH eingespeist werden. Diese Logs können Folgendes umfassen:

  • Modelltrainings-Logs: Dokumentation darüber, wie das Modell trainiert wurde, welche Datensätze verwendet und welche Parameter während des Trainings angepasst wurden.
  • Modellinferenz-Logs: Erfassung der Eingabedaten, der generierten Features und jeder vom Modell getroffenen Vorhersage.
  • Performance-Metriken: Speicherung von Evaluierungsmetriken wie Accuracy, Precision und Recall, die dabei helfen, die Leistung des Modells im Zeitverlauf zu überwachen und Model Drift frühzeitig zu erkennen.

Durch die Speicherung dieser Logs im DWH können Unternehmen detaillierte Aufzeichnungen über die Operationen von KI-Modellen für regulatorische Zwecke führen.

Abfrage und Auditierung von Logs: Die Abfragewerkzeuge des DWH ermöglichen es Compliance-Teams, Berichte zu erstellen, die zeigen, wie Modelle arbeiten, welche Daten verwendet wurden und wie sich das KI-Modell entwickelt hat. Dies vereinfacht die Reaktion auf behördliche Audits und belegt die Einhaltung der Anforderungen des AI Act.

Durch die Kombination eines DWH mit einem AI-Mart für KI-Trainingsdaten und das Laden von KI-Modell-Logs in dieselbe Infrastruktur können Unternehmen ein umfassendes Framework für die AI-Act-Compliance aufbauen. Dieser Ansatz unterstützt Data-Governance zur Sicherstellung qualitativ hochwertiger Daten für KI-Modelle und gewährleistet Traceability, sodass Unternehmen jeden Aspekt ihrer KI-Systeme nachverfolgen und auditieren können. Dies erfüllt nicht nur regulatorische Vorgaben, sondern stärkt auch das Vertrauen und die Nachvollziehbarkeit beim Einsatz von KI-Technologien.

Kommende Ressourcen und Events

Für weitere Informationen kontaktieren Sie unser Team unter: [email protected].

Abschließende Bemerkungen der Autoren

Der AI Act sollte nicht nur als regulatorische Herausforderung verstanden werden, sondern auch als Chance für Unternehmen, sich durch vertrauenswürdige und ethische KI-Praktiken zu differenzieren. Während sich künstliche Intelligenz kontinuierlich weiterentwickelt, werden Unternehmen, die Compliance, Transparenz und menschliche Aufsicht priorisieren, in den kommenden Jahren deutlich besser aufgestellt sein. Indem Unternehmen jetzt proaktiv Maßnahmen ergreifen, um die Compliance zu sichern, können sie die KI-Regulierung in einen strategischen Wettbewerbsvorteil verwandeln und nachhaltig Vertrauen bei Kunden, Partnern sowie Aufsichtsbehörden aufbauen.

Snapshot-basierte Bridge Table für Link und Effectivity Satellite

Watch the Video

Snapshot-basierte Bridge Table für Link und Effectivity Satellite

Willkommen zu einer weiteren Ausgabe von Data Vault Friday! Heute widmen wir uns dem Konzept einer snapshot-basierten Bridge Table und konzentrieren uns dabei insbesondere auf deren Einsatz in Szenarien mit Links und Effectivity Satellites. Dieser Ansatz hilft uns, komplexe Beziehungen zwischen Business Objects im Zeitverlauf zu verwalten, Beziehungsänderungen nachzuvollziehen und eine lückenlose historische Sicht zu bewahren. In diesem Artikel untersuchen wir Lösungen für drei zentrale Fragen:

  • Wie mit einer Beziehung umzugehen ist, die an Tag 2 im Vergleich zu Tag 1 entfällt
  • Wie geänderte Beziehungen zwischen Tag 1 und Tag 2 für denselben Key verwaltet werden
  • Wie sich ein Business Object (A3) an Tag 2 einbinden lässt, wenn keine Beziehung zu einem Objekt in B besteht


Das Data-Vault-Modellierungsbeispiel verstehen

In unserem Beispiel nutzen wir zwei Quellen, die jeweils ein anderes Business Object (A und B) repräsentieren. Business Object A liegt als statischer Datensatz vor, während Business Object B über drei Tage hinweg dynamische Beziehungen zu A aufweist. Jeder Tag bringt Änderungen in diesen Beziehungen mit sich, wobei einzelne Einträge wegfallen oder sich verschieben. Unsere Aufgabe besteht darin, diese Änderungen effizient in einer snapshot-basierten Bridge Table abzubilden.

Untersuchung der Beziehungsänderungen

Gehen wir die über drei Tage hinweg beobachteten Änderungen im Detail durch:

  • Tag 1: B1 steht in Beziehung zu A1, B2 zu A2 und B3 zu A3.
  • Tag 2: Die Beziehungen ändern sich. B1 steht nun in Beziehung zu A2, B2 zu A1 und B3 entfällt.
  • Tag 3: Im Vergleich zu Tag 2 treten keine weiteren Änderungen auf.

Unser Ziel ist es, diese Beziehungen mithilfe eines Effectivity Satellites und einer Bridge Table so zu dokumentieren, dass wir ihren exakten Zustand für jeden einzelnen Stichtag historisch korrekt abfragen können.

Erstellung des Links und des Effectivity Satellites

Der erste Schritt zur Erfassung dieser Beziehungen besteht darin, eine Link-Tabelle zu erstellen, die eine eindeutige (distinct) Liste aller Beziehungen zwischen den Business Objects enthält. Links sollten keine zusätzlichen Metadaten wie etwa Gültigkeitszeiträume enthalten, da dies spätere Abfragen unnötig verkompliziert und die Abfrage-Performance beeinträchtigen kann. In unserem Beispiel erfasst die Link-Tabelle jede eindeutige Kombination von A- und B-Keys, speichert jedoch weder Start- noch Enddaten.

Als Nächstes erstellen wir einen Effectivity Satellite. Diese Tabelle erweitert den Link, indem sie Beginn und Ende jeder Beziehung über Zeitstempel sowie ein „is_active“-Flag speichert, um den jeweiligen Status jeder Beziehung anzuzeigen. Mithilfe dieser Tabelle lässt sich lückenlos nachvollziehen, wann eine Beziehung beginnt, sich ändert oder endet. In der Praxis stellt sich das wie folgt dar:

  • Einträge an Tag 1: Alle Beziehungen (B1-A1, B2-A2, B3-A3) sind als aktiv gekennzeichnet.
  • Einträge an Tag 2: Neue Beziehungen (B1-A2 und B2-A1) kommen hinzu und werden als aktiv markiert, während vorherige Beziehungen (B1-A1 und B2-A2) auf inaktiv gesetzt werden. B3-A3 entfällt vollständig.

Aufbau der snapshot-basierten Bridge Table

Sobald der Effectivity Satellite eingerichtet ist, können wir eine Bridge Table aufbauen, die die aktiven Beziehungen für jeden Tag in Form eines Snapshots festhält. Diese Tabelle liefert eine Point-in-Time-Sicht auf die Beziehungen genau so, wie sie an einem bestimmten Tag bestanden haben. Sehen wir uns den Aufbau der Bridge Table an:

Snapshot für Tag 1

Der Snapshot für Tag 1 spiegelt die Ausgangsbeziehungen wider und übernimmt alle zu diesem Zeitpunkt aktiven Datensätze aus dem Effectivity Satellite. An Tag 1 sind B1-A1, B2-A2 und B3-A3 durchgängig aktiv.

Snapshot für Tag 2

Im Snapshot für Tag 2 verbleiben lediglich die Beziehungen B1-A2 und B2-A1 als aktiv, während B3-A3 nicht mehr berücksichtigt wird. Durch die Filterung auf ausschließlich aktive Einträge bildet der Snapshot den Zustand an Tag 2 exakt ab.

Snapshot für Tag 3

Der Snapshot für Tag 3 ist identisch mit dem von Tag 2, da keine weiteren Änderungen erfolgt sind. Die aktiven Beziehungen B1-A2 und B2-A1 bleiben unverändert bestehen.

Dieses Vorgehen gewährleistet einen transparenten Audit-Trail über sämtliche Beziehungsänderungen und -löschungen. Der tägliche Snapshot gibt den jeweiligen Status quo präzise wieder, ohne redundante Daten zu erzeugen.

Umgang mit fehlenden Daten und Wiederherstellung von Beziehungen

Eine zentrale Stärke des Effectivity Satellites liegt in der Fähigkeit, reaktivierte Beziehungen sauber abzubilden. Wird beispielsweise die Beziehung B1-A1 an Tag 4 wiederhergestellt, fügen wir im Effectivity Satellite neue Zeilen hinzu, markieren die zuvor aktive Kombination (B1-A2) als inaktiv und aktivieren B1-A1 erneut. Diese dynamische Struktur federt das Entstehen, Wegfallen und Wiederauftreten von Beziehungen im Zeitverlauf flexibel ab.

Einbindung von A3 in die Bridge Table an Tag 2

Eine typische Herausforderung besteht darin, Business Objects wie A3 an Tag 2 einzubinden, obwohl an diesem Tag keine Beziehung zu einem Objekt in B vorliegt. Im Data-Vault-Umfeld wird dies üblicherweise in nachgelagerten Abfragen oder Joins auf Reporting-Ebene gelöst – und nicht direkt in der Bridge Table.

Wenn Sie von Objekt A ausgehen und einen Left Join auf die Bridge Table durchführen, beziehen Sie sämtliche Datensätze aus A ein – selbst diejenigen ohne Entsprechung in B. Dadurch ist sichergestellt, dass nicht verknüpfte Objekte in den Ergebnissen erscheinen, wobei die zugehörigen B-Attribute als NULL oder optional über einen definierten Platzhalter abgebildet werden.

Vermeidung kartesischer Produkte und weitere Best Practices

Beim Einsatz einer Bridge Table gilt es unbedingt zu verhindern, dass unerwünschte kartesische Produkte entstehen, da diese das Datenvolumen bei Aggregationen massiv aufblähen können. Prüfen Sie daher stets die Kardinalität der Beziehungen (z. B. 1:1 oder n:m), um sicherzustellen, dass Joins ausschließlich über die erforderlichen Keys ausgeführt werden. Der Driving Key, der die Beziehungen in der Link-Tabelle verankert, muss dabei im Mittelpunkt stehen – insbesondere bei n:m-Beziehungen.

Diese Best Practice garantiert höchste Präzision sowie optimale Performance bei der Datenaggregation und schützt vor verfälschten Reporting-Ergebnissen.

Fazit

Snapshot-basierte Bridge Tables sind in der Data-Vault-Modellierung ein leistungsfähiges Instrument, um veränderliche Beziehungen zu steuern und historische Snapshots nachvollziehbar festzuhalten. Durch das strukturierte Zusammenspiel von Links, Effectivity Satellites und Bridge Tables schaffen wir einen verlässlichen, auditierbaren Pfad für alle Datenänderungen im Zeitverlauf. Wie gezeigt, ermöglicht uns dieser Ansatz, Datenlücken zu überbrücken, Beziehungen zu reaktivieren und eine künstliche Datenaufblähung zu verhindern. Das Ergebnis sind performante und stabile Datenmodelle.

Wenn Sie Unterstützung bei Vorlagen für Bridge Tables oder Effectivity Satellites wünschen, können Sie sich jederzeit gerne an mich wenden. Ich hoffe, dass diese Erläuterung wertvolle Klarheit über den Einsatz von Bridge Tables in Data Vault geschaffen hat. Seien Sie auch beim nächsten Mal wieder dabei, wenn wir neue Einblicke teilen, und reichen Sie Ihre Fragen gerne vorab ein!